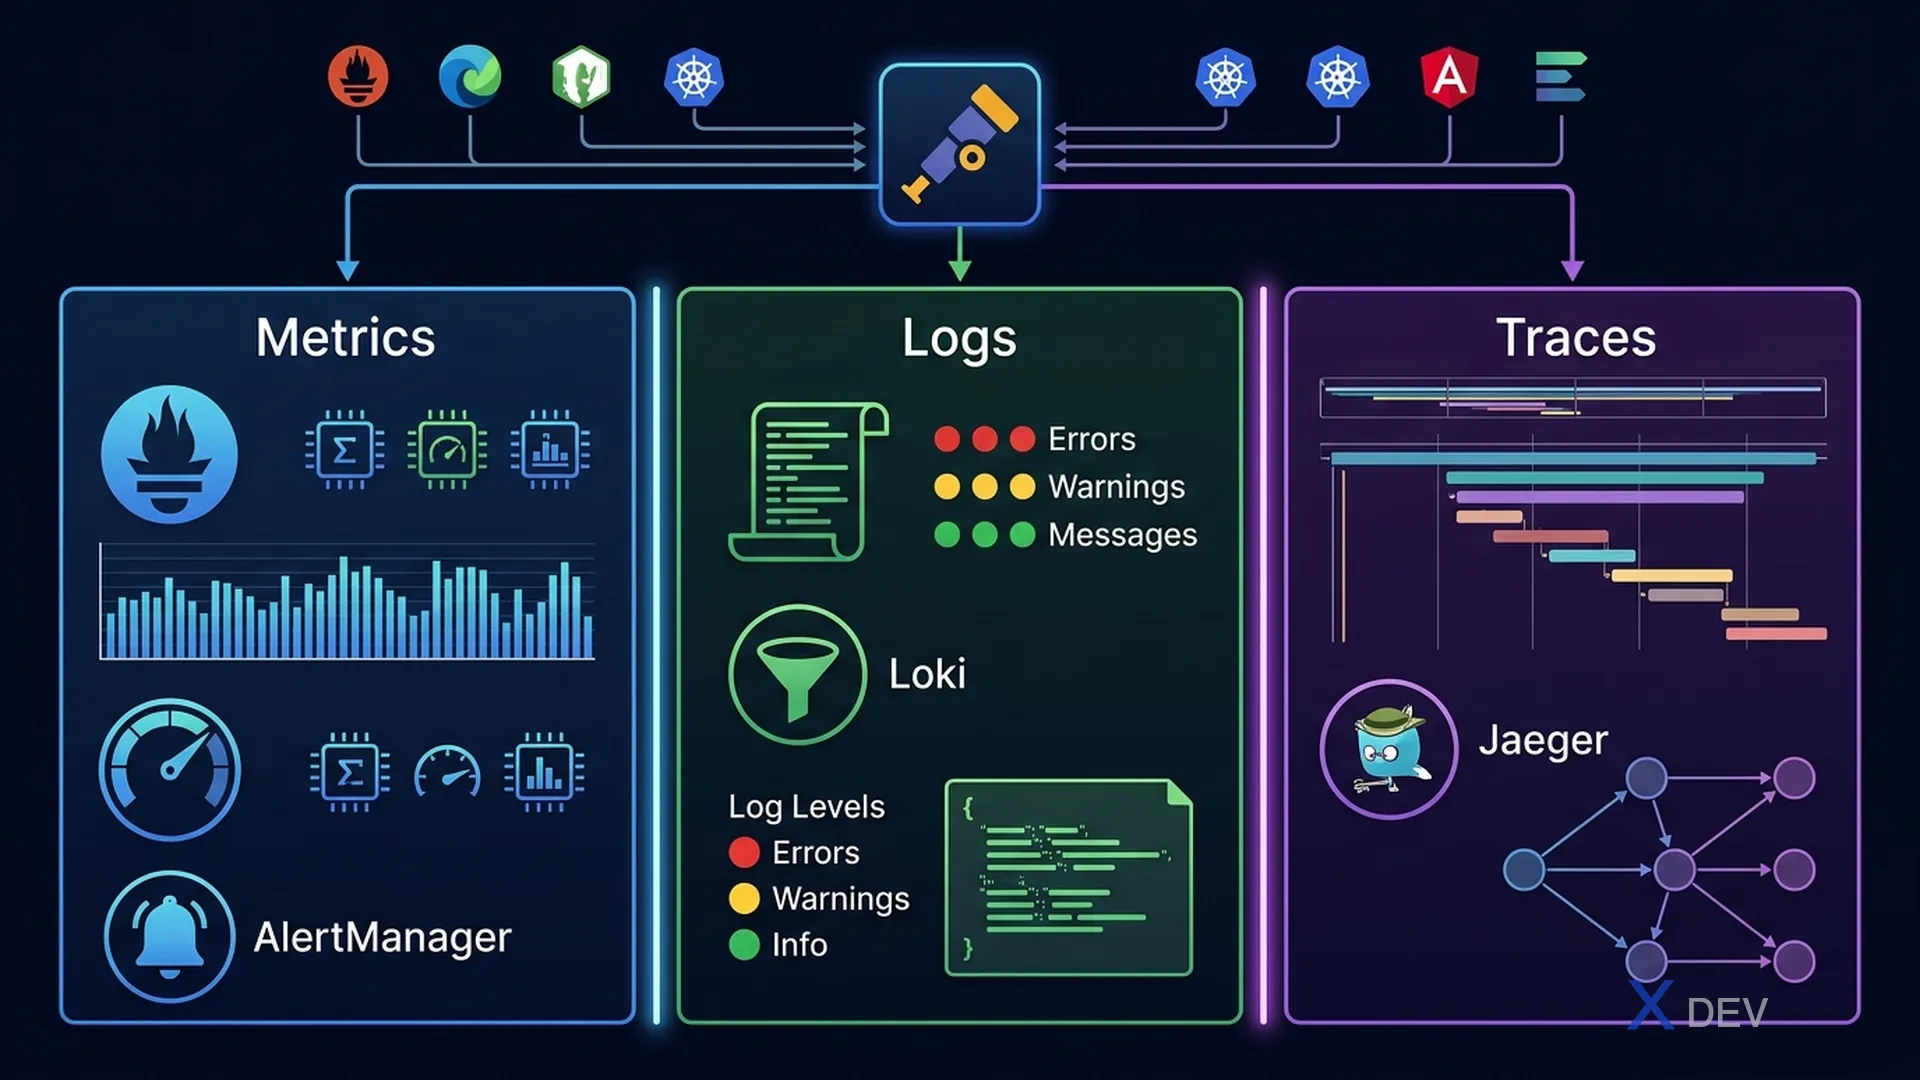
1. 可觀測性三大支柱
可觀測性是透過外部訊號了解系統內部狀態的能力,包含 3 個支柱:
| 支柱 | 是什麼 | 回答的問題 | 工具 |
|---|---|---|---|
| Metrics | 隨時間彙總的數值資料 | 「系統目前處於什麼狀態?」 | Prometheus + Grafana |
| Logs | 各服務的文字事件記錄 | 「發生了什麼事?」 | Loki、Elasticsearch、Fluentd |
| Traces | 跨多個服務的請求流程 | 「請求經過哪裡?花了多長時間?」 | Jaeger、Zipkin、Tempo |
User request fails → Use 3 pillars:

  METRICS: CPU spike at 14:05?
  LOGS: Error "DB timeout" in service B
  TRACES: Request A→B→C, step B took 8s

  → Root cause: Service B DB connection pool exhausted
考試重點: KCNA 經常考「哪個工具」對應哪個支柱。Prometheus = metrics。Grafana = 視覺化。Jaeger = 分散式追蹤。Loki = 日誌聚合。
2. Prometheus 與 Metrics
Prometheus 是 CNCF graduated 專案,用於監控和告警。Pull-based 模式:Prometheus 從目標抓取指標。
Prometheus Architecture:
  App (exposes /metrics)
       ↑ scrape
  Prometheus Server ──► Alert Manager ──► Slack/PagerDuty
       │
Grafana (query PromQL → charts)| 指標類型 | 含義 | 範例 |
|---|---|---|
| Counter | 僅遞增(重啟時重置) | http_requests_total |
| Gauge | 自由升降 | memory_usage_bytes |
| Histogram | 分佈、分位數 | request_duration_seconds |
| Summary | 預先計算的分位數 | response_size_summary |
3. OpenTelemetry(OTel)
OpenTelemetry 是 CNCF 標準,用於收集遙測資料(metrics、logs、traces),提供廠商中立的 SDK 和 Collector。
OpenTelemetry Flow:
  App (instrumented with OTel SDK)
       │ OTLP (protocol)
  OTel Collector (receive, process, export)
       │
  ┌────┴────┐
 Jaeger   Prometheus   Loki
(traces)  (metrics)   (logs)
考試重點: OpenTelemetry 將廠商特定程式碼從應用中分離——只需更改 OTel Collector 設定即可從 Jaeger 切換到 Zipkin,無需修改應用程式碼。
4. Kubernetes 中的可觀測性
| 元件 | 提供功能 |
|---|---|
| kubelet /metrics | 提供節點資源指標給 Prometheus |
| metrics-server | 提供 CPU/Memory 給 kubectl top、HPA |
| kube-state-metrics | Kubernetes 物件狀態(Pod、Deployment 狀態) |
| Prometheus Operator | 使用 CRD(ServiceMonitor)部署 Prometheus 堆疊 |
| Loki + Promtail | 日誌聚合(Promtail 從節點收集日誌) |
kubectl 除錯命令
kubectl logs pod-name              # Current container logs
kubectl logs pod-name --previous   # Last crashed container logs
kubectl logs -f pod-name           # Stream live logs
kubectl describe pod pod-name      # Events + status details
kubectl top pod                    # CPU/Memory (needs metrics-server)
kubectl top node                   # Node resource usage
5. 速查表
| 考試問題 | 答案 |
|---|---|
| 可觀測性的 3 個支柱? | Metrics、Logs、Traces |
| 分散式追蹤工具? | Jaeger、Zipkin、Tempo |
| Kubernetes 指標收集? | Prometheus |
| 視覺化儀表板? | Grafana |
| 廠商中立的遙測標準? | OpenTelemetry |
| kubectl top 需要什麼? | metrics-server |
6. 練習題
Q1: 團隊需要追蹤單一 HTTP 請求如何流經 5 個微服務,以找出哪個服務增加最多延遲。應使用哪個可觀測性工具?
- A) Prometheus
- B) Grafana
- C) Jaeger ✓
- D) Loki
解析:分散式追蹤(Jaeger、Zipkin)追蹤請求跨多個服務的完整流程,顯示每一跳的延遲和關係。Prometheus 顯示聚合指標;Loki 顯示日誌;Grafana 用於視覺化。
Q2: 要追蹤自啟動以來服務處理的 HTTP 請求總數,應使用哪種 Prometheus 指標類型?
- A) Gauge
- B) Histogram
- C) Counter ✓
- D) Summary
解析:Counter 是單調遞增的指標——只會上升(或在重啟時重置為 0)。非常適合追蹤累計事件如請求數、錯誤數或傳輸位元組。Gauge 用於會升降的值(如記憶體使用量)。
Q3: 哪個框架讓開發者只需一次儀器化即可將遙測資料匯出到多個後端(Jaeger、Prometheus 等),無需修改程式碼?
- A) Prometheus client libraries
- B) OpenTelemetry ✓
- C) Kubernetes metrics-server
- D) Grafana Agent
解析:OpenTelemetry 提供廠商中立的 API 和 SDK 來產生 traces、metrics 和 logs。OTel Collector 將遙測資料路由到不同後端。切換後端只需更改 Collector 設定,無需修改應用程式碼。