2026年4月16日、AnthropicはClaude Opus 4.7を正式リリースしました——複雑なプログラミングタスク・長時間のエージェントワークフロー・高解像度画像処理のために特別設計された最新フラッグシップAIモデルです。これは単なる定期アップデートではなく、世界中の主要テクノロジー企業による多数のベンチマークと実際のフィードバックで実証された、Opus 4.6からの大幅な飛躍です。
本記事では、Claude Opus 4.7について知っておくべきすべてを分析します:強み・ベンチマーク・価格・Opus 4.6からの移行ガイド。
1. Claude Opus 4.7とは?

Claude Opus 4.7はClaude 4シリーズ最新のフラッグシップモデルで、Anthropicが以下の用途に最適なモデルとして位置づけています:
- 高度なソフトウェアエンジニアリング——特に深い推論を必要とする難しいタスク
- 長時間のエージェントワークフロー——CI/CDオートメーション・リサーチエージェント・マルチステップタスク
- マルチモーダル——高解像度画像の読み取りと分析
- 専門業務——財務分析・法的文書・複雑なドキュメント
Anthropicは、Opus 4.7が複雑で長期にわたるタスクを厳密かつ一貫性を持って処理し、指示に忠実に従いながらも、報告前に自分の出力を検証する方法を独自に考案できると述べています。
Claude MythosPreview——Anthropicが訓練した最も強力なモデル——ほど万能ではありませんが、Opus 4.7は重要なベンチマークの範囲でOpus 4.6を上回ります。
2. ベンチマークとパフォーマンス
2.1 Opus 4.6および競合との総合比較
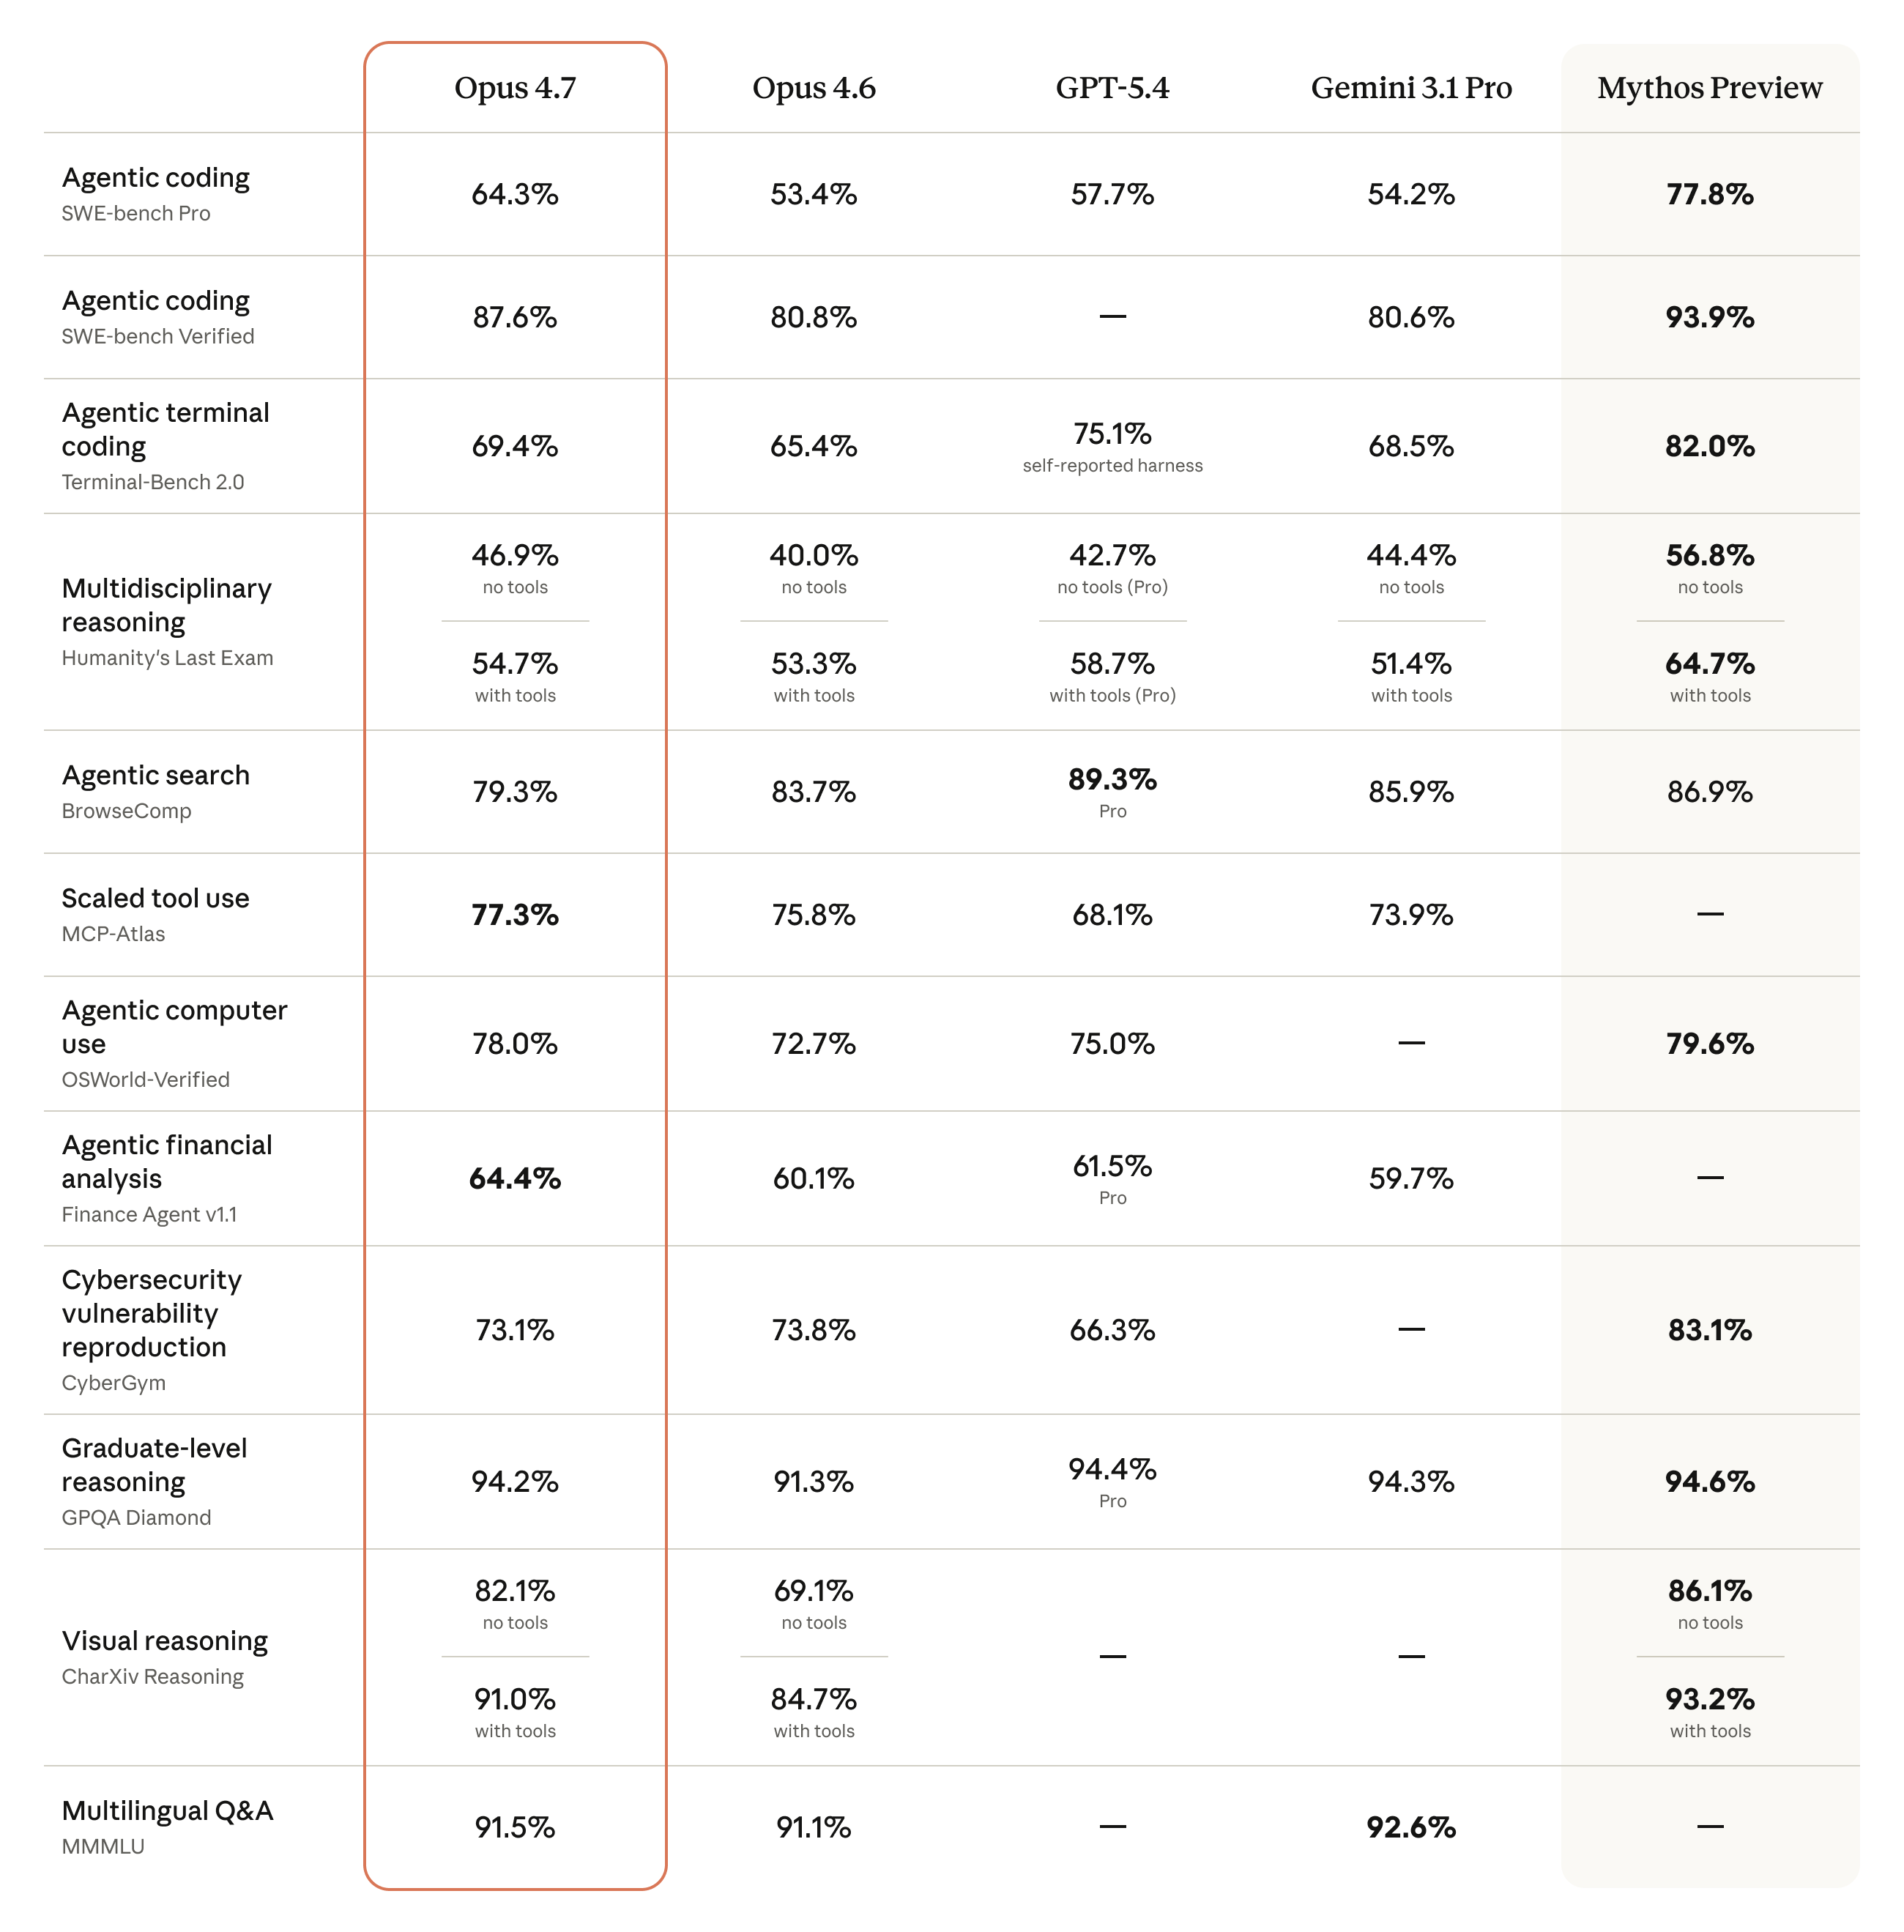
AnthropicはOpus 4.7をOpus 4.6・GPT-5.4・Gemini 3.1 Proと複数のドメインで比較しました:
| ベンチマーク | Opus 4.7 | Opus 4.6 | 改善 |
|---|---|---|---|
| SWE-bench Verified | 最高水準 | ベースライン | +大幅改善 |
| CursorBench | 70% | 58% | +12% |
| BigLaw Bench(高エフォート) | 90.9% | — | 最強 |
| Rakuten-SWE-Bench | 3倍のタスク数 | ベースライン | 3× |
| GDPval-AA(財務・法律) | 最先端 | — | 最上位 |
| Finance Agent Eval | 最先端 | 0.767 | 0.813 |
| Visual Acuity(XBOW) | 98.5% | 54.5% | +44% |
| 一般コーディング(93タスク) | +13% | ベースライン | +13% |
2.2 ドメイン別評価
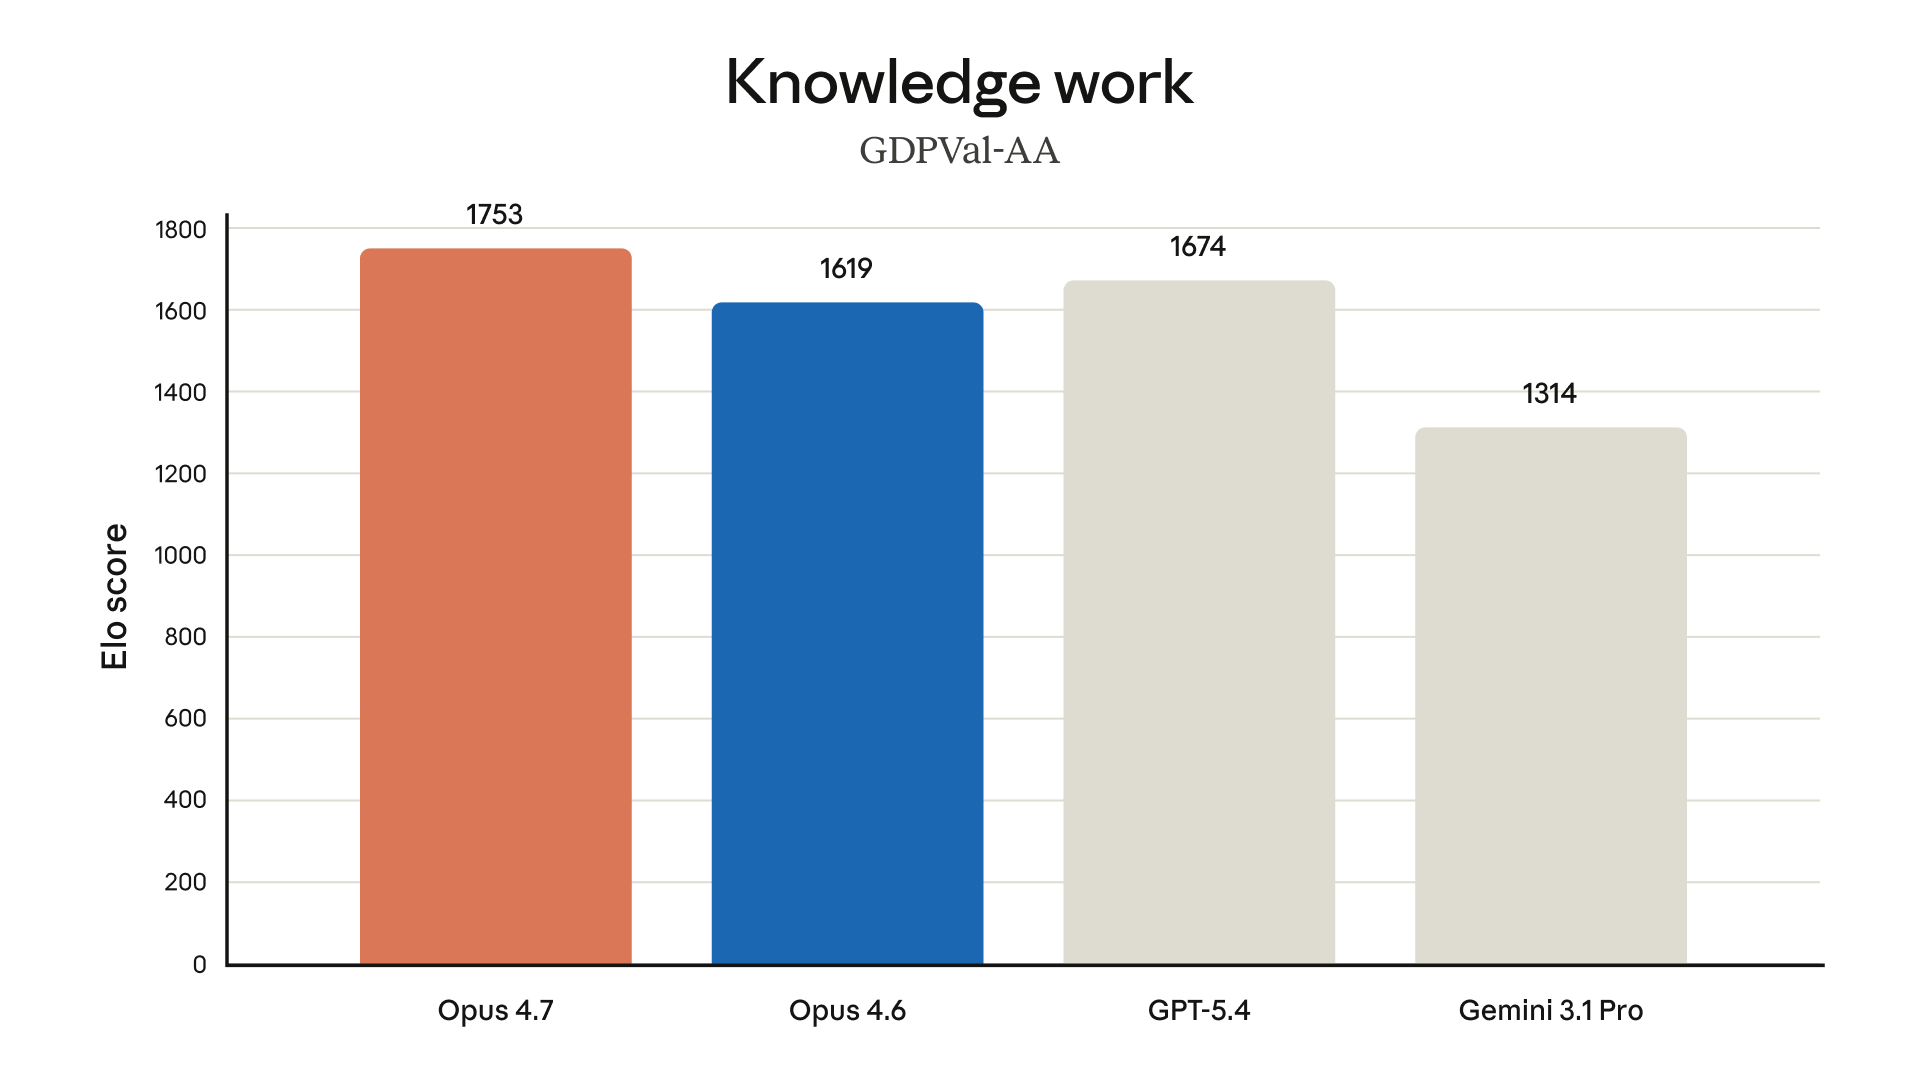
Anthropicの内部テストでは、Opus 4.7が以下の領域で大幅に改善されていることが示されています:
- オフィス作業(PowerPoint・Excel・ドキュメント作成)
- ビジョン(画像認識と分析)
- ドキュメント推論(Databricks比でOpus 4.6より21%少ないエラー)
- 長コンテキスト推論(長いコンテンツを通じた一貫した推論)
- 生物学(ライフサイエンスアプリケーション)
- 長期的な一貫性(マルチステップタスクでの整合性)
- コーディング(プログラミング・デバッグ・コードレビュー)
3. コアの改善点
3.1 視覚解像度が3倍以上に向上
これは最も重要なアップグレードの一つです。Opus 4.7は長辺2,576ピクセル(約375万ピクセル)までの画像を処理できます——これは以前のClaudeモデルの3倍以上です。
これにより、以下のユースケースが新たに解放されます:
- 情報密度の高いスクリーンショットを読むコンピューター使用エージェント
- 複雑な技術チャートからのデータ抽出
- ライフサイエンス——化学構造・工学図面・特許ファイルの読み取り
- ピクセル精度のリファレンスを必要とする作業
注: これはモデルレベルの変更であり、APIパラメータではありません。モデルに送信された画像はより高い解像度で処理されるため、より多くのトークンを消費します。高い詳細度が必要でない場合は、送信前に画像をダウンサンプリングすることをお勧めします。
3.2 優れた指示への従順性
Opus 4.7は指示への従順性を大幅に改善しています。Anthropicはこれが双方向の変化であることを警告しています:
- 良い点: モデルがより正確に指示に従い、スキップしたり緩く解釈したりしない
- 注意点: Opus 4.6向けに書かれたプロンプトは、Opus 4.7がより文字通りに解釈するため、予期しない結果を生む可能性がある
→ 推奨: 4.7に移行する際は、プロンプトとハーネスを再調整してください。
3.3 より優れた長期記憶
Opus 4.7はファイルシステムベースのメモリをより効果的に活用します。モデルは:
- 複数の長いセッションにわたって重要なメモを記憶する
- 新しいタスクを続けるために完全なコンテキストを再提供せずに記憶を使用する
これは複数日にわたるエージェントワークフローにとって重要な改善です。
3.4 新エフォートレベル:xhigh
Opus 4.7は**xhigh**(超高)エフォートレベルを導入しました——highとmaxの間に位置します。これにより、以下のバランスをより細かく制御できます:
- 推論の深さ
- レイテンシ
- トークンコスト
Claude Codeでは、Anthropicはすべてのプランのデフォルトエフォートレベルをxhighに引き上げました。Opus 4.7をコーディングやエージェントのユースケースでテストする際は、highまたはxhighから始めることをお勧めします。
4. 実際のフィードバック:企業各社の声
Anthropicはアーリーアクセス期間中に20社以上の主要テクノロジー企業からフィードバックを収集しました。ハイライトは以下の通りです:
4.1 コーディング・エンジニアリング
Cursor(CursorBench:Opus 4.6の58%に対して70%):
「Claude Opus 4.7は大幅な能力向上です。特に自律性とより創造的な推論において」 — Michael Truell, Co-Founder & CEO
Replit:
「Opus 4.7は容易なアップグレード決定です。より低いコストで同等の品質——ログ分析・バグ発見・修正提案においてより効率的で精確です。技術的な議論でプッシュバックし、より良い決断を促します。本当に優れた同僚のような感覚です」 — Michele Catasta, President
Warp(Terminal Bench):
「Opus 4.7は以前のClaudeモデルがクリアできなかったTerminal Benchのタスクをクリアし、Opus 4.6が解決できなかった複雑な並行性バグを解決しました」 — Zach Lloyd, Founder & CEO
Bolt:
「長期アプリケーション構築タスクでOpus 4.6より10%優れており、リグレッションなし——エージェントモデルでは稀なことです」 — Eric Simons, CEO & Founder
Rakuten:
「Claude Opus 4.7はOpus 4.6の3倍の本番タスクを解決し、コード品質とテスト品質で二桁の成長を達成しました」 — Yusuke Kaji, GM AI for Business
4.2 エージェント・長期タスク
Devin(Cognition):
「Claude Opus 4.7はDevinで長期自律性を新しいレベルに引き上げます。何時間も一貫して作業し、難しい問題を諦めず、以前は安定して実行できなかった深い調査作業のクラスを解放します」 — Scott Wu, CEO
Notion:
「より少ないトークンと3分の1のツールエラーでOpus 4.6より14%向上。以前にOpusを止めたツール障害を通じて実行を継続する、暗黙的なニーズテストをパスした最初のモデル」 — Sarah Sachs, AI Lead
Factory:
「タスク成功が10〜15%向上し、ツールエラーが減少し、検証ステップの確実なフォローアップが実現。途中で止まるのではなく、仕事を仕上げます」 — Leo Tchourakov, MTS
4.3 財務・法律
Ramp:
「エージェントチームワークフローで強化:役割の忠実度・指示への従順・調整・複雑な推論が向上。段階的なガイダンスがはるかに少なくて済みます」 — Austin Ray, Software Engineer
Harvey(BigLaw Bench:90.9%精度):
「BigLaw Benchで最も強力な実質的精度。以前のフロンティアモデルが困難とした業務——契約変更条項の割り当て条項とコントロール変更条項の正確な区別——を達成しました」 — Niko Grupen, Head of Applied Research
Databricks:
「ソース情報を扱う際、Opus 4.6より21%少ないエラー。エンタープライズドキュメント分析に最適なClaudeモデルです」 — Hanlin Tang, CTO Neural Networks
4.4 ビジョン・マルチモーダル
Solve Intelligence(ライフサイエンス特許):
「マルチモーダル理解の大幅な改善:化学構造の読み取り・複雑な工学図の分析。高解像度サポートにより、ライフサイエンス特許ワークフローに最高水準のツールを構築できます」 — Sanj Ahilan, CRO
XBOW(ペネトレーションテスト——視覚精度:98.5% vs 54.5%):
「Opus 4.6の54.5%に対して視覚精度ベンチマークで98.5%を達成。コンピューター使用の最大のペインポイントが解消され、以前は使用できなかった作業のクラス全体が解放されました」 — Oege de Moor, CEO
5. 安全性とアライメント
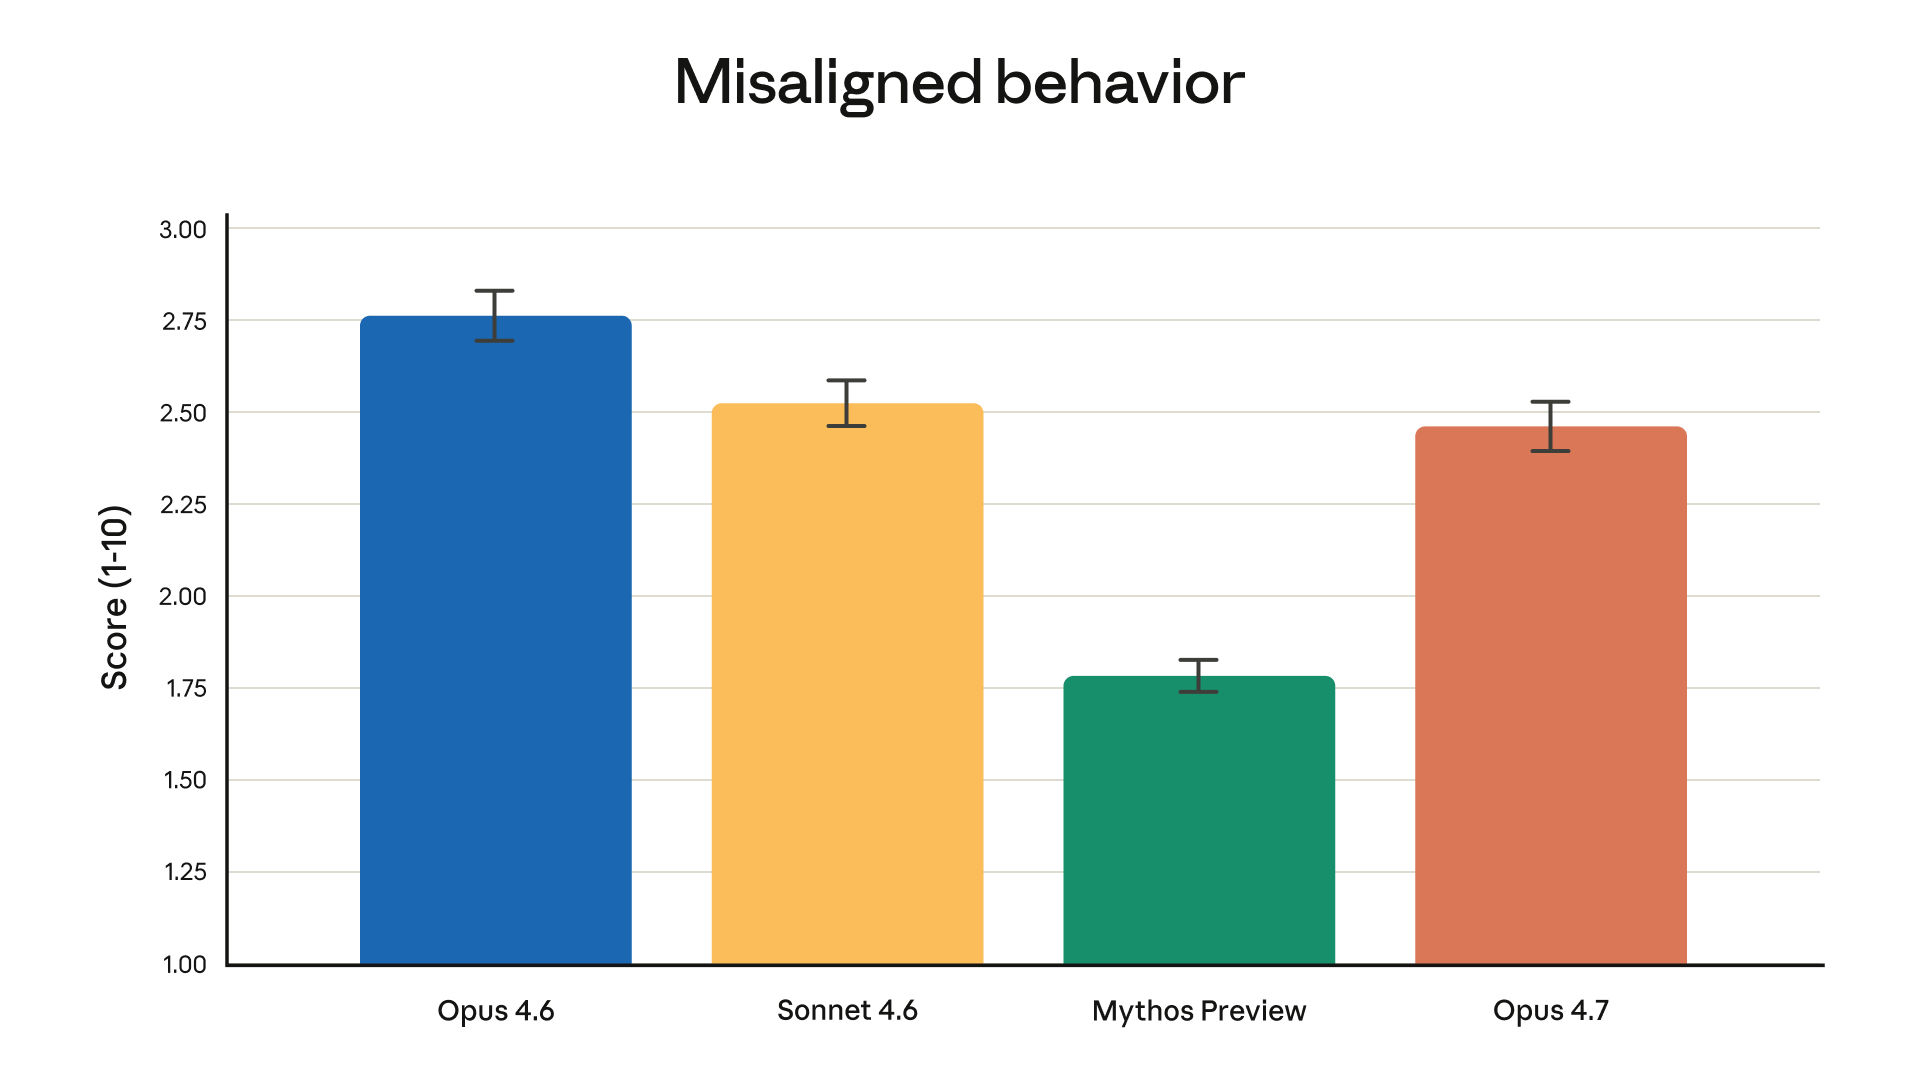
Opus 4.7はOpus 4.6と類似した安全性プロファイルを持ちます:
4.6からの改善:
- 誠実性(より真実性が高い)
- プロンプトインジェクション攻撃への耐性
軽微な弱点:
- 違法薬物に関して過度に詳細なハームリダクションアドバイスを提供することがある
Anthropicはモデルを*「概ね整合性が取れており信頼できるが、行動が完全に理想的ではない」*と結論付けています。Mythos PreviewはAnthropicの評価で最も整合性の取れたモデルです。
サイバーセキュリティのセーフガード
Opus 4.7は、禁止または高リスクのサイバーセキュリティ活動に関連するリクエストを検出・ブロックする自動化されたセーフガードを装備した最初のモデルです。Anthropicはこれがメンタルクラスのモデルの最終的な広範公開のための基礎作りであると説明しています。
正当なサイバーセキュリティ作業(脆弱性研究・ペンテスト・レッドチーム)にOpus 4.7を使用したいセキュリティ専門家は、**Cyber Verification Program**に申し込むことができます。
6. 付随する新機能
6.1 タスクバジェット(パブリックベータ)
Claude Platform(API)の新機能:開発者がClaudeのトークン消費をガイドでき、モデルがより長い実行にわたって作業を優先できます。コスト管理が必要なエージェントワークフローに便利です。
6.2 Claude Codeの/ultrareview
すべてのコード変更を読み通し、徹底したレビュアーが発見するバグとデザイン上の問題にフラグを立てる専用レビューセッションを作成する新スラッシュコマンドです。
- ProとMaxのユーザーは3回の無料ultrareviewを試せる
- AnthropicはすべてのプランでのデフォルトエフォートをClaude Codeで
xhighに引き上げた
6.3 Maxユーザー向けオートモード
オートモードは新しい権限オプション:Claudeがあなたに代わって決定を下し、中断を少なくし、権限のスキップリスクを低減して、より長いタスクを実行できます。
7. 価格と入手可能性
| 詳細 | 情報 |
|---|---|
| 入力価格 | $5 / 100万トークン |
| 出力価格 | $25 / 100万トークン |
| Opus 4.6との比較 | 変更なし |
| APIモデルID | claude-opus-4-7 |
| Claude.ai | ✅ 全プラン |
| Claude API | ✅ 利用可能 |
| Amazon Bedrock | ✅ 利用可能 |
| Google Cloud Vertex AI | ✅ 利用可能 |
| Microsoft Foundry | ✅ 利用可能 |
8. Opus 4.6からの移行:知っておくべきこと
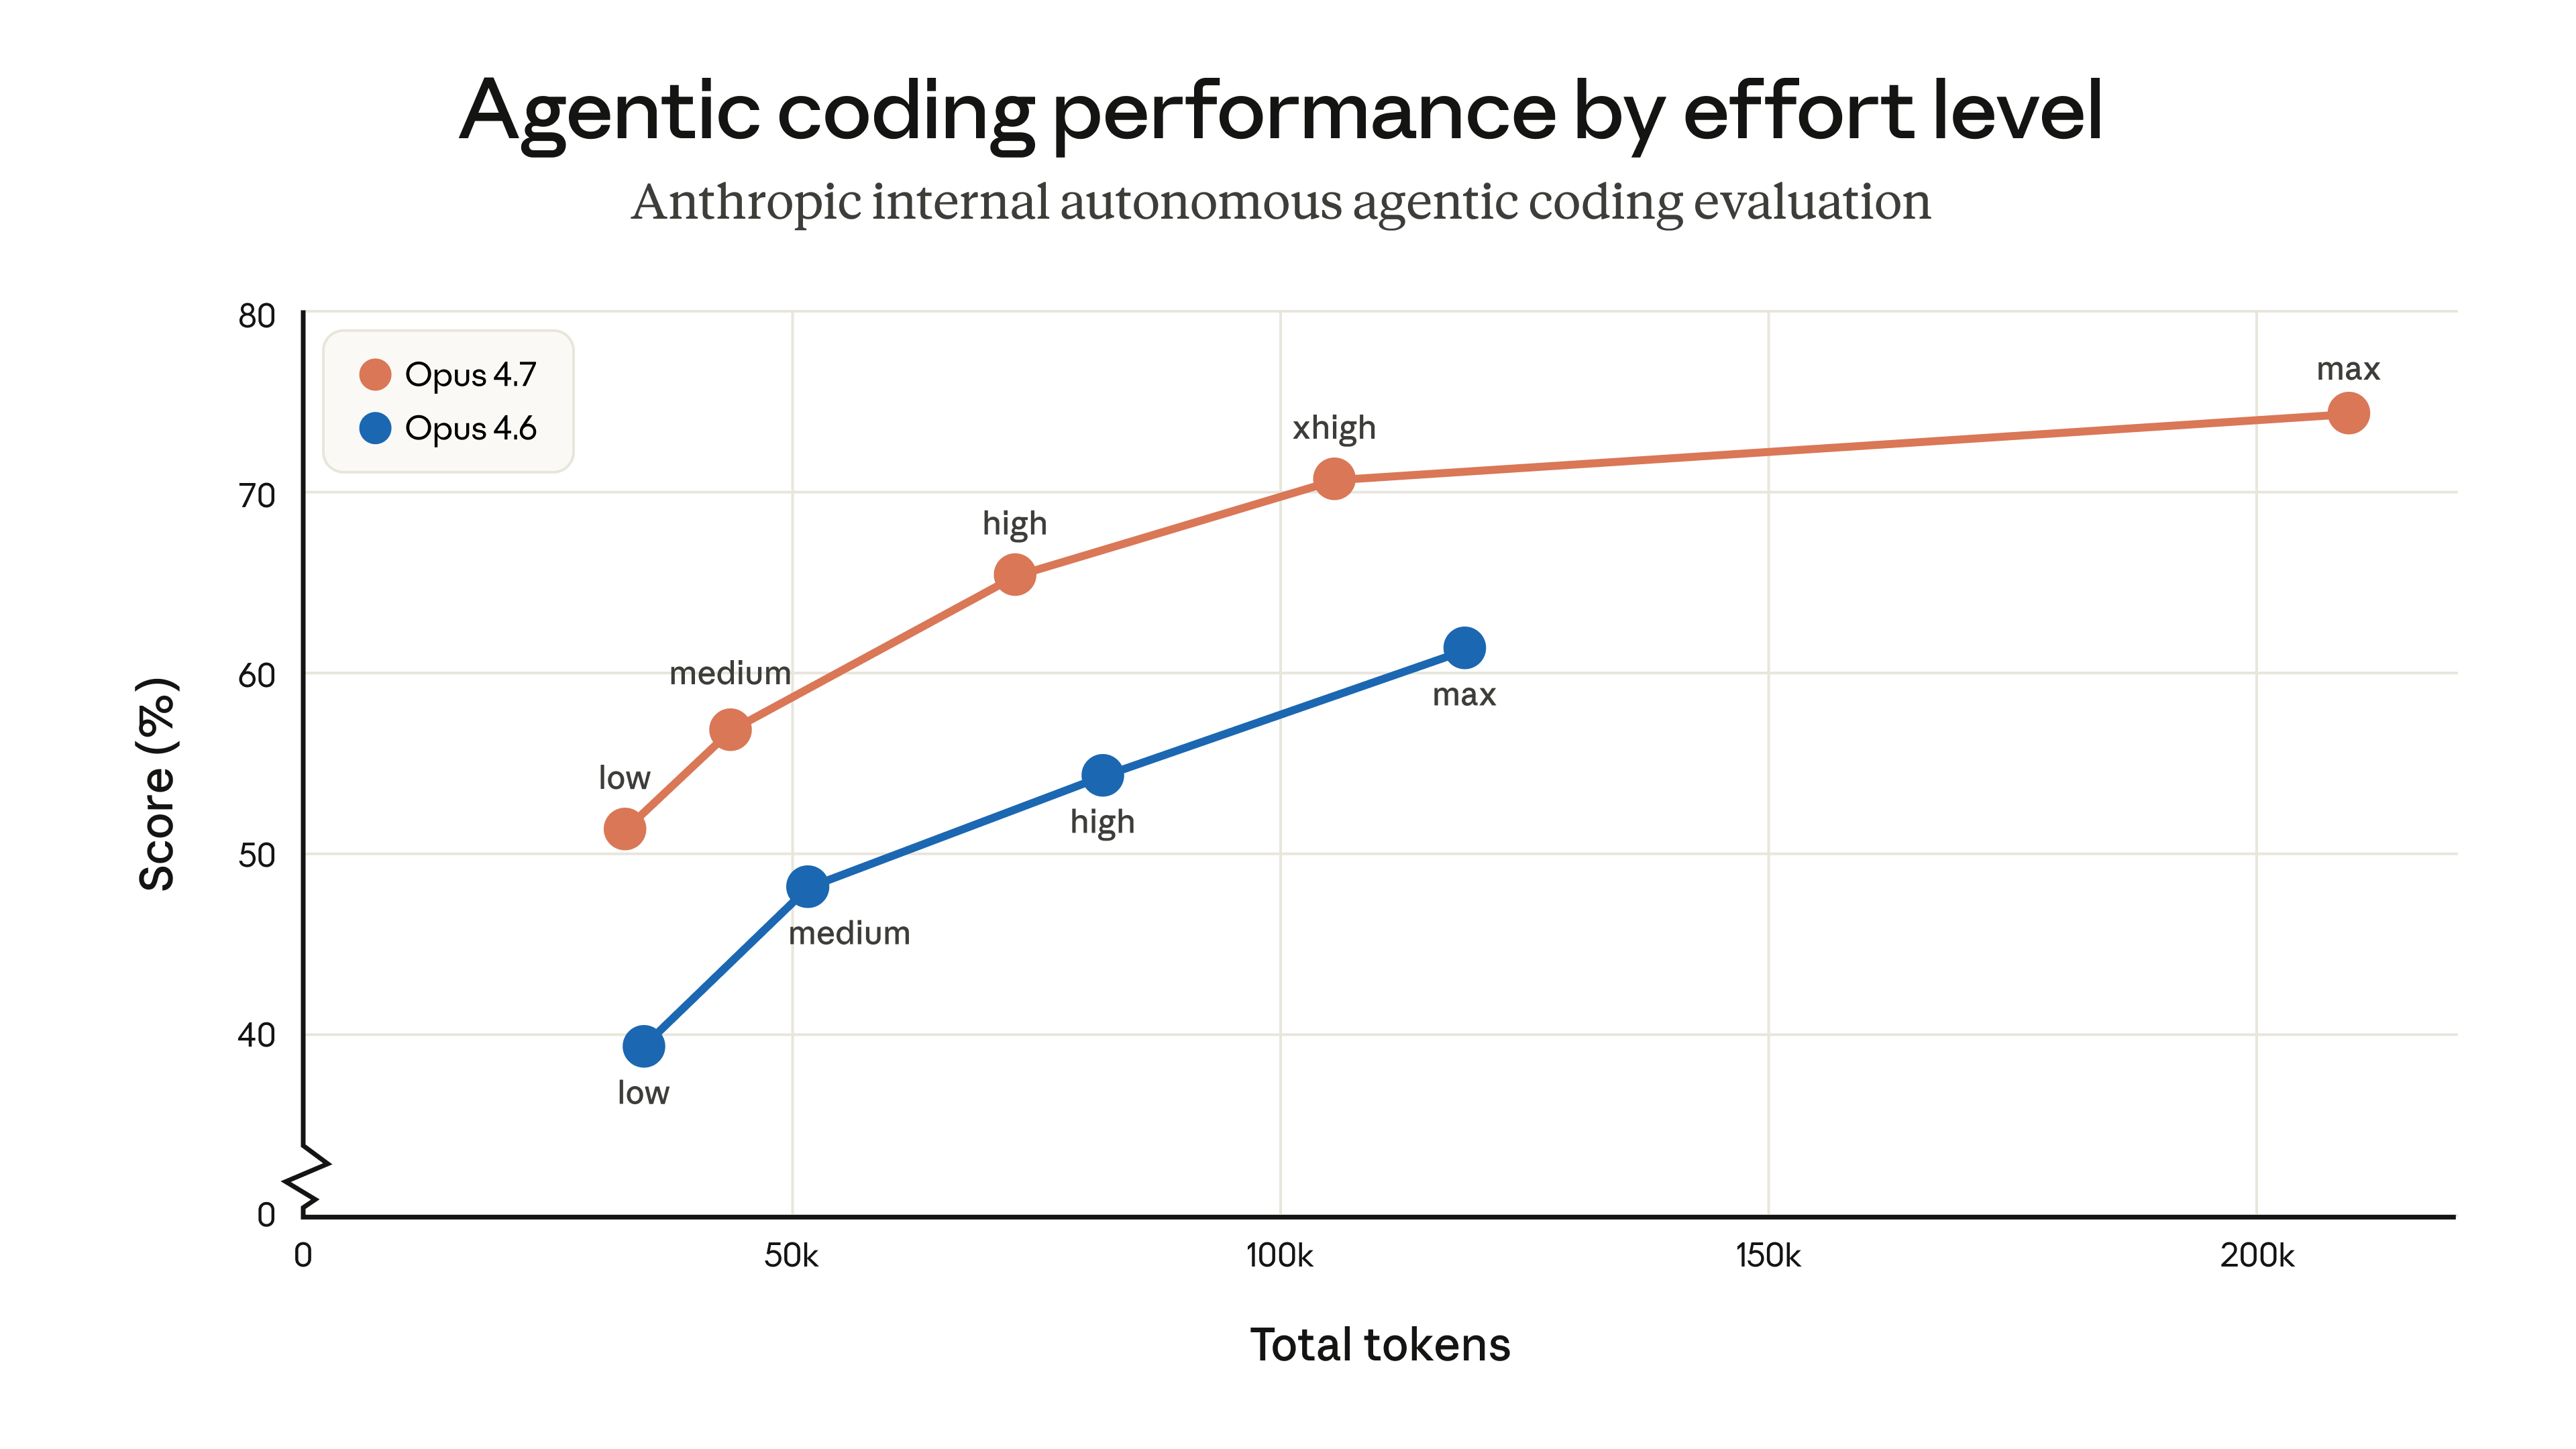
Opus 4.7はOpus 4.6の直接アップグレードですが、計画すべきトークン使用量の2つの変更があります:
8.1 新しいトークナイザー
Opus 4.7はテキストをより効率的に処理する改善されたトークナイザーを使用しています。トレードオフ:同じ入力でもより多くのトークンにマッピングされる場合があります——コンテンツの種類によって約1.0〜1.35倍です。
8.2 高エフォートでのより多い思考量
Opus 4.7は高エフォートレベルで「より多く考え」ます。特にエージェント設定での後のターンで。これにより信頼性が向上しますが、より多くの出力トークンを生成します。
トークン使用量を制御する方法
- エフォートパラメータを使用する(最高精度が不要な場合は
mediumまたはlowに下げる) - タスクバジェットを調整する
- 簡潔さについて明示的にモデルにプロンプトする
実際の結果: 内部コーディング評価では、すべてのエフォートレベルを合わせたトークン使用量はOpus 4.6と比較して改善されています。しかしAnthropicは実際のトラフィックで計測することを推奨しています。
公式移行ガイドを参照してください。
9. 競合との比較
| モデル | 強み | 相対的な弱み |
|---|---|---|
| Claude Opus 4.7 | エージェントコーディング・ビジョン・指示への従順・長期タスク | Mythos Previewほどは万能でない |
| GPT-5.4 | 万能・広いエコシステム | 特定のコーディングベンチマークでOpus 4.7に遅れる |
| Gemini 3.1 Pro | ネイティブマルチモーダル・Google統合 | エージェントコーディングタスクで遅れる |
| Claude Mythos Preview | 最も高性能・最も整合性が取れている | 限定アクセス・サイバーセキュリティセーフガード未完了 |
10. Opus 4.7が最適なタスクは?
✅ 強く推奨
- エージェントコーディング:CI/CDオートメーション・長時間デバッグセッション・コードレビュー
- マルチステップエージェントワークフロー:リサーチエージェント・複雑なオーケストレーション
- ビジョンタスク:情報密度の高いスクリーンショット分析・技術図面・科学ファイル
- ドキュメント分析:法的・財務・エンタープライズドキュメント
- プロフェッショナルコンテンツ:プレゼンテーション・ダッシュボード・レポート生成
⚠️ 代替を検討
- 単純なQ&A:Sonnet 4.6で十分で、はるかに安価
- 大量の単純タスク:Claude Haikuがより経済的
- 絶対的に最も強力なモデルが必要:Mythos Previewの広範公開を待つ
まとめ
Claude Opus 4.7はAnthropicの2026年における真に重要な前進を表しています。市場で最も万能なモデルではありません(その称号はまだMythos Previewが保持しています)が、高度なコーディング・エージェントワークフロー・ビジョンにおいて——Opus 4.7は新しいスタンダードを設定しています。
特に注目すべきは、パフォーマンスが大幅に向上した一方で価格は変わらない(100万トークンあたり$5/$25)という点です。xhighエフォートレベル・タスクバジェット・Claude Codeの/ultrareviewと組み合わせれば——エンジニアリングチームと開発者が今日から真剣に検討すべきツールキットです。
主要出典: Anthropic Blog — Claude Opus 4.7発表(2026年4月16日)| Claude Opus 4.7 System Card | APIドキュメント