2026年4月16日,Anthropic正式發布Claude Opus 4.7——最新旗艦AI模型,專為複雜程式設計任務、長時間代理人工作流程,以及高解析度圖像處理而設計。這不只是例行更新——在全球多家領先科技公司的數十項基準測試與真實使用回饋中,它展示了相較於Opus 4.6的重大躍進。
本文綜合分析Claude Opus 4.7的所有重要資訊:其優勢、基準測試結果、定價,以及從Opus 4.6遷移的指南。
1. Claude Opus 4.7是什麼?

Claude Opus 4.7是Claude 4系列中最新的旗艦模型,Anthropic將其定位為以下場景的最佳選擇:
- 進階軟體工程——尤其是需要深度推理的困難任務
- 長時間代理人工作流程——CI/CD自動化、研究代理人、多步驟任務
- 多模態——讀取並分析高解析度圖像
- 專業工作——財務分析、法律文件、複雜文件處理
Anthropic指出,Opus 4.7在處理複雜、長期任務時具備嚴謹性與一致性,能精確遵循指示,同時在回報之前自行設法驗證自身的輸出。
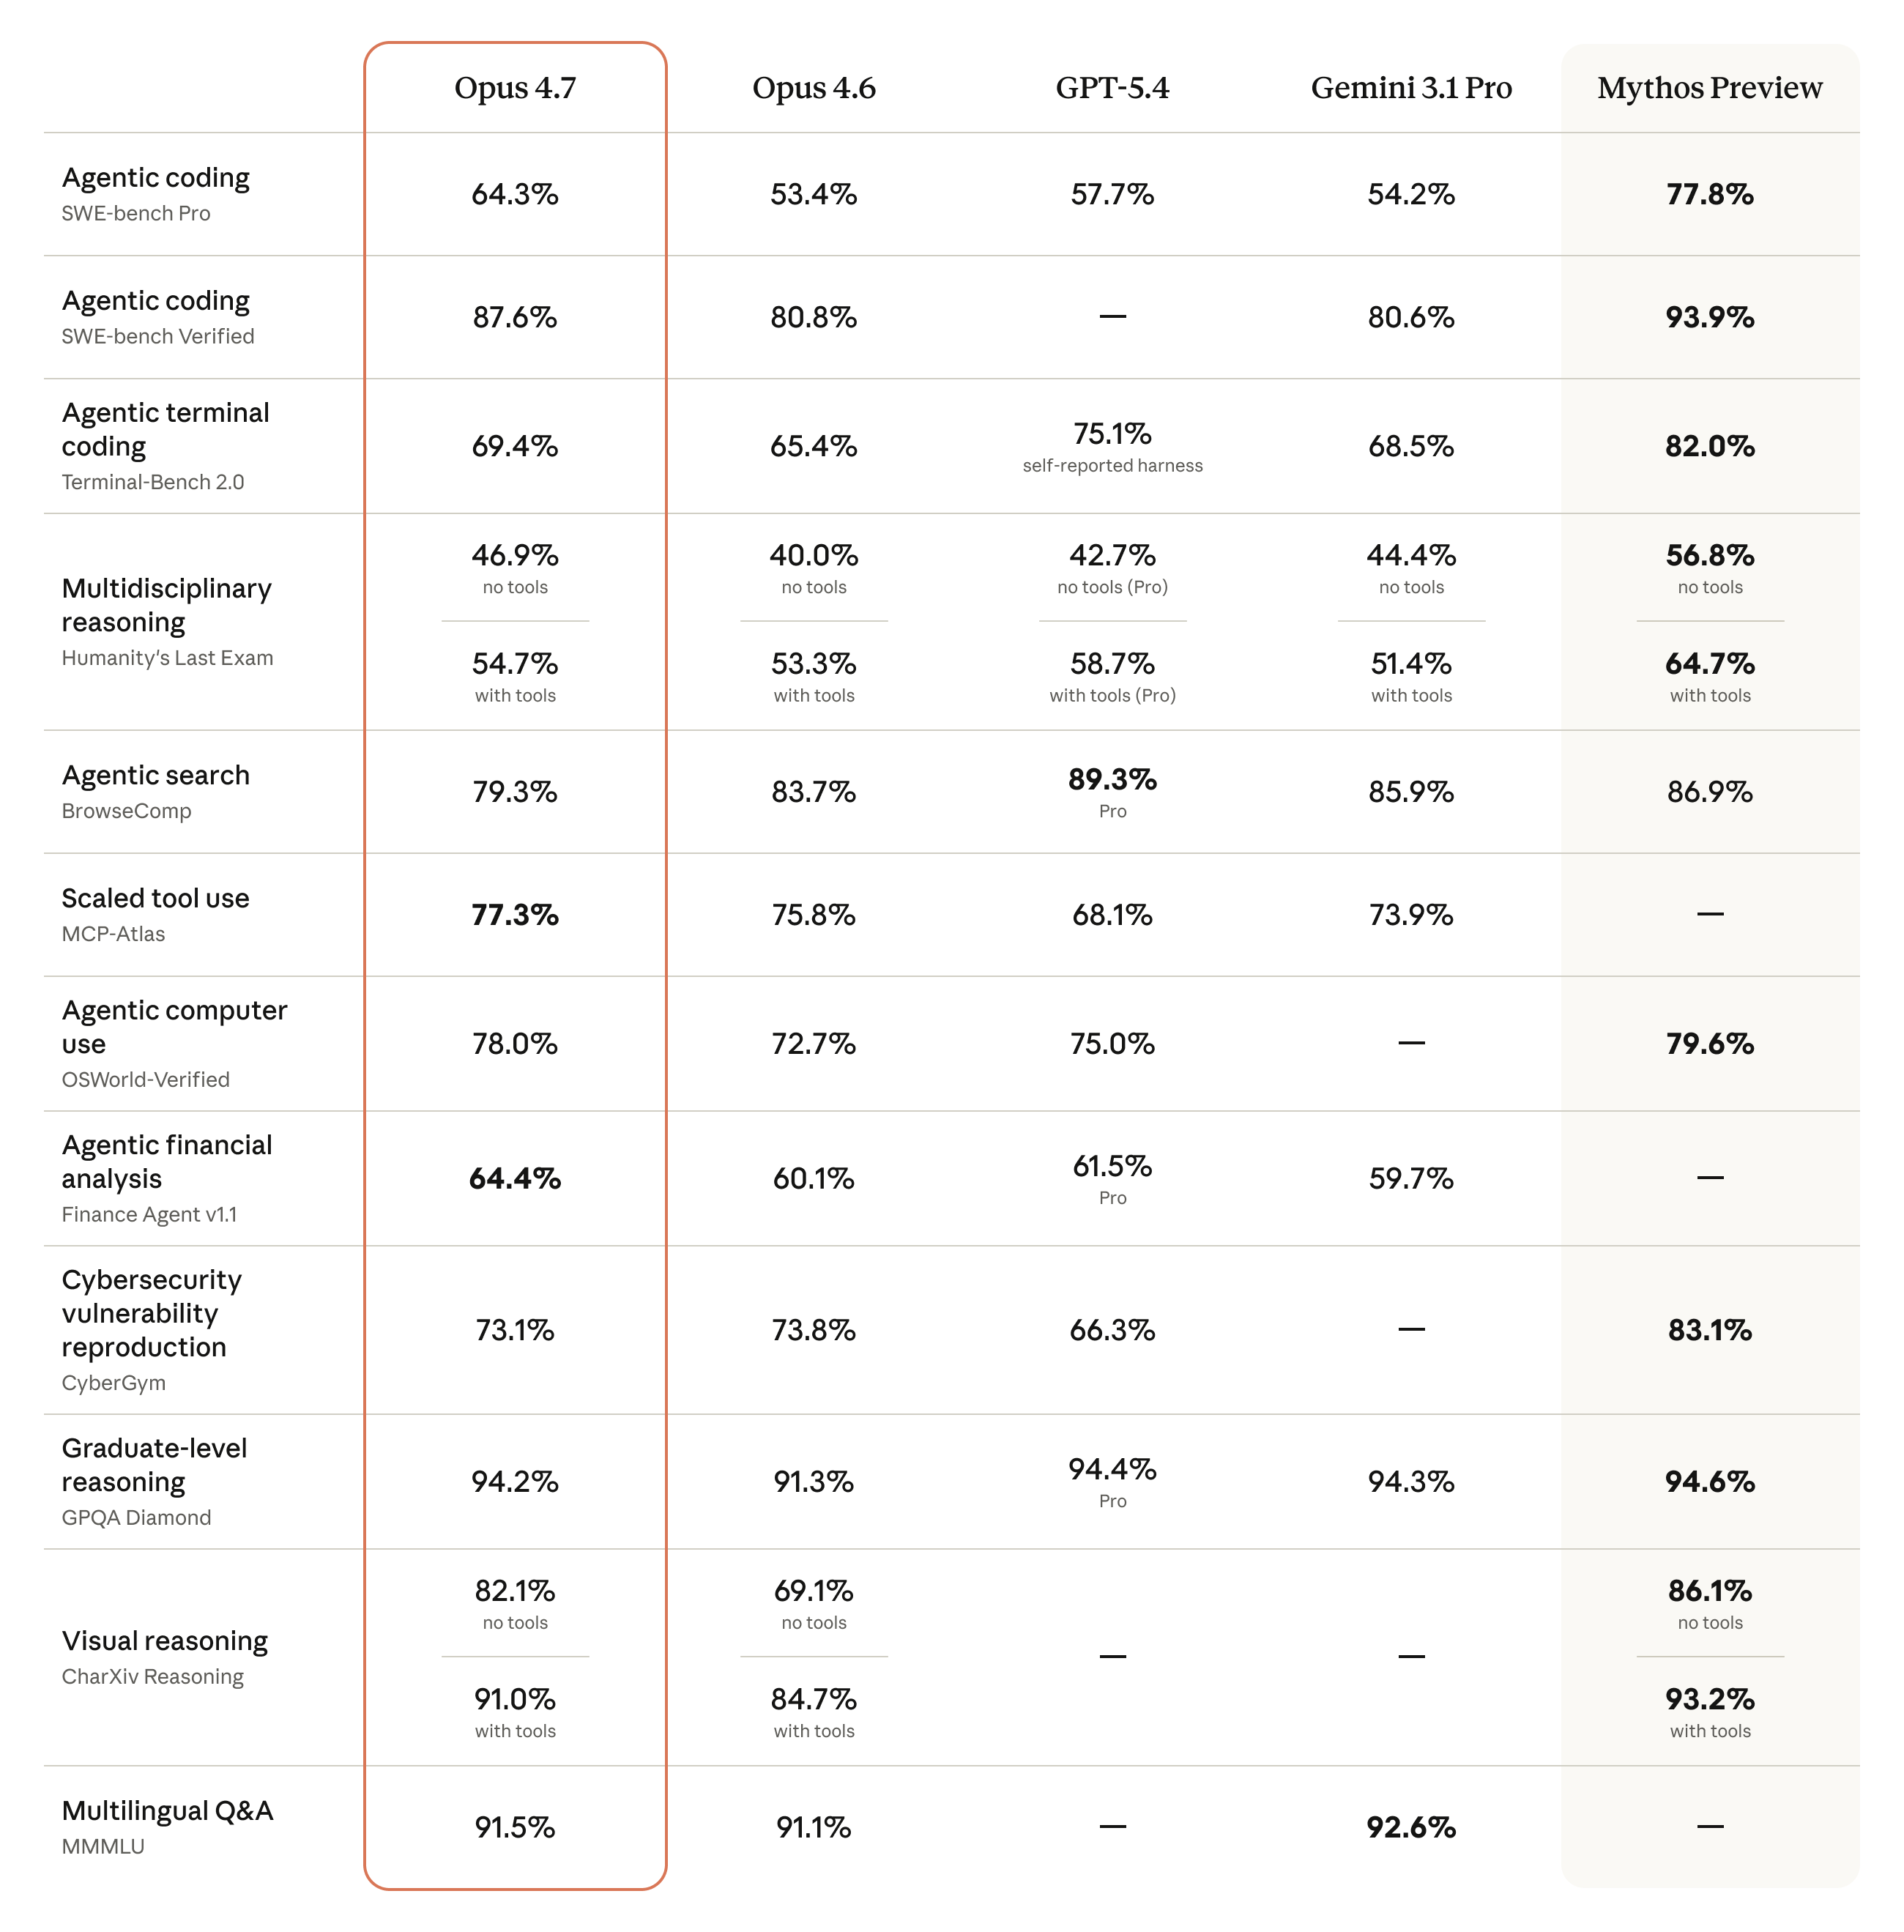
雖然不如Claude Mythos Preview(Anthropic最強大的模型)那般全面,Opus 4.7在一系列重要基準測試上仍全面超越Opus 4.6。
2. 基準測試與效能表現
2.1 與Opus 4.6及競爭對手的全面比較
Anthropic在多個領域將Opus 4.7與Opus 4.6、GPT-5.4及Gemini 3.1 Pro進行比較:
| 基準測試 | Opus 4.7 | Opus 4.6 | 提升幅度 |
|---|---|---|---|
| SWE-bench Verified | 頂尖 | 基準 | +顯著提升 |
| CursorBench | 70% | 58% | +12% |
| BigLaw Bench(高努力) | 90.9% | — | 最強 |
| Rakuten-SWE-Bench | 完成3倍任務 | 基準 | 3倍 |
| GDPval-AA(財務/法律) | 最先進 | — | 排名第一 |
| Finance Agent Eval | 最先進 | 0.767 | 0.813 |
| Visual Acuity(XBOW) | 98.5% | 54.5% | +44% |
| 一般程式設計(93項任務) | +13% | 基準 | +13% |
2.2 各領域評估
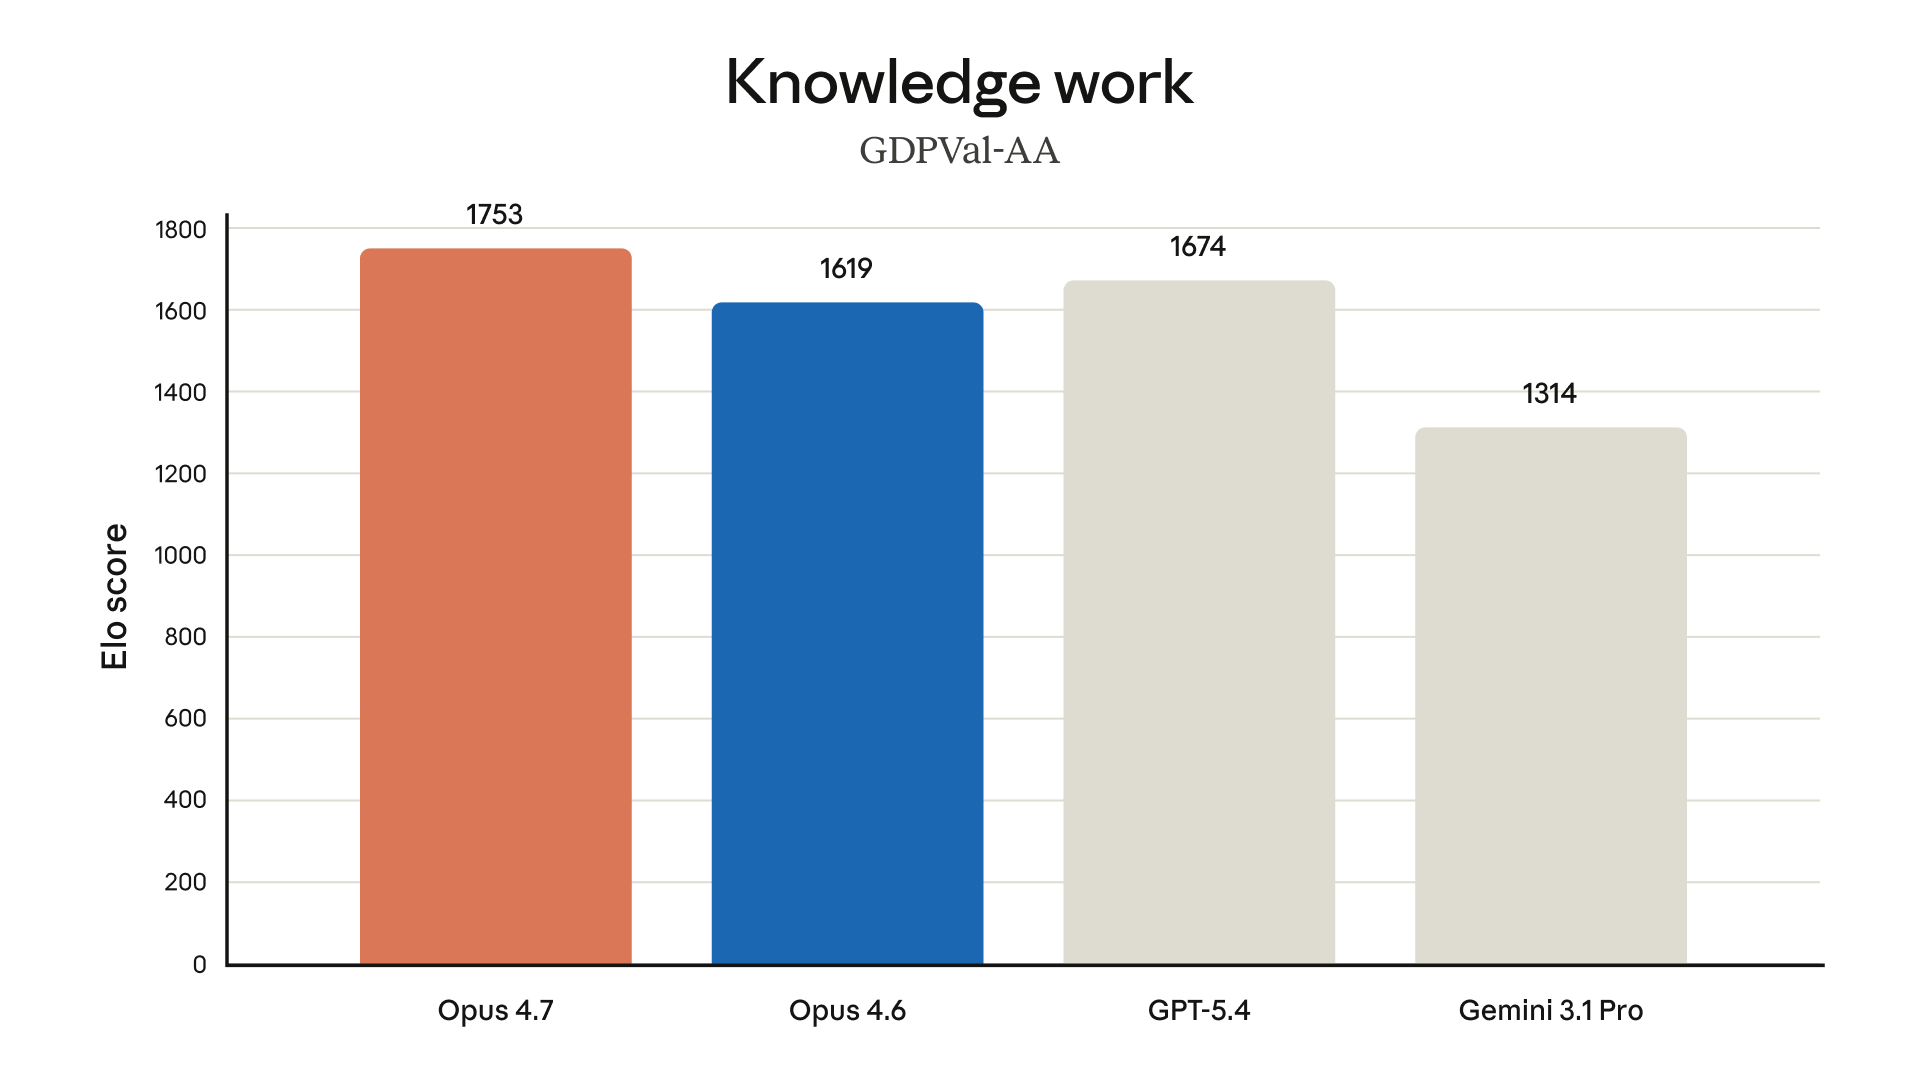
Anthropic內部測試顯示,Opus 4.7在以下領域均有顯著提升:
- 辦公室任務(PowerPoint、Excel、文件建立)
- 視覺(圖像辨識與分析)
- 文件推理(Databricks測試:錯誤率較Opus 4.6減少21%)
- 長脈絡推理(在長篇內容中保持連貫推理)
- 生物學(生命科學應用)
- 長期連貫性(多步驟任務中的一致性)
- 程式設計(程式碼撰寫、除錯、程式碼審查)
3. 核心改進
3.1 視覺解析度提升超過3倍
這是最重大的升級之一。Opus 4.7能處理長邊最長2,576像素(約375萬像素)的圖像——是前代Claude模型的3倍以上。
這開啟了一系列全新使用案例:
- 電腦使用代理人讀取資訊密集的螢幕截圖
- 從複雜技術圖表擷取數據
- 生命科學——讀取化學結構式、工程圖,以及專利文件
- 需要像素精確度的工作
注意: 這是模型層面的變更,而非API參數。傳送給模型的圖像將以更高解析度處理,意味著消耗更多tokens。若不需要高細節,可在傳送前先對圖像進行降採樣。
3.2 卓越的指示遵循能力
Opus 4.7在指示遵循方面有顯著改善。Anthropic提醒這是雙向的改變:
- 好消息: 模型更精確地遵循指示,不再跳過或寬鬆解讀
- 需注意: 為Opus 4.6撰寫的提示詞可能產生非預期結果,因為Opus 4.7解讀更為字面
→ 建議: 遷移至4.7時,重新調整提示詞與框架。
3.3 更佳的長期記憶
Opus 4.7更有效地運用以檔案系統為基礎的記憶。模型能夠:
- 在多個長對話中記住重要筆記
- 利用記憶在新任務中繼續進行,無需重新提供完整脈絡
這對多日代理人工作流程是重要的改進。
3.4 全新努力等級:xhigh
Opus 4.7引入了**xhigh**(超高)努力等級——介於high與max之間。這能更精細地控制以下三者之間的平衡:
- 推理深度
- 延遲時間
- Token成本
在Claude Code中,Anthropic已將所有方案的預設努力等級提升至xhigh。建議在測試Opus 4.7的程式設計與代理人使用案例時,從high或xhigh開始。
4. 真實使用回饋:各公司怎麼說
Anthropic在早期存取階段收集了超過20家主要科技公司的使用回饋。以下是重點摘要:
4.1 程式設計與工程
Cursor(CursorBench:70% vs Opus 4.6的58%):
「Claude Opus 4.7是重大的能力躍進,尤其體現在自主性與更具創意的推理方面。」 — Michael Truell,共同創辦人暨CEO
Replit:
「Opus 4.7是個輕鬆的升級決定。同等品質,成本更低——在日誌分析、找出錯誤、建議修復方面更有效率更精確。在技術討論中會推回意見,幫助我做出更好的決策。感覺像是一位真正更好的同事。」 — Michele Catasta,總裁
Warp(終端機基準測試):
「Opus 4.7通過了前代Claude模型無法完成的終端機基準測試任務,並解決了Opus 4.6無法突破的複雜並發錯誤。」 — Zach Lloyd,創辦人暨CEO
Bolt:
「在長期應用程式建置任務上比Opus 4.6好10%,且沒有退步——這在代理人模型中實屬罕見。」 — Eric Simons,CEO暨創辦人
Rakuten:
「Claude Opus 4.7解決的生產任務數量是Opus 4.6的3倍,在程式碼品質與測試品質上均有兩位數成長。」 — Yusuke Kaji,AI for Business總經理
4.2 代理人與長期任務
Devin(Cognition):
「Claude Opus 4.7將Devin的長期自主能力提升到新境界。它能連貫工作數小時,不放棄困難問題,開啟了一類以前無法穩定運行的深度調查工作。」 — Scott Wu,CEO
Notion:
「比Opus 4.6提升14%,且使用更少tokens,工具錯誤減少三分之一。是首個通過我們隱性需求測試的模型,能在先前讓Opus停下來的工具故障中繼續執行。」 — Sarah Sachs,AI Lead
Factory:
「任務成功率提升10至15%,工具錯誤更少,驗證步驟執行更可靠。能夠完成任務,而不是中途停止。」 — Leo Tchourakov,MTS
4.3 財務與法律
Ramp:
「在代理人團隊工作流程中表現更強:更佳的角色忠實度、指示遵循、協調能力與複雜推理。需要的逐步指引大幅減少。」 — Austin Ray,軟體工程師
Harvey(BigLaw Bench:90.9%準確率):
「在BigLaw Bench上展現最強的實質準確性。正確區分了轉讓條款與控制權變更條款——這是令先前前沿模型感到困難的任務。」 — Niko Grupen,應用研究主任
Databricks:
「在處理來源資訊時,錯誤率比Opus 4.6減少21%。是目前企業文件分析最佳的Claude模型。」 — Hanlin Tang,神經網路CTO
4.4 視覺與多模態
Solve Intelligence(生命科學專利):
「多模態理解的重大改進:讀取化學結構式、分析複雜工程圖。高解析度支援讓我們能為生命科學專利工作流程打造一流工具。」 — Sanj Ahilan,CRO
XBOW(滲透測試——視覺精確度:98.5% vs 54.5%):
「視覺精確度基準測試達到98.5%,相比Opus 4.6的54.5%。電腦使用最大的痛點消失了,開啟了一整類以前無法使用的工作。」 — Oege de Moor,CEO
5. 安全性與對齊
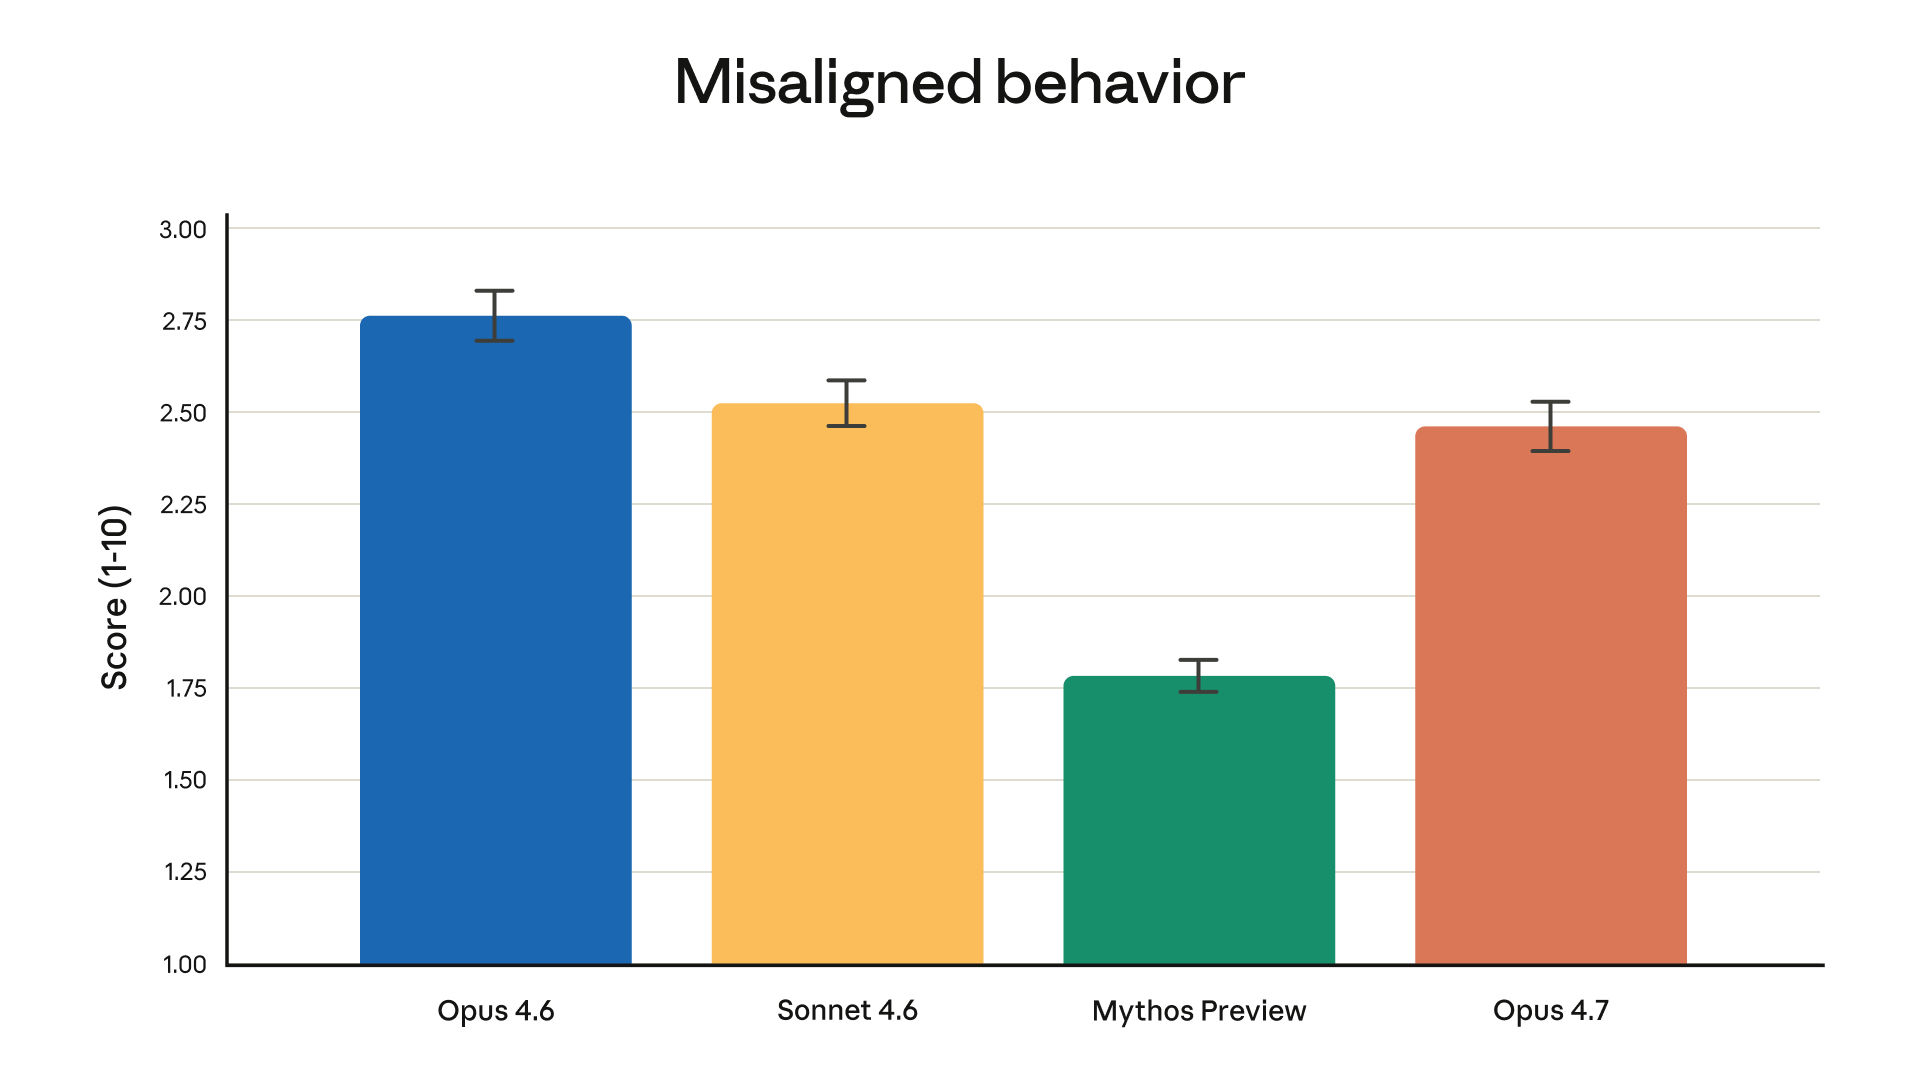
Opus 4.7具備與Opus 4.6相似的安全性概況:
相較於4.6的改進:
- 誠實性(更加真實)
- 抵抗提示注入攻擊的能力
輕微弱點:
- 偶爾對管制物質提供過於詳細的減害建議
Anthropic的結論是,該模型「整體上對齊良好且值得信賴,雖然行為尚未完全理想。」Mythos Preview依Anthropic自身評估仍是對齊最佳的模型。
網路安全防護
Opus 4.7是首個配備自動化防護措施的模型,能夠偵測並封鎖與禁止或高風險網路安全活動相關的請求。Anthropic解釋,這為Mythos等級模型最終更廣泛發布奠定了基礎。
希望將Opus 4.7用於合法網路安全工作(漏洞研究、滲透測試、紅隊測試)的安全專業人員,可申請**網路安全驗證計畫**。
6. 全新配套功能
6.1 任務預算(公開測試版)
Claude Platform(API)上的全新功能:開發者可以引導Claude的Token用量,讓模型在較長的執行過程中優先分配工作。適用於需要成本控制的代理人工作流程。
6.2 Claude Code中的/ultrareview
全新斜線命令,可建立專用審查對話,讀取所有程式碼變更,並標記出徹底的審查者會發現的錯誤與設計問題。
- Pro與Max用戶可獲得3次免費ultrareview試用
- Anthropic已將所有方案的Claude Code預設努力等級提升至
xhigh
6.3 Max用戶的自動模式
自動模式是全新的權限選項:Claude代為做出決策,讓較長的任務能以更少的中斷執行,降低跳過權限的風險。
7. 定價與可用性
| 細節 | 資訊 |
|---|---|
| 輸入價格 | 5美元 / 百萬tokens |
| 輸出價格 | 25美元 / 百萬tokens |
| 相較Opus 4.6 | 維持不變 |
| API模型ID | claude-opus-4-7 |
| Claude.ai | ✅ 所有方案 |
| Claude API | ✅ 可用 |
| Amazon Bedrock | ✅ 可用 |
| Google Cloud Vertex AI | ✅ 可用 |
| Microsoft Foundry | ✅ 可用 |
8. 從Opus 4.6遷移:必知事項
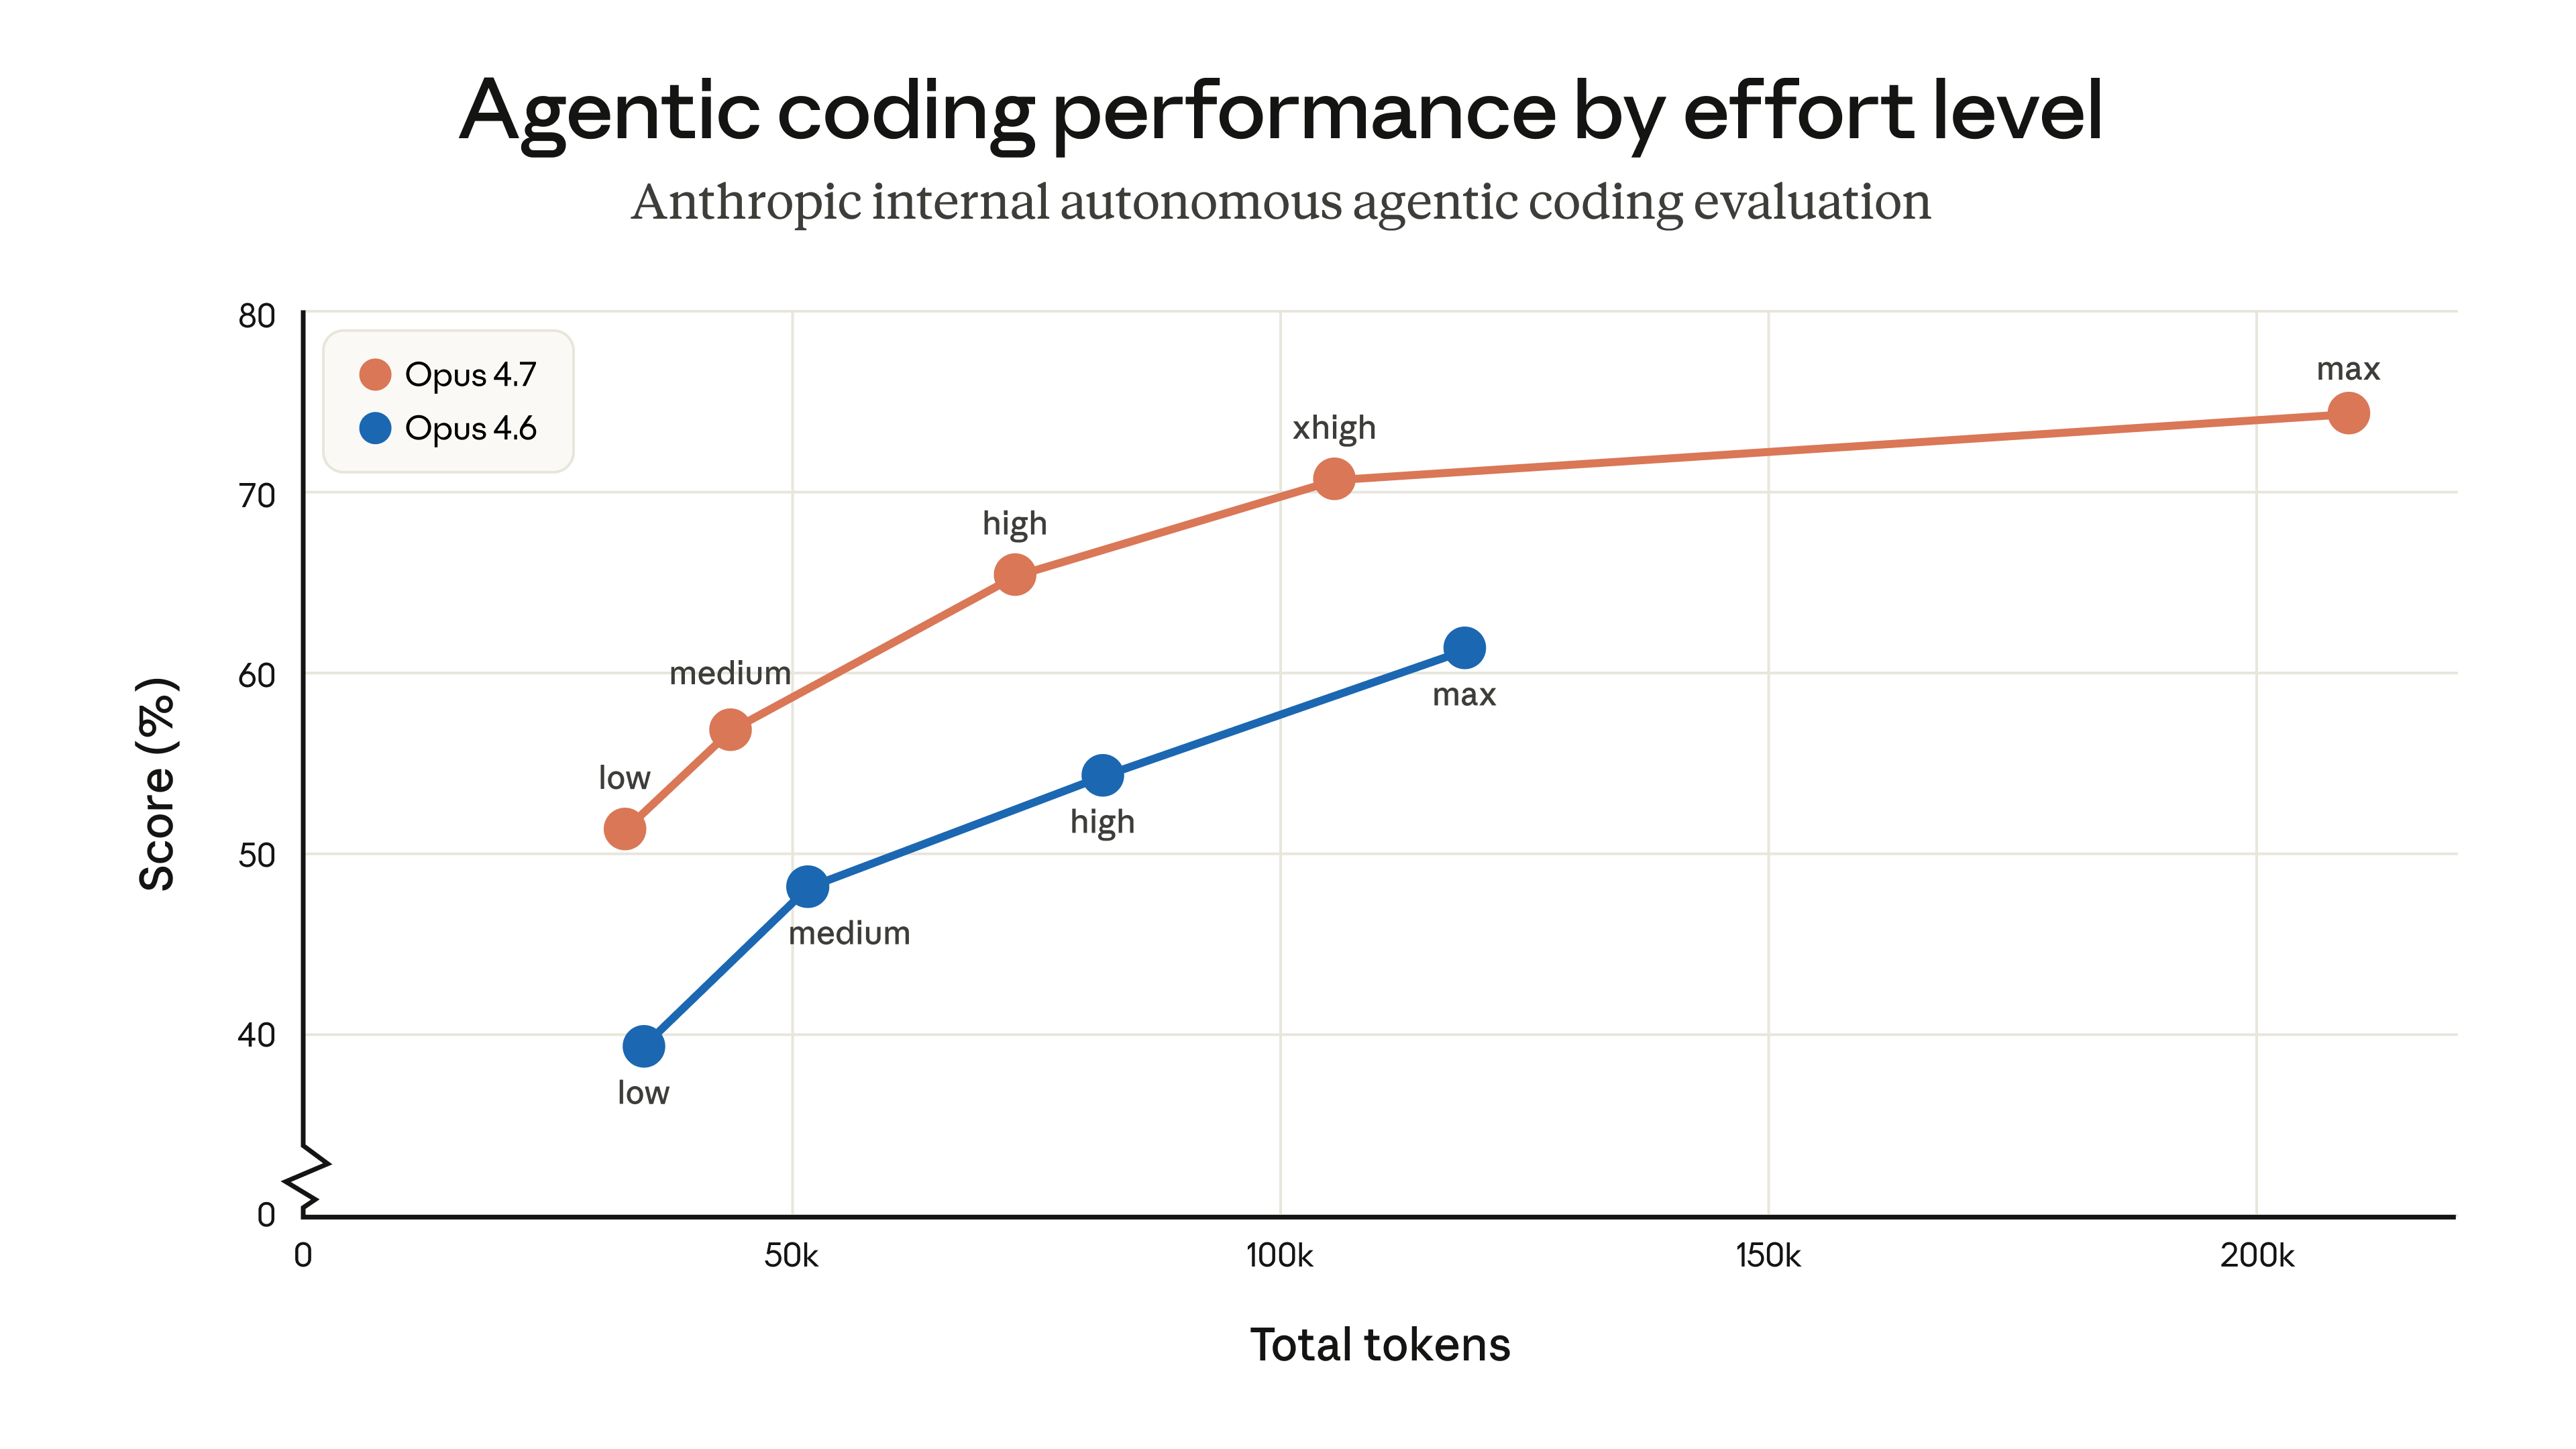
Opus 4.7是Opus 4.6的直接升級,但有兩項Token用量變更需要預先規劃:
8.1 新版分詞器
Opus 4.7使用改進的分詞器,能更有效率地處理文字。代價是:相同的輸入可能對應更多tokens——依內容類型約為1.0至1.35倍。
8.2 高努力等級下更多思考用量
Opus 4.7在高努力等級下「思考」更多,尤其是在代理人設定中的後期對話輪次。這提升了可靠性,但會產生更多輸出tokens。
如何控制Token用量
- 使用努力參數(若不需要最高準確度,降至
medium或low) - 調整任務預算
- 在提示詞中更明確要求簡潔
實際結果: 在內部程式設計評估中,所有努力等級的總Token用量相較Opus 4.6均有改善。但Anthropic建議根據您的實際流量進行測量。
請參閱官方遷移指南。
9. 與競爭對手比較
| 模型 | 優勢 | 相對弱點 |
|---|---|---|
| Claude Opus 4.7 | 代理人程式設計、視覺、指示遵循、長期任務 | 不如Mythos Preview全面 |
| GPT-5.4 | 全面均衡、龐大生態系 | 特定程式設計基準測試落後Opus 4.7 |
| Gemini 3.1 Pro | 原生多模態、Google整合 | 代理人程式設計任務落後 |
| Claude Mythos Preview | 最強能力、最佳對齊 | 存取受限、網路安全防護尚未完整 |
10. Opus 4.7最適合哪些任務?
✅ 強烈推薦
- 代理人程式設計:CI/CD自動化、長時間除錯、程式碼審查
- 多步驟代理人工作流程:研究代理人、複雜編排
- 視覺任務:分析密集螢幕截圖、技術圖表、科學文件
- 文件分析:法律、財務、企業文件
- 專業內容:簡報、儀表板、報告生成
⚠️ 考慮替代方案
- 簡單問答:Sonnet 4.6已足夠且成本低得多
- 大量簡單任務:Claude Haiku更為經濟
- 需要絕對最強模型:等待Mythos Preview更廣泛發布
結語
Claude Opus 4.7代表Anthropic在2026年的真正重大進步。它不是市面上最全面的模型(Mythos Preview仍保有這個頭銜),但在進階程式設計、代理人工作流程與視覺方面——Opus 4.7正在設立新的標準。
特別值得注意的是,定價維持不變(每百萬tokens 5美元/25美元),而效能卻大幅提升。再加上xhigh努力等級、任務預算,以及Claude Code中的/ultrareview——這套工具組是工程團隊與開發者今日就應認真考慮採用的選擇。
主要來源:Anthropic部落格——介紹Claude Opus 4.7(2026年4月16日)| Claude Opus 4.7系統卡 | API文件