Ngày 16 tháng 4 năm 2026, Anthropic chính thức ra mắt Claude Opus 4.7 --- model AI flagship mới nhất, được thiết kế đặc biệt cho các tác vụ lập trình phức tạp, quy trình agentic dài hạn, và xử lý hình ảnh độ phân giải cao. Đây không chỉ là một bản cập nhật thông thường --- đây là bước nhảy vọt đáng kể so với Opus 4.6, được chứng minh qua hàng chục benchmark và phản hồi thực tế từ các công ty công nghệ hàng đầu thế giới.
Bài viết này tổng hợp và phân tích chi tiết toàn bộ những gì bạn cần biết về Claude Opus 4.7: từ điểm mạnh, benchmark, pricing, đến hướng dẫn chuyển đổi từ Opus 4.6.
1. Claude Opus 4.7 là gì?
Claude Opus 4.7 là model flagship mới nhất trong dòng Claude 4, được Anthropic định vị là model tốt nhất cho:
- Lập trình nâng cao (advanced software engineering) --- đặc biệt các task khó, yêu cầu suy luận sâu
- Agentic workflows dài hạn --- tự động hóa CI/CD, tác nhân nghiên cứu, công việc đa bước
- Multimodal --- đọc và phân tích hình ảnh độ phân giải cao
- Công việc chuyên nghiệp --- phân tích tài chính, pháp lý, tài liệu phức tạp
Anthropic nhận xét rằng Opus 4.7 xử lý các tác vụ phức tạp, dài hạn với sự nghiêm ngặt và nhất quán, tuân thủ chính xác hướng dẫn, đồng thời tự nghĩ ra cách xác minh đầu ra của chính mình trước khi báo cáo lại.
Mặc dù ít toàn năng hơn Claude Mythos Preview --- model mạnh nhất của Anthropic --- Opus 4.7 vẫn vượt trội Opus 4.6 trên hàng loạt benchmark quan trọng.
2. Benchmark và hiệu năng
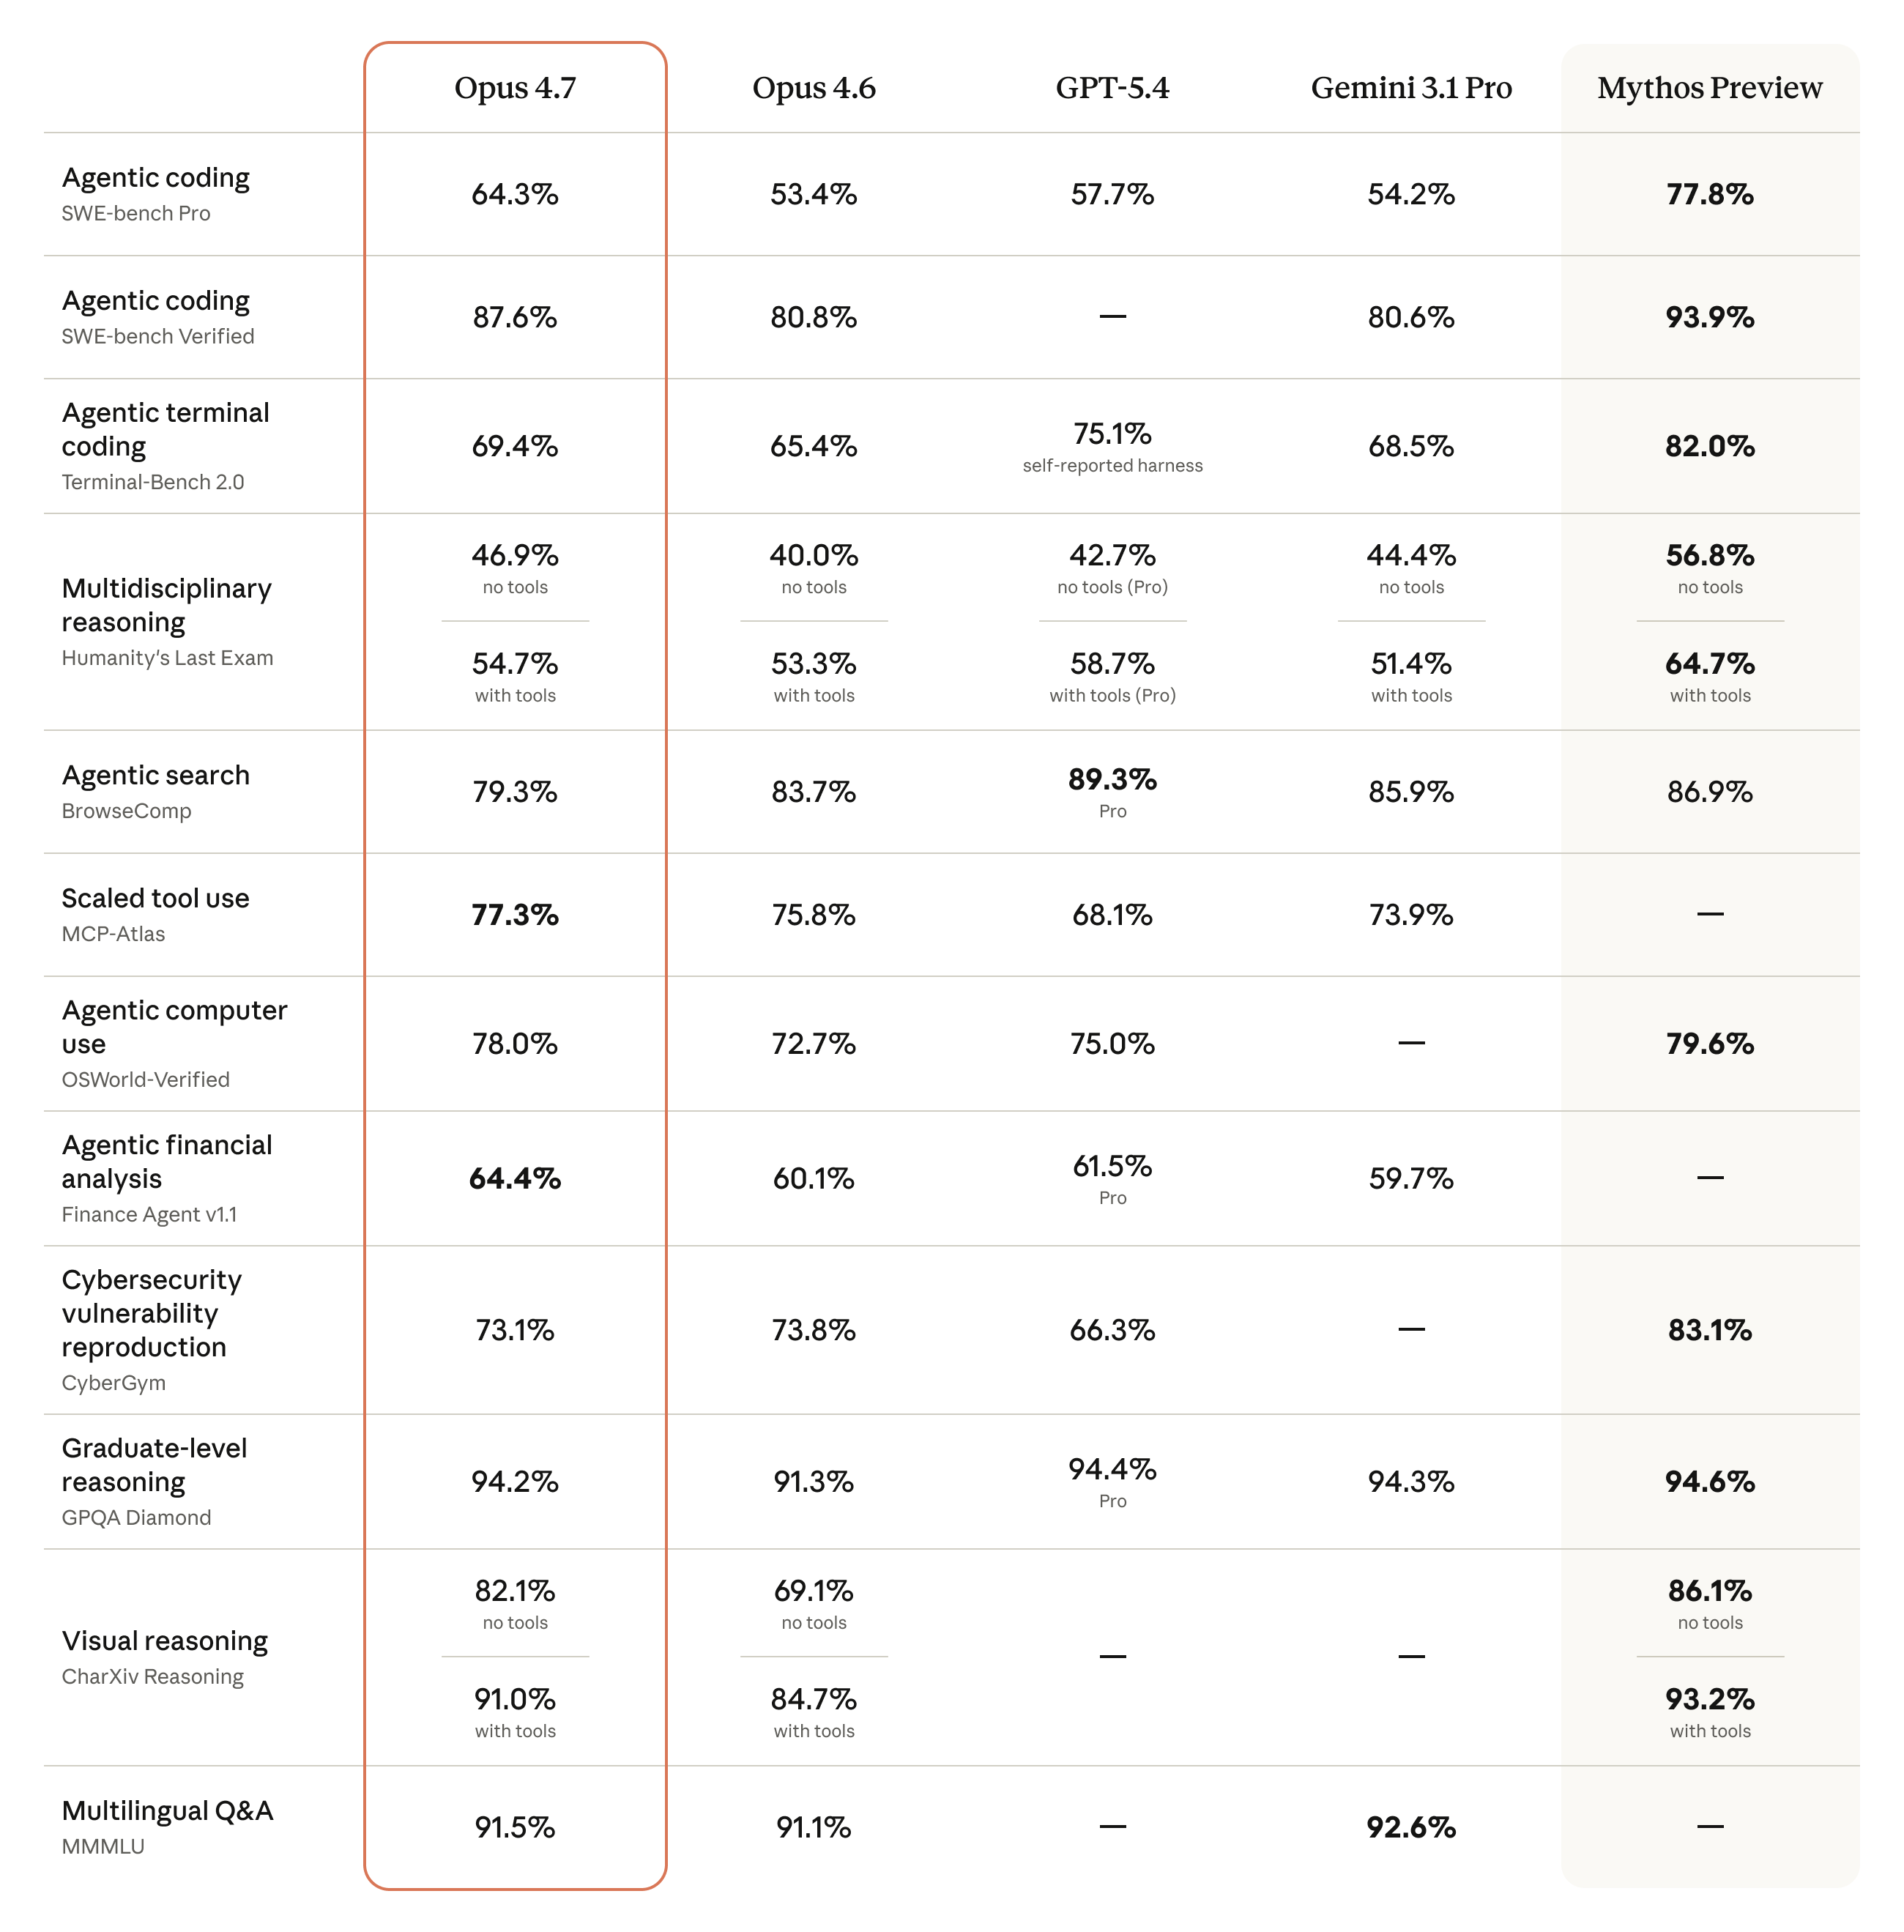
2.1 So sánh tổng quan với Opus 4.6 và các đối thủ
Anthropic so sánh Opus 4.7 với Opus 4.6, GPT-5.4, và Gemini 3.1 Pro trên nhiều lĩnh vực:
| Benchmark | Opus 4.7 | Opus 4.6 | Cải thiện |
|---|---|---|---|
| SWE-bench Verified | Top tier | Baseline | +significant |
| CursorBench | 70% | 58% | +12% |
| BigLaw Bench (High Effort) | 90.9% | --- | Mạnh nhất |
| Rakuten-SWE-Bench | 3× more tasks | Baseline | 3× |
| GDPval-AA (Finance/Legal) | State-of-the-art | --- | Hàng đầu |
| Finance Agent Eval | State-of-the-art | 0.767 | 0.813 |
| Visual Acuity (XBOW) | 98.5% | 54.5% | +44% |
| General coding (93 tasks) | +13% | Baseline | +13% |
2.2 Đánh giá theo domain
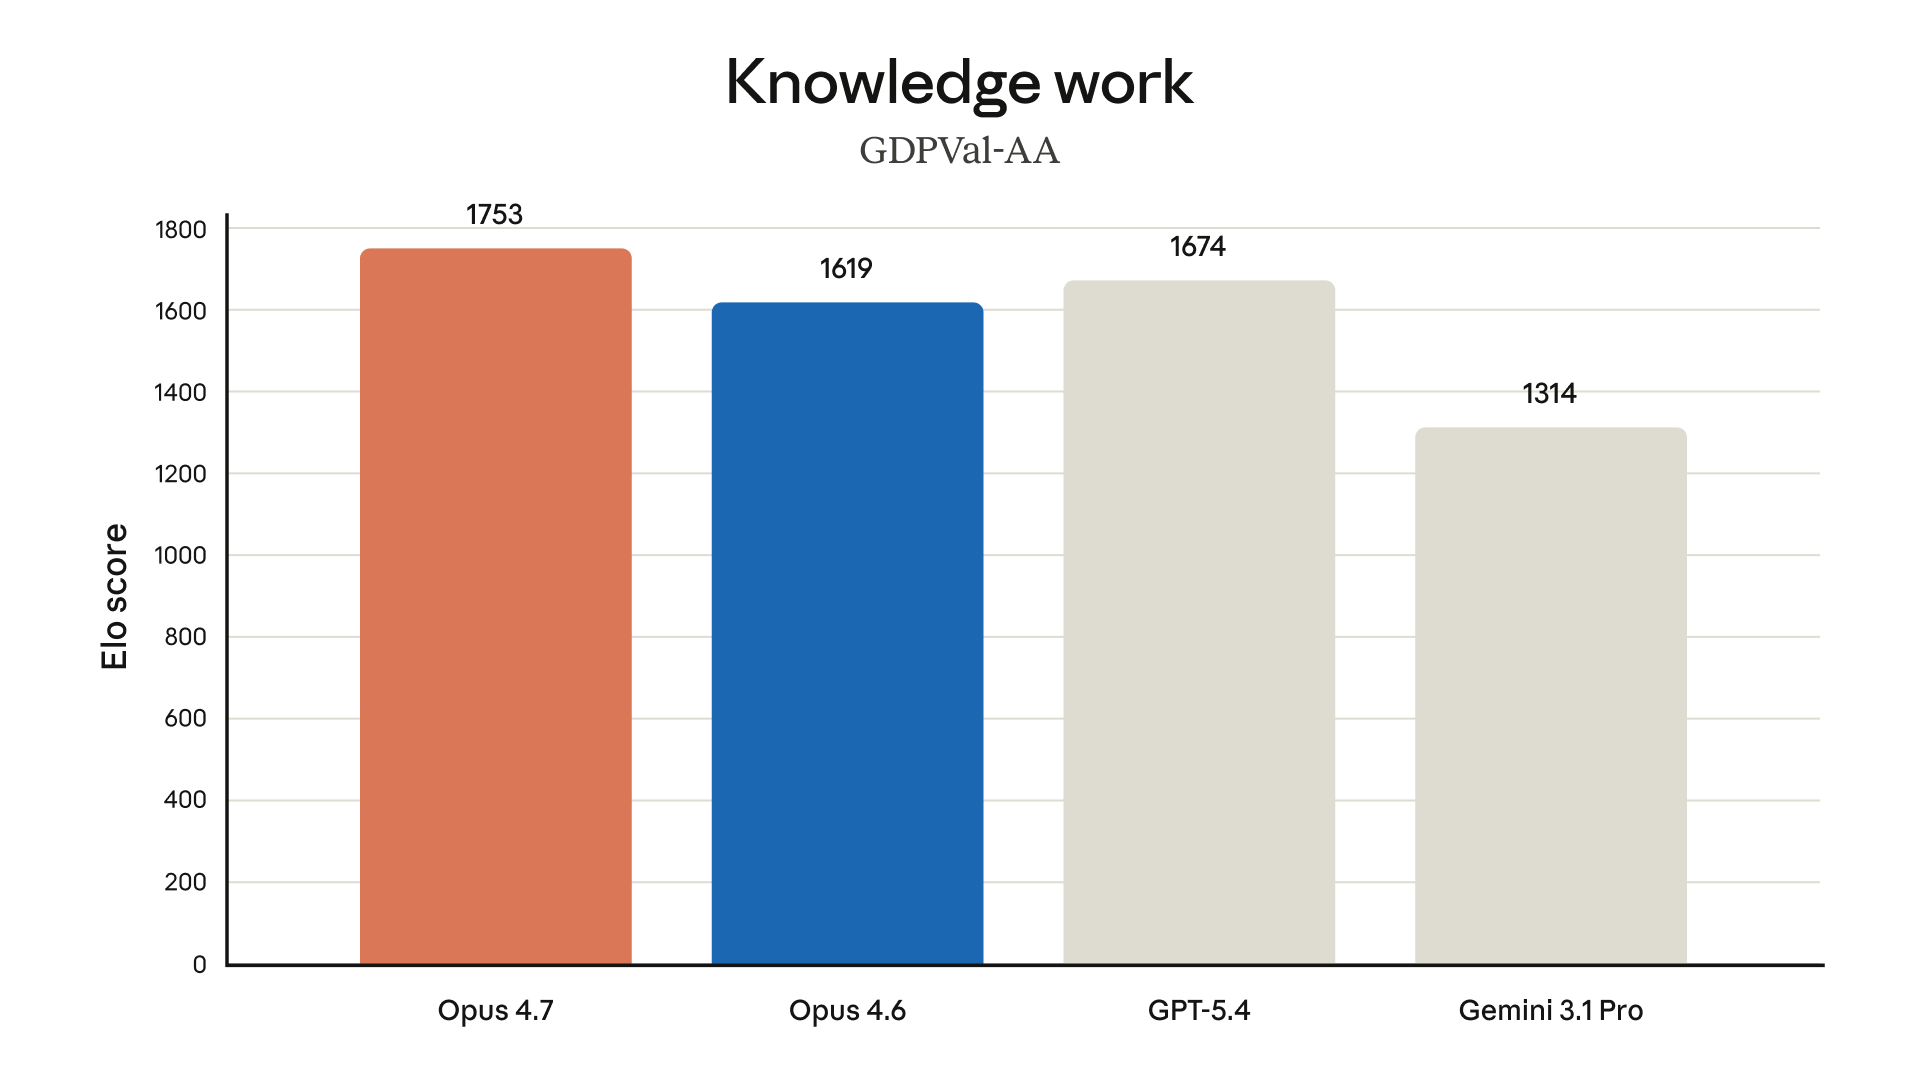
Kết quả kiểm thử nội bộ của Anthropic cho thấy Opus 4.7 cải thiện đáng kể trên các domain:
- Office tasks (PowerPoint, Excel, document creation)
- Vision (nhận diện và phân tích hình ảnh)
- Document reasoning (21% ít lỗi hơn Opus 4.6 theo Databricks)
- Long-context reasoning (lý luận xuyên suốt nội dung dài)
- Biology (ứng dụng khoa học đời sống)
- Long-term coherence (nhất quán trong tác vụ đa bước)
- Coding (lập trình, debug, review code)
3. Những cải tiến cốt lõi
3.1 Vision độ phân giải cao hơn 3×
Đây là một trong những nâng cấp quan trọng nhất. Opus 4.7 có thể xử lý hình ảnh lên đến 2,576 pixels trên cạnh dài (~3.75 megapixels) --- hơn 3 lần so với các model Claude trước đây.
Điều này mở ra loạt use case mới:
- Computer-use agents đọc screenshot dày đặc thông tin
- Data extraction từ biểu đồ kỹ thuật phức tạp
- Life sciences --- đọc cấu trúc hóa học, sơ đồ kỹ thuật, hồ sơ bằng sáng chế
- Công việc cần tham chiếu pixel-perfect
Lưu ý: Đây là thay đổi ở cấp model, không phải API parameter. Hình ảnh gửi lên sẽ được xử lý ở độ phân giải cao hơn, nghĩa là tiêu tốn nhiều token hơn. Nếu không cần chi tiết cao, bạn có thể downsample ảnh trước khi gửi.
3.2 Instruction Following vượt trội
Opus 4.7 cải thiện đáng kể khả năng tuân thủ hướng dẫn. Anthropic cảnh báo rằng đây là thay đổi hai chiều:
- Tốt: Model tuân thủ chính xác hơn, không bỏ qua hoặc diễn giải lỏng lẻo
- Cần chú ý: Các prompt viết cho Opus 4.6 có thể cho kết quả bất ngờ vì Opus 4.7 diễn giải literal hơn
→ Khuyến nghị: Re-tune lại prompt và harness khi migrate sang 4.7.
3.3 Memory dài hạn tốt hơn
Opus 4.7 sử dụng file system-based memory hiệu quả hơn. Model có thể:
- Nhớ các ghi chú quan trọng qua nhiều session dài
- Sử dụng memory để tiếp tục task mới mà không cần cung cấp lại toàn bộ context
Đây là cải tiến quan trọng cho agentic workflows nhiều ngày.
3.4 Effort level mới: xhigh
Opus 4.7 giới thiệu effort level xhigh (extra high) --- nằm giữa high và max. Điều này cho phép kiểm soát tốt hơn cân bằng giữa:
- Độ sâu suy luận
- Latency
- Chi phí token
Trong Claude Code, Anthropic đã nâng effort level mặc định lên xhigh cho tất cả các plan. Khuyến nghị bắt đầu với high hoặc xhigh khi test Opus 4.7 cho coding và agentic use cases.
4. Phản hồi từ thực tế: Các công ty nói gì?
Anthropic thu thập feedback từ hơn 20 công ty công nghệ lớn trong giai đoạn early access. Dưới đây là những điểm nổi bật nhất:
4.1 Coding & Engineering
Cursor (CursorBench: 70% vs 58% của Opus 4.6):
"Claude Opus 4.7 là bước nhảy đáng kể về khả năng, đặc biệt về tự chủ và lý luận sáng tạo hơn." --- Michael Truell, Co-Founder & CEO
Replit:
"Opus 4.7 là quyết định upgrade dễ dàng. Cùng chất lượng với chi phí thấp hơn --- hiệu quả và chính xác hơn cho phân tích log, tìm bug, đề xuất fix. Nó phản bác trong các cuộc thảo luận kỹ thuật để giúp tôi ra quyết định tốt hơn. Cảm giác như đồng nghiệp tốt hơn thật sự." --- Michele Catasta, President
Warp (Terminal Bench):
"Opus 4.7 vượt qua các task Terminal Bench mà các model Claude trước không làm được, và giải quyết được bug concurrency phức tạp mà Opus 4.6 không crack được." --- Zach Lloyd, Founder & CEO
Bolt:
"Tốt hơn Opus 4.6 đến 10% trong các tác vụ app-building dài hạn, không có regression --- điều hiếm gặp với các agentic model." --- Eric Simons, CEO & Founder
Rakuten:
"Claude Opus 4.7 giải quyết gấp 3 lần task production so với Opus 4.6, với tăng trưởng double-digit về Code Quality và Test Quality." --- Yusuke Kaji, GM AI for Business
4.2 Agentic & Long-horizon tasks
Devin (Cognition):
"Claude Opus 4.7 đưa long-horizon autonomy lên tầm mới trong Devin. Làm việc coherent trong nhiều giờ, không bỏ cuộc trước bài toán khó, mở ra lớp công việc deep investigation mà trước đây không thể chạy ổn định." --- Scott Wu, CEO
Notion:
"Plus 14% so với Opus 4.6 với ít token hơn và một phần ba tool errors. Model đầu tiên pass implicit-need tests của chúng tôi, tiếp tục thực thi qua tool failures mà trước đây dừng Opus lại." --- Sarah Sachs, AI Lead
Factory:
"10-15% lift trong task success, ít tool errors hơn, follow-through trên validation steps đáng tin cậy hơn. Thực hiện công việc đến cuối thay vì dừng giữa chừng." --- Leo Tchourakov, MTS
4.3 Finance & Legal
Ramp:
"Mạnh hơn trong agent-team workflows: role fidelity, instruction-following, coordination, và lý luận phức tạp tốt hơn. Cần ít step-by-step guidance hơn nhiều." --- Austin Ray, Software Engineer
Harvey (BigLaw Bench: 90.9% accuracy):
"Độ chính xác thực chất mạnh nhất trên BigLaw Bench. Phân biệt đúng assignment provisions vs change-of-control provisions --- task thách thức các frontier model trước đây." --- Niko Grupen, Head of Applied Research
Databricks:
"21% ít lỗi hơn Opus 4.6 khi làm việc với source information. Model Claude tốt nhất cho enterprise document analysis." --- Hanlin Tang, CTO Neural Networks
4.4 Vision & Multimodal
Solve Intelligence (life sciences patents):
"Cải thiện lớn về multimodal understanding: đọc cấu trúc hóa học, phân tích sơ đồ kỹ thuật phức tạp. High resolution support giúp build best-in-class tools cho life sciences patent workflows." --- Sanj Ahilan, CRO
XBOW (penetration testing --- visual acuity: 98.5% vs 54.5%):
"98.5% trên visual-acuity benchmark vs 54.5% của Opus 4.6. Pain point lớn nhất của chúng tôi về computer-use đã biến mất, mở ra toàn bộ lớp công việc mà trước đây không dùng được." --- Oege de Moor, CEO
5. Safety & Alignment
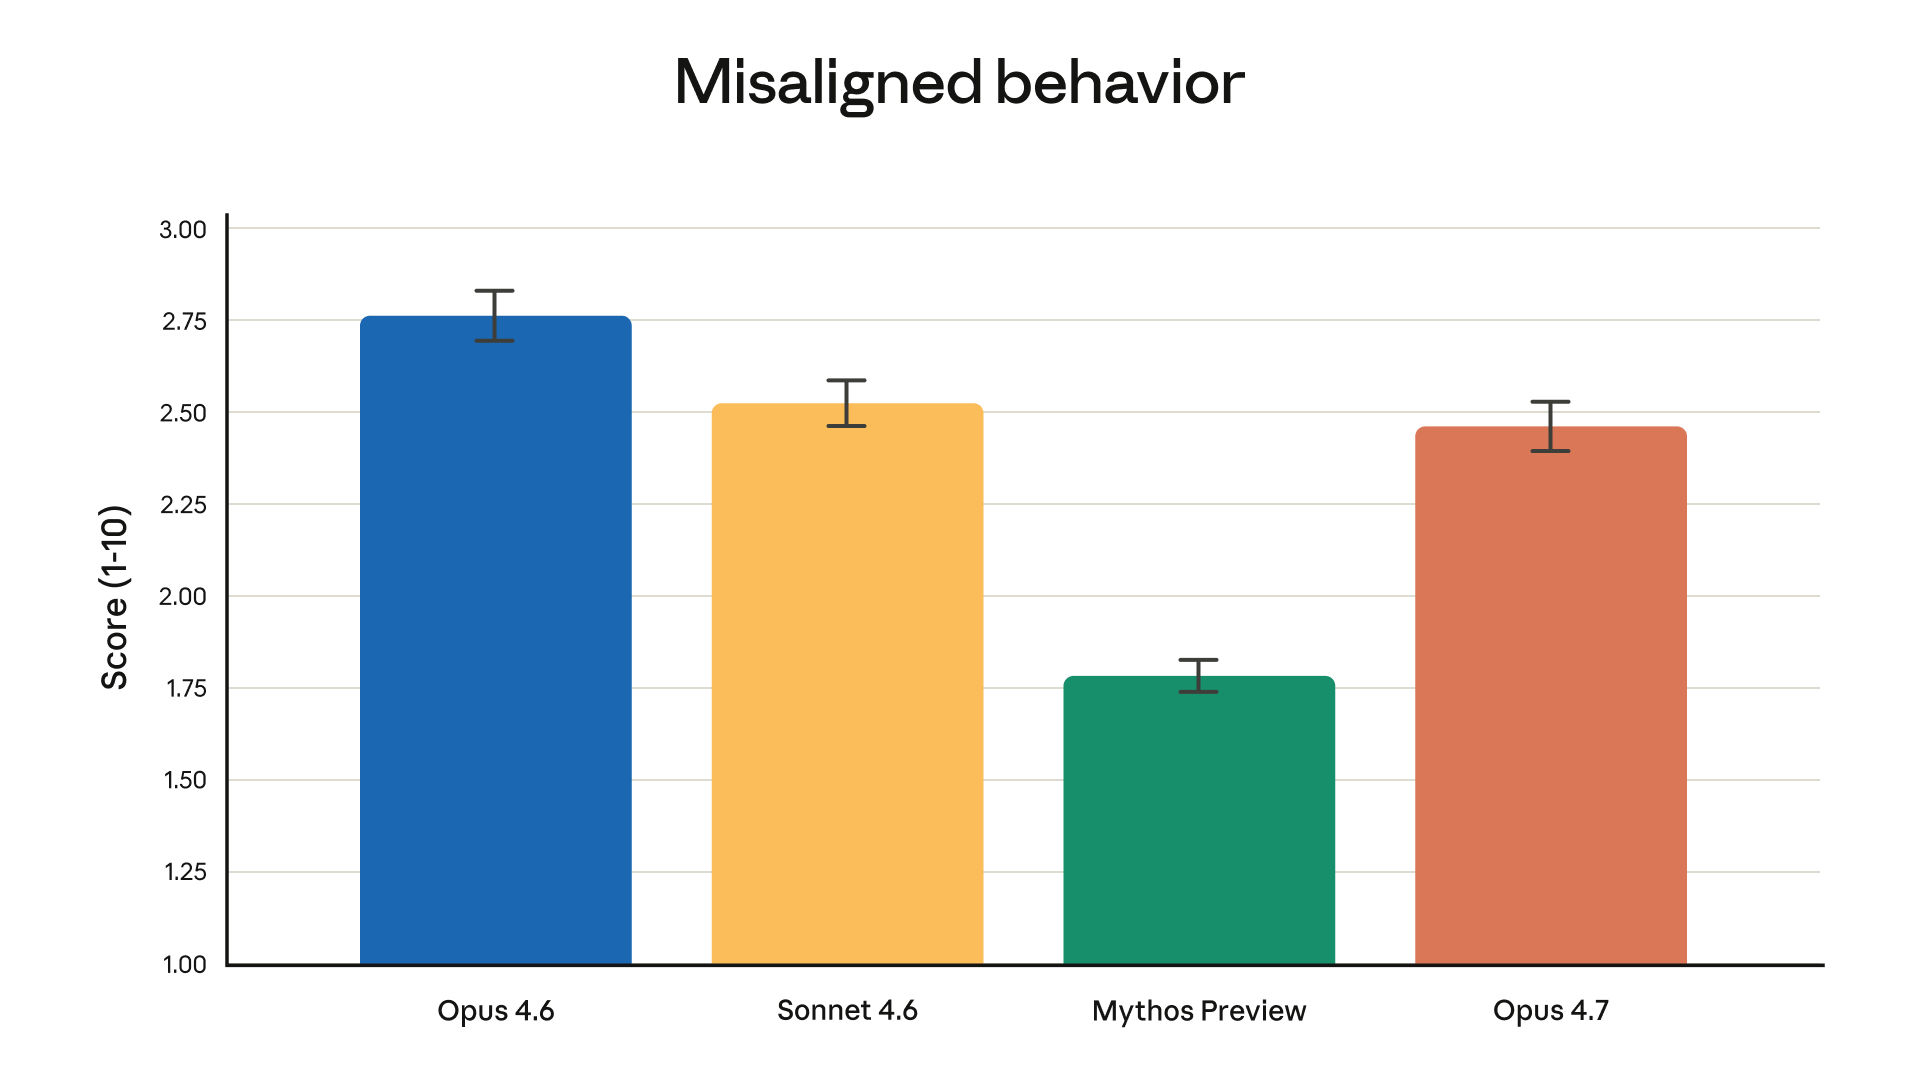
Opus 4.7 có safety profile tương tự Opus 4.6:
Cải thiện so với 4.6:
- Honesty (trung thực hơn)
- Kháng prompt injection attacks
Nhược điểm nhỏ:
- Đôi khi đưa ra harm-reduction advice quá chi tiết về controlled substances
Anthropic kết luận model là "largely well-aligned and trustworthy, though not fully ideal in its behavior". Mythos Preview vẫn là model được align tốt nhất theo đánh giá của Anthropic.
Cybersecurity safeguards
Opus 4.7 là model đầu tiên được trang bị safeguards tự động phát hiện và chặn các yêu cầu liên quan đến cybersecurity bị cấm hoặc rủi ro cao. Anthropic giải thích đây là bước chuẩn bị cho việc release rộng rãi Mythos-class models.
Security professionals muốn dùng Opus 4.7 cho legitimate cybersecurity (vulnerability research, pen testing, red-teaming) có thể đăng ký Cyber Verification Program.
6. Tính năng mới đi kèm
6.1 Task Budgets (Public Beta)
Tính năng mới trên Claude Platform (API): developer có thể hướng dẫn token spend của Claude để model ưu tiên công việc qua các run dài hơn. Hữu ích cho agentic workflows cần kiểm soát chi phí.
6.2 /ultrareview trong Claude Code
Slash command mới tạo một review session chuyên dụng đọc qua toàn bộ code changes và flag bugs + design issues mà một reviewer kỹ tính sẽ bắt được.
- Pro và Max users được 3 ultrareviews miễn phí để thử
- Anthropic đã nâng default effort lên
xhighcho Claude Code trên mọi plan
6.3 Auto Mode cho Max Users
Auto mode là tùy chọn permissions mới: Claude tự ra quyết định thay mặt bạn, cho phép chạy task dài hơn với ít interruptions hơn và ít rủi ro hơn skip-all-permissions.
7. Pricing & Availability
| Chi tiết | Thông tin |
|---|---|
| Giá input | $5 / triệu token |
| Giá output | $25 / triệu token |
| So với Opus 4.6 | Không đổi |
| API model ID | claude-opus-4-7 |
| Claude.ai | ✅ Tất cả plans |
| Claude API | ✅ Available |
| Amazon Bedrock | ✅ Available |
| Google Cloud Vertex AI | ✅ Available |
| Microsoft Foundry | ✅ Available |
8. Migration từ Opus 4.6: Những điều cần biết
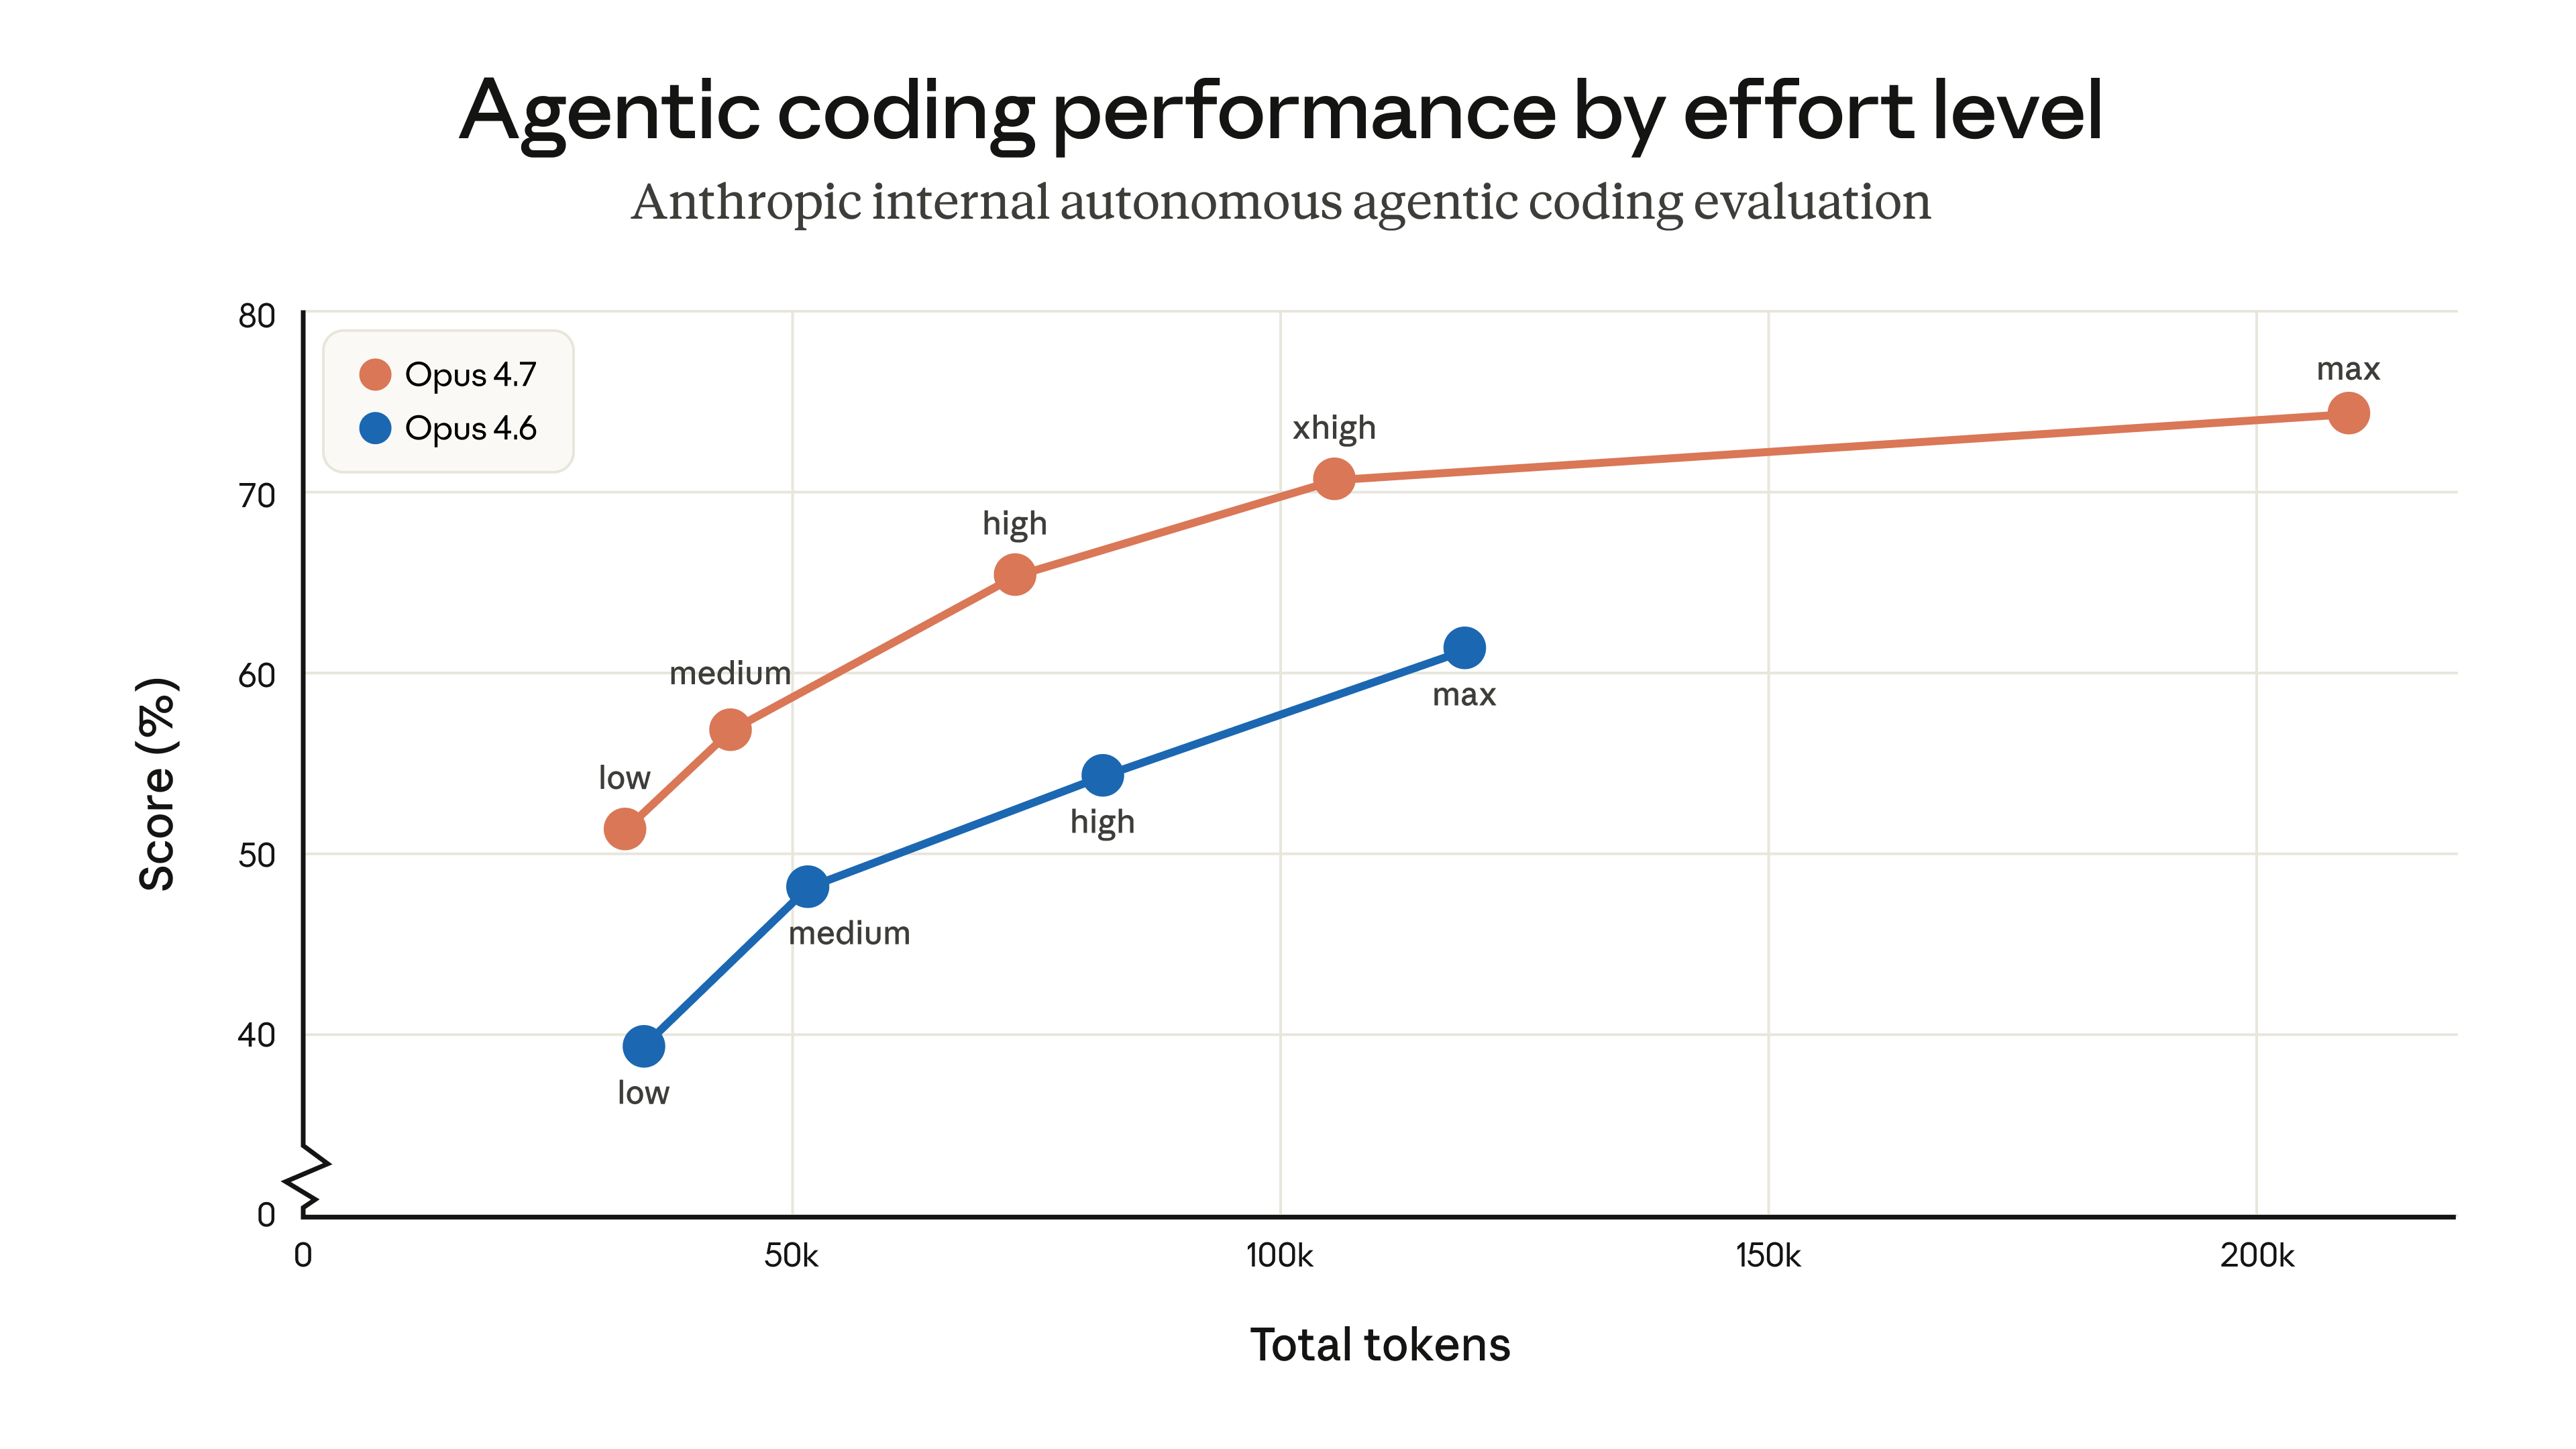
Opus 4.7 là direct upgrade của Opus 4.6, nhưng có hai thay đổi ảnh hưởng đến token usage cần lên kế hoạch:
8.1 Tokenizer mới
Opus 4.7 dùng tokenizer cải tiến, xử lý text hiệu quả hơn. Đánh đổi: cùng một input có thể map tới nhiều token hơn --- khoảng 1.0–1.35× tùy loại nội dung.
8.2 Think nhiều hơn ở effort cao
Opus 4.7 "suy nghĩ" nhiều hơn ở effort levels cao, đặc biệt các turn sau trong agentic settings. Cải thiện độ tin cậy, nhưng tạo ra nhiều output tokens hơn.
Cách kiểm soát token usage
- Dùng effort parameter (xuống
mediumhoặclownếu không cần độ chính xác tối đa) - Điều chỉnh task budgets
- Prompt model rõ ràng hơn về conciseness
Kết quả thực tế tốt hơn: Trong internal coding evaluation, token usage tổng thể trên mọi effort levels đều cải thiện so với Opus 4.6. Nhưng Anthropic khuyến nghị đo lường trên traffic thực của bạn.
Xem thêm Migration Guide chính thức.
9. So sánh với các đối thủ
| Model | Điểm mạnh | Yếu điểm tương đối |
|---|---|---|
| Claude Opus 4.7 | Coding agentic, vision, instruction-following, long-horizon | Ít toàn năng hơn Mythos Preview |
| GPT-5.4 | Toàn năng, ecosystem rộng | Thua Opus 4.7 trên coding benchmarks cụ thể |
| Gemini 3.1 Pro | Multimodal native, tích hợp Google | Thua trên agentic coding tasks |
| Claude Mythos Preview | Toàn năng nhất, best-aligned | Access hạn chế, cyber safeguards chưa đầy đủ |
10. Nên dùng Opus 4.7 cho tác vụ nào?
✅ Rất phù hợp
- Agentic coding: CI/CD automation, long-running debugging sessions, code review
- Multi-step agent workflows: tác nhân nghiên cứu, orchestration phức tạp
- Vision tasks: phân tích screenshot dày đặc, sơ đồ kỹ thuật, hồ sơ khoa học
- Document analysis: pháp lý, tài chính, enterprise documents
- Professional content: presentation, dashboard, report generation
⚠️ Cân nhắc
- Simple Q&A: Sonnet 4.6 đủ dùng và rẻ hơn nhiều
- High-volume simple tasks: Claude Haiku tiết kiệm hơn
- Cần model mạnh nhất tuyệt đối: Chờ Mythos Preview release rộng hơn
Kết luận
Claude Opus 4.7 là bước tiến thực sự đáng kể của Anthropic trong năm 2026. Không phải là model "all-rounder" mạnh nhất thị trường (Mythos Preview vẫn giữ ngôi đó), nhưng cho coding nâng cao, agentic workflows, và vision --- Opus 4.7 đang đặt ra tiêu chuẩn mới.
Điểm đặc biệt là pricing không thay đổi ($5/$25 per M tokens) trong khi hiệu năng tăng rõ rệt. Kết hợp với xhigh effort level, task budgets, và /ultrareview trong Claude Code --- đây là bộ công cụ đáng để các engineering team và developers nghiêm túc xem xét ngay hôm nay.
Nguồn chính: Anthropic Blog — Introducing Claude Opus 4.7 (16/4/2026) | Claude Opus 4.7 System Card | API Documentation