OMOP ETL はプロジェクト中で最も難しく、最も時間のかかる部分です。良いニュース:OHDSI コミュニティはプロセスとツールセットを標準化済みです。本記事ではソースのプロファイリングから本番デプロイまでをガイドします。
1. OHDSI 標準プロセス
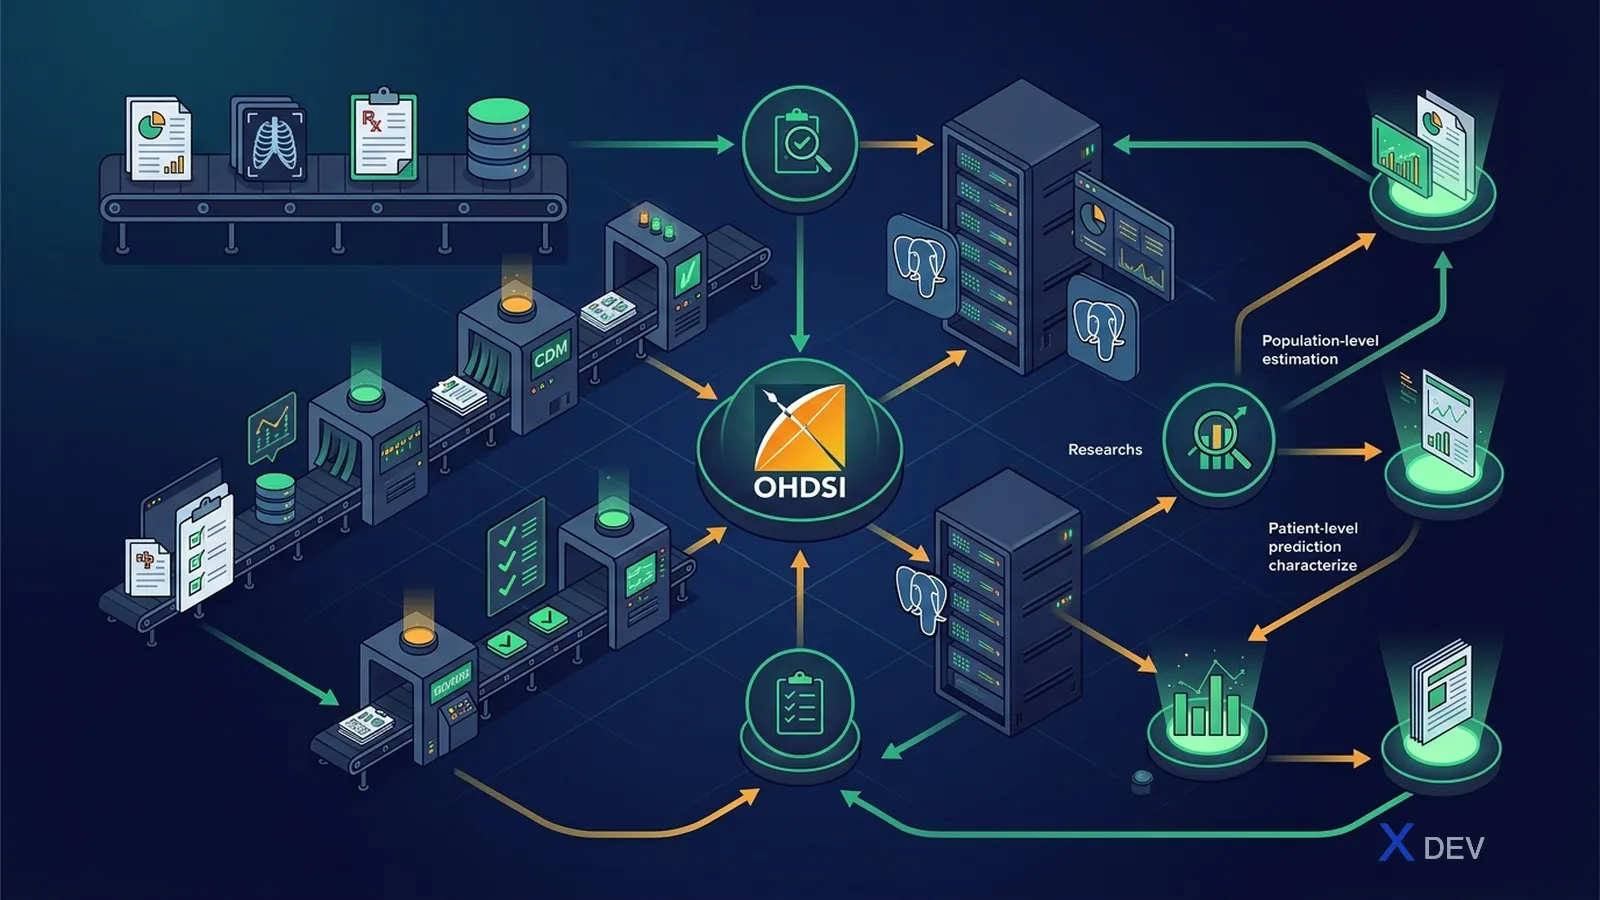
7 ステップ:
- WhiteRabbit でソースをプロファイル
- RabbitInAHat でテーブルレベルマッピングを設計
- USAGI でコード(vocabulary)をマッピング
- ETL 仕様書を作成
- SQL / dbt / Perseus で ETL を実装
- DQD + ACHILLES でバリデーション
- デプロイ + インクリメンタルスケジューリング
2. WhiteRabbit — ソースプロファイリング
WhiteRabbit は Java 製のツールで、ソース DB(Postgres、Oracle、SQL Server、MySQL など)をスキャンし、HTML レポートを生成します:
- テーブル一覧 + 行数
- 各カラムのデータ型、distinct 値数、上位 100 値の頻度、NULL 率
- テーブルごとの CSV/Excel ファイル
# インストール
wget https://github.com/OHDSI/WhiteRabbit/releases/download/v0.10.x/WhiteRabbit_v0.10.x.zip
unzip WhiteRabbit_v0.10.x.zip
cd WhiteRabbit
./bin/whiteRabbit.sh
GUI:
- Source:PostgreSQL、サーバ、user、pass、schema
- Working folder:レポート出力先
- Tables to scan:すべてまたは subset を選択
- "Scan tables" → 数分後に
ScanReport.xlsxが出力される
2.1 Scan Report の読み方
xlsx の各タブ = 1 つのソーステーブル。カラム:
Field= カラム名Type= データ型N rows= 行数Distinct values= ユニーク数Frequency= 上位値 + カウント
注意すべき警告:
- 「ICD code」カラムが 80% フリーテキスト → 問題あり
- 日付カラムの 30% が
1900-01-01→ デフォルト埋め、NULL として扱う genderが "M/F" のみだが追加で 2% の "U" がある → 処理が必要
2.2 ベストプラクティス
- ETL 対象が subset でも、全テーブルをスキャン(全体像を把握)
- Scan Report を Git に保存(匿名化)— これが核心ドキュメント
- ソースデータは変化するので四半期ごとに再スキャン
3. RabbitInAHat — マッピング設計
ソーステーブル → CDM テーブルのマッピングをドラッグ&ドロップで描くツール。
./bin/rabbitInAHat.sh
ワークフロー:
- File → Open Scan Report(生成した xlsx)
- File → Open CDM(バージョン 5.4 を選択)
- ソーステーブルを CDM テーブルへドラッグ → 視覚的なつながり
- 線をクリック → 説明を記入(なぜマッピングするか、どう変換するか)
- カラムレベルを source → CDM column へドラッグ
- File → Generate ETL Document → Word/Markdown ファイル出力
3.1 マッピング例(ベトナム HIS → OMOP)
| ソース HIS | OMOP CDM | 注記 |
|---|---|---|
bn_dangky.id_bn | PERSON.person_id | CCCD を pseudonymize |
bn_dangky.gioi_tinh | PERSON.gender_concept_id | M=8507, F=8532 |
bn_dangky.ngay_sinh | PERSON.year_of_birth + birth_datetime | |
kham_benh.ma_kham | VISIT_OCCURRENCE.visit_occurrence_id | |
kham_benh.loai_kham | VISIT_OCCURRENCE.visit_concept_id | NT=9201, NgT=9202, CC=9203 |
chan_doan.icd10 | CONDITION_OCCURRENCE.condition_concept_id(SNOMED マップ経由) | + condition_source_value="E11.9" |
don_thuoc.ma_thuoc_byt | DRUG_EXPOSURE.drug_concept_id(USAGI で RxNorm にマップ) | |
xet_nghiem.ma_xn | MEASUREMENT.measurement_concept_id(LOINC) | value_as_number, unit_concept_id |
3.2 ETL Spec は生きたドキュメント
OHDSI 標準フォーマット:
- CDM テーブルごとにセクション
- マッピング表(source カラム → CDM カラム、変換ルール)
- エッジケース(NULL、デフォルト、ルックアップ)
- Concept マッピング参照(USAGI セッションへのリンク)
Git に保存し、データリフレッシュごとにバージョン管理。
4. USAGI — コードマッピング
Vocabulary deep dive で紹介済み。ワークフロー再掲:
4.1 ベストプラクティス
- 頻度 でマッピング:上位 100 ICD-10 = ボリュームの 80% → 優先
- 重要コードは独立 2 名のレビュアー + reconcile
- 出力 CSV を Git に保存
- カスタム concept(例:「ESC 2018 に基づく高血圧 Stage 1」)→ 20 億以上の Concept ID で作成
4.2 出力ファイル → SOURCE_TO_CONCEPT_MAP
INSERT INTO source_to_concept_map (
  source_code, source_concept_id, source_vocabulary_id,
  source_code_description, target_concept_id, target_vocabulary_id,
  valid_start_date, valid_end_date, invalid_reason
)
SELECT
  source_code, 0, 'ICD10VN',
  source_name, target_concept_id, 'SNOMED',
  '2026-01-01', '2099-12-31', NULL
FROM external_usagi_export;
5. 実装:SQL アプローチ
原則:ETL は冪等で、安全に再実行できること。
-- Step 1: Truncate またはパーティションスワップ
TRUNCATE TABLE cdm.person;

-- Step 2: ソースから INSERT(FDW またはステージング経由)
INSERT INTO cdm.person (
  person_id, gender_concept_id, year_of_birth, race_concept_id,
  ethnicity_concept_id, person_source_value, gender_source_value
)
SELECT
  ROW_NUMBER() OVER (ORDER BY src.id_bn) AS person_id,
  CASE src.gioi_tinh
    WHEN 'M' THEN 8507
    WHEN 'F' THEN 8532
    ELSE 0
  END,
  EXTRACT(YEAR FROM src.ngay_sinh)::INT,
  0,  -- race unknown(またはベトナム custom concept)
  0,
  -- CCCD を pseudonymize
  encode(hmac(src.cccd::bytea, 'secret-key'::bytea, 'sha256'), 'hex'),
  src.gioi_tinh
FROM staging.bn_dangky src;

-- Step 3: 他テーブルでルックアップするため PERSON_MAP を構築
CREATE TABLE cdm.person_map AS
SELECT id_bn AS source_id, person_id
FROM cdm.person
JOIN staging.bn_dangky USING (...);
5.1 Standard concept ルックアップパターン
INSERT INTO cdm.condition_occurrence (
  condition_occurrence_id, person_id, condition_concept_id,
  condition_start_date, condition_type_concept_id,
  condition_source_value, condition_source_concept_id, visit_occurrence_id
)
SELECT
  ROW_NUMBER() OVER () AS condition_occurrence_id,
  pm.person_id,
  COALESCE(cr.target_concept_id, 0) AS condition_concept_id,
  src.ngay_chan_doan,
  32020 AS condition_type_concept_id,
  src.icd10 AS condition_source_value,
  src_concept.concept_id AS condition_source_concept_id,
  vm.visit_occurrence_id
FROM staging.chan_doan src
JOIN cdm.person_map pm ON src.id_bn = pm.source_id
JOIN cdm.visit_map vm ON src.ma_kham = vm.source_id
LEFT JOIN concept src_concept
  ON src_concept.vocabulary_id = 'ICD10CM'
  AND src_concept.concept_code = src.icd10
LEFT JOIN concept_relationship cr
  ON cr.concept_id_1 = src_concept.concept_id
  AND cr.relationship_id = 'Maps to'
LEFT JOIN concept tgt
  ON cr.concept_id_2 = tgt.concept_id
  AND tgt.standard_concept = 'S';
6. 実装:dbt アプローチ(モダン)
dbt = SQL + Jinja + バージョン管理 + テスト。2026 年で一般的なパターン:
dbt_project/
├── models/
│   ├── staging/
│   │   ├── stg_bn_dangky.sql
│   │   ├── stg_kham_benh.sql
│   │   └── stg_chan_doan.sql
│   ├── intermediate/
│   │   ├── int_person_map.sql
│   │   └── int_visit_map.sql
│   └── cdm/
│       ├── person.sql
│       ├── visit_occurrence.sql
│       ├── condition_occurrence.sql
│       └── ...
├── tests/
│   └── cdm_constraints.sql
└── dbt_project.yml
6.1 dbt モデル例
-- models/cdm/condition_occurrence.sql
{{ config(materialized='table') }}

WITH source AS (
  SELECT * FROM {{ ref('stg_chan_doan') }}
),
mapping AS (
  SELECT * FROM {{ ref('int_icd10_to_snomed') }}
),
person_map AS (
  SELECT * FROM {{ ref('int_person_map') }}
)
SELECT
  ROW_NUMBER() OVER () AS condition_occurrence_id,
  pm.person_id,
  COALESCE(m.target_concept_id, 0) AS condition_concept_id,
  s.ngay_chan_doan AS condition_start_date,
  32020 AS condition_type_concept_id,
  s.icd10 AS condition_source_value
FROM source s
JOIN person_map pm ON s.id_bn = pm.source_id
LEFT JOIN mapping m ON s.icd10 = m.source_code
6.2 dbt テスト
# models/cdm/schema.yml
version: 2
models:
  - name: condition_occurrence
    columns:
      - name: condition_occurrence_id
        tests: [unique, not_null]
      - name: person_id
        tests:
          - not_null
          - relationships:
              to: ref('person')
              field: person_id
      - name: condition_concept_id
        tests:
          - not_null
          - dbt_utils.accepted_range:
              min_value: 0
7. Perseus — モダンな OHDSI ETL ツール
Perseus は Web ツール(OHDSI EHDEN コミュニティ)で、徐々に RabbitInAHat を置き換えつつあります:
- よりモダンなドラッグ&ドロップ UI
- dbt/SQL コード生成
- マッピングをコラボ用 DB に保存
- USAGI と DQD を統合
- Docker compose で簡単デプロイ
git clone https://github.com/OHDSI/Perseus
cd Perseus
docker compose up
# localhost:80 にアクセス
8. インクリメンタル ETL
HIS データセットは大規模 → 毎晩フル ETL は非現実的。インクリメンタルパターン:
注意:
- ソースで
updated_atを追跡 — なければトリガまたは CDC(Debezium)を追加 - 変更された person については Drug_Era / Condition_Era を再計算
- ETL 時点で使用した vocabulary バージョンをスナップショット(concept_id は安定だが
Maps toは変わる)
9. ETL のバリデーション
3 層:
- dbt tests(relationships、unique、not_null)— 各 ETL ごとに実行
- Data Quality Dashboard — 3000+ ルールで自動、毎週実行
- ACHILLES — 記述レポート、履歴と比較
詳細は ATLAS、Data Quality Dashboard と ACHILLES を参照。
10. パフォーマンス Tip
| 課題 | 対策 |
|---|---|
| ETL が遅い | INSERT を bulk COPY に、person_id range で並列パーティション |
| Vocabulary ルックアップが遅い | source_to_standard ルックアップテーブルをマテリアライズ |
| Concept_ancestor クエリがフルスキャン | よく使うコホート用に "diabetes_descendant_set" をマテリアライズ |
| Drug_Era 再計算が遅い | 変更された person のみインクリメンタル計算 |
| 巨大データ(1000 万 person 以上) | CDM を年または person_id range でパーティション |
11. CI/CD パターン
# .github/workflows/etl.yml
name: OMOP ETL Daily
on:
  schedule:
    - cron: '0 2 * * *'  # 2 AM UTC = 9 AM ベトナム
jobs:
  etl:
    runs-on: self-hosted  # ソース DB へのネットワーク内アクセス
    steps:
      - uses: actions/checkout@v4
      - run: dbt deps
      - run: dbt seed
      - run: dbt run --target prod
      - run: dbt test --target prod
      - name: Run DQD
        run: Rscript scripts/run_dqd.R
      - name: Notify Slack
        if: failure()
        uses: ...
12. 保存すべきドキュメント
- ETL Specification(Git 内の Markdown)
- Scan Report(xlsx、匿名化)
- USAGI セッションファイル
- SOURCE_TO_CONCEPT_MAP
- 実行ごとの DQD レポート
- ACHILLES 履歴
- Vocabulary バージョンログ
13. アンチパターン
- ❌ Python/Pandas でアドホックな ETL を spec 無しで → 再現不能
- ❌ コードにマッピングをハードコード → 保健省リスト変更時に困難
- ❌ 妥当性検証をしない → データが大きくなると DQD がエラー
- ❌ インクリメンタル ETL を忘れる → 一晩 8 時間が変わらないデータの再処理
- ❌ Vocabulary をスナップショットしない → 半年前の解析を再現できない
- ❌ 階層を見ずに 1 対 1 でマッピング → コンテキストが失われる
まとめ
OMOP ETL はタスクではなくプロジェクトです。正しいワークフロー(WhiteRabbit → RabbitInAHat → USAGI → dbt + DQD)に投資すれば、自由形式に比べて数ヶ月節約できます。最も重要なのは、すべてのマッピング判断をドキュメント化することです。
次の記事:ATLAS、Data Quality Dashboard と ACHILLES — OMOP analytics の運用。