OMOP ETL 是專案中最困難、最耗時的部分。好消息:OHDSI 社群已將流程與工具標準化。本文從 profile source 到 production deploy 一一說明。
1. 標準 OHDSI 流程
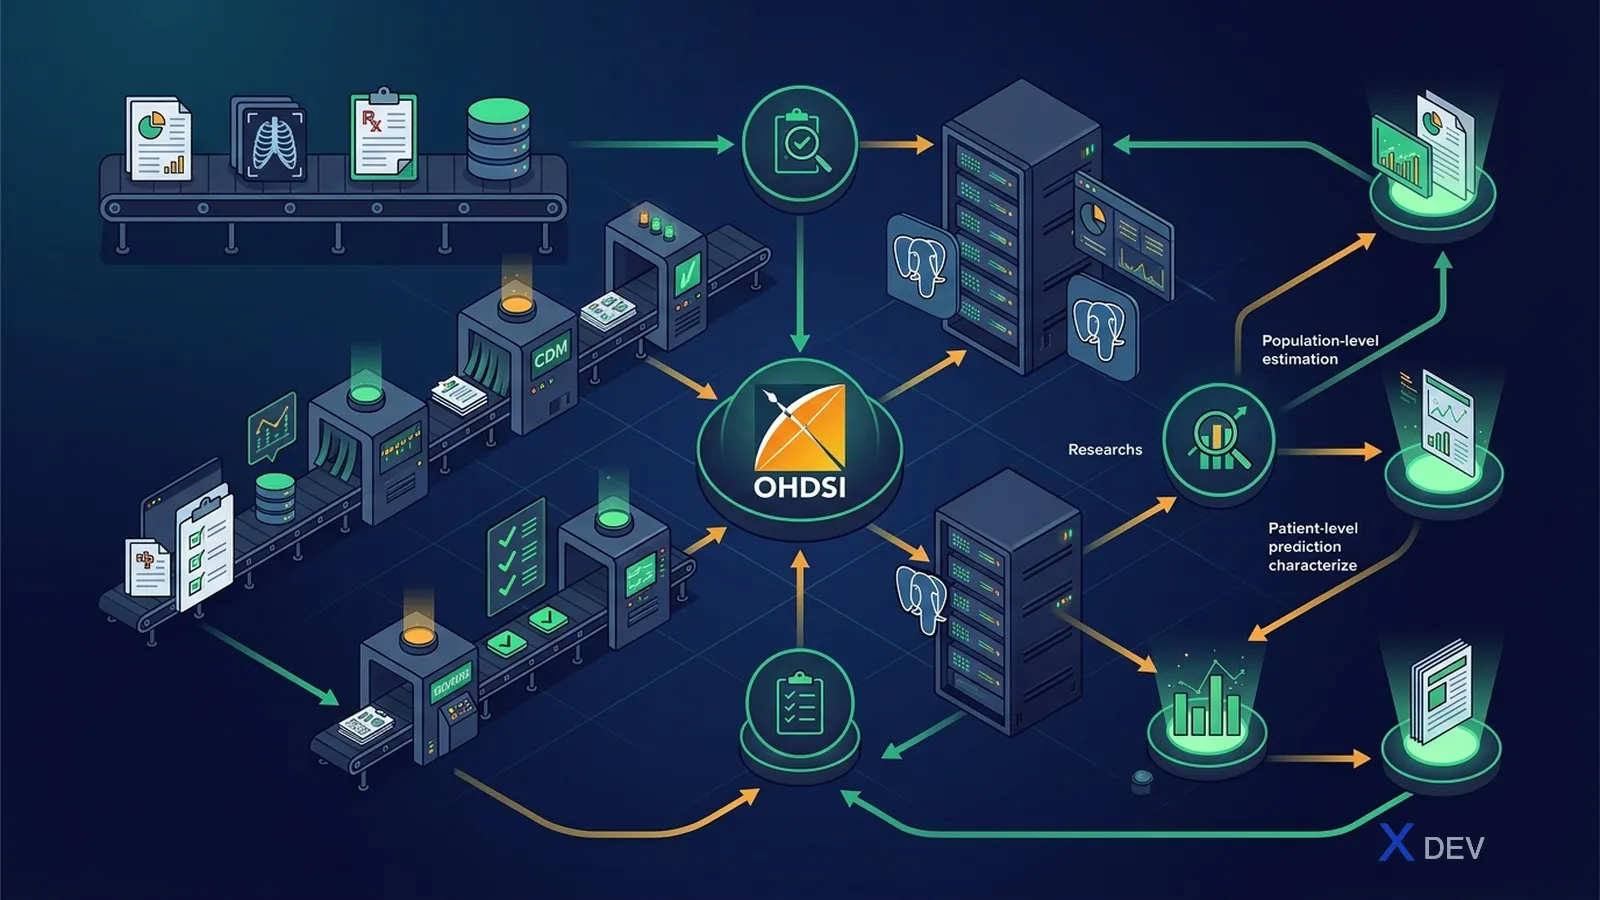
7 個標準步驟:
- 用 WhiteRabbit 對來源做 profile
- 用 RabbitInAHat 設計 table 層級對應
- 用 USAGI 對應代碼(詞彙)
- 撰寫 ETL 規格文件
- 以 SQL/dbt/Perseus 實作 ETL
- 用 DQD + ACHILLES 驗證
- 部署 + 安排 incremental 排程
2. WhiteRabbit — 來源 profile
WhiteRabbit 是 Java 工具,可掃描來源資料庫(Postgres、Oracle、SQL Server、MySQL 等),並產出 HTML 報告:
- 列出資料表 + row count
- 每欄:資料型態、distinct value 數、top 100 value frequency、% null
- 每張資料表的 CSV/Excel 檔
# 安裝
wget https://github.com/OHDSI/WhiteRabbit/releases/download/v0.10.x/WhiteRabbit_v0.10.x.zip
unzip WhiteRabbit_v0.10.x.zip
cd WhiteRabbit
./bin/whiteRabbit.sh
GUI:
- Source:PostgreSQL、server、user、pass、schema
- Working folder:報告輸出位置
- Tables to scan:全選或子集
- 「Scan tables」→ 數分鐘後產生
ScanReport.xlsx
2.1 閱讀 Scan Report
xlsx 中每個分頁 = 1 張來源資料表。欄位:
Field= 欄名Type= 資料型態N rows= 列數Distinct values= 唯一值數Frequency= top values + count
需注意的警示:
- 「ICD code」欄但 80% distinct 都是自由文字 → 有問題
- 日期欄但 30% 是
1900-01-01→ 預設填入,視為 null gender欄只有「M/F」,卻多了 2% 的「U」 → 需處理
2.2 最佳實務
- 即使 ETL 只做子集,也要掃描所有資料表(掌握全貌)
- 將 Scan Report 存入 Git(去識別化) — 這是核心文件
- 每季重新掃描,因為來源資料會變動
3. RabbitInAHat — 設計對應
拖放工具,用以視覺化繪製來源資料表 → CDM 資料表的對應。
./bin/rabbitInAHat.sh
工作流程:
- File → Open Scan Report(剛才產生的 xlsx)
- File → Open CDM(選 5.4 版)
- 從來源資料表拖放至 CDM 資料表 → 視覺連線
- 點擊連線 → 撰寫描述(為何對應、如何轉換)
- 拖放欄位層級的對應 source → CDM column
- File → Generate ETL Document → 輸出 Word/Markdown
3.1 對應範例(越南 HIS → OMOP)
| 來源 HIS | OMOP CDM | 備註 |
|---|---|---|
bn_dangky.id_bn | PERSON.person_id | 假名化身分證字號 |
bn_dangky.gioi_tinh | PERSON.gender_concept_id | M=8507、F=8532 |
bn_dangky.ngay_sinh | PERSON.year_of_birth + birth_datetime | |
kham_benh.ma_kham | VISIT_OCCURRENCE.visit_occurrence_id | |
kham_benh.loai_kham | VISIT_OCCURRENCE.visit_concept_id | 住院=9201、門診=9202、急診=9203 |
chan_doan.icd10 | CONDITION_OCCURRENCE.condition_concept_id(透過 SNOMED 對應) | + condition_source_value="E11.9" |
don_thuoc.ma_thuoc_byt | DRUG_EXPOSURE.drug_concept_id(透過 USAGI 對應到 RxNorm) | |
xet_nghiem.ma_xn | MEASUREMENT.measurement_concept_id(LOINC) | value_as_number、unit_concept_id |
3.2 ETL 規格是活文件
OHDSI 標準格式:
- 每張 CDM 資料表一節
- 對應表(source 欄 → CDM 欄、轉換規則)
- 邊界情況(NULL、預設、查表)
- 概念對應參考(連結 USAGI session)
存入 Git,每次資料 refresh 同步版本。
4. USAGI — 代碼對應
已於 Vocabulary 深入剖析 介紹。重申流程:
4.1 最佳實務
- 依 frequency 對應:top 100 ICD-10 = 80% volume → 優先
- 重要代碼用 2 位獨立 reviewer + reconcile
- 將輸出 CSV 存入 Git
- Custom concept(例如「依 ESC 2018 的第 1 期高血壓」) → 建立 20 億以上 Concept ID
4.2 輸出檔 → SOURCE_TO_CONCEPT_MAP
INSERT INTO source_to_concept_map (
  source_code, source_concept_id, source_vocabulary_id,
  source_code_description, target_concept_id, target_vocabulary_id,
  valid_start_date, valid_end_date, invalid_reason
)
SELECT
  source_code, 0, 'ICD10VN',
  source_name, target_concept_id, 'SNOMED',
  '2026-01-01', '2099-12-31', NULL
FROM external_usagi_export;
5. 實作:SQL 方式
原則:ETL 必須 idempotent,可安全重跑。
-- Step 1: Truncate 或 partition swap
TRUNCATE TABLE cdm.person;

-- Step 2: 從來源(透過 FDW 或 staging)插入
INSERT INTO cdm.person (
  person_id, gender_concept_id, year_of_birth, race_concept_id,
  ethnicity_concept_id, person_source_value, gender_source_value
)
SELECT
  ROW_NUMBER() OVER (ORDER BY src.id_bn) AS person_id,
  CASE src.gioi_tinh
    WHEN 'M' THEN 8507
    WHEN 'F' THEN 8532
    ELSE 0
  END,
  EXTRACT(YEAR FROM src.ngay_sinh)::INT,
  0,  -- race unknown(或越南 custom concept)
  0,
  -- 假名化身分證字號
  encode(hmac(src.cccd::bytea, 'secret-key'::bytea, 'sha256'), 'hex'),
  src.gioi_tinh
FROM staging.bn_dangky src;

-- Step 3: 建立 PERSON_MAP 供其他資料表查詢
CREATE TABLE cdm.person_map AS
SELECT id_bn AS source_id, person_id
FROM cdm.person
JOIN staging.bn_dangky USING (...);
5.1 查詢 standard concept 的模式
INSERT INTO cdm.condition_occurrence (
  condition_occurrence_id, person_id, condition_concept_id,
  condition_start_date, condition_type_concept_id,
  condition_source_value, condition_source_concept_id, visit_occurrence_id
)
SELECT
  ROW_NUMBER() OVER () AS condition_occurrence_id,
  pm.person_id,
  COALESCE(cr.target_concept_id, 0) AS condition_concept_id,
  src.ngay_chan_doan,
  32020 AS condition_type_concept_id,
  src.icd10 AS condition_source_value,
  src_concept.concept_id AS condition_source_concept_id,
  vm.visit_occurrence_id
FROM staging.chan_doan src
JOIN cdm.person_map pm ON src.id_bn = pm.source_id
JOIN cdm.visit_map vm ON src.ma_kham = vm.source_id
LEFT JOIN concept src_concept
  ON src_concept.vocabulary_id = 'ICD10CM'
  AND src_concept.concept_code = src.icd10
LEFT JOIN concept_relationship cr
  ON cr.concept_id_1 = src_concept.concept_id
  AND cr.relationship_id = 'Maps to'
LEFT JOIN concept tgt
  ON cr.concept_id_2 = tgt.concept_id
  AND tgt.standard_concept = 'S';
6. 實作:dbt 方式(現代)
dbt = SQL + Jinja + 版本控制 + 測試。2026 年的常見模式:
dbt_project/
├── models/
│   ├── staging/
│   │   ├── stg_bn_dangky.sql
│   │   ├── stg_kham_benh.sql
│   │   └── stg_chan_doan.sql
│   ├── intermediate/
│   │   ├── int_person_map.sql
│   │   └── int_visit_map.sql
│   └── cdm/
│       ├── person.sql
│       ├── visit_occurrence.sql
│       ├── condition_occurrence.sql
│       └── ...
├── tests/
│   └── cdm_constraints.sql
└── dbt_project.yml
6.1 dbt model 範例
-- models/cdm/condition_occurrence.sql
{{ config(materialized='table') }}

WITH source AS (
  SELECT * FROM {{ ref('stg_chan_doan') }}
),
mapping AS (
  SELECT * FROM {{ ref('int_icd10_to_snomed') }}
),
person_map AS (
  SELECT * FROM {{ ref('int_person_map') }}
)
SELECT
  ROW_NUMBER() OVER () AS condition_occurrence_id,
  pm.person_id,
  COALESCE(m.target_concept_id, 0) AS condition_concept_id,
  s.ngay_chan_doan AS condition_start_date,
  32020 AS condition_type_concept_id,
  s.icd10 AS condition_source_value
FROM source s
JOIN person_map pm ON s.id_bn = pm.source_id
LEFT JOIN mapping m ON s.icd10 = m.source_code
6.2 dbt 測試
# models/cdm/schema.yml
version: 2
models:
  - name: condition_occurrence
    columns:
      - name: condition_occurrence_id
        tests: [unique, not_null]
      - name: person_id
        tests:
          - not_null
          - relationships:
              to: ref('person')
              field: person_id
      - name: condition_concept_id
        tests:
          - not_null
          - dbt_utils.accepted_range:
              min_value: 0
7. Perseus — 現代 OHDSI ETL 工具
Perseus 是 OHDSI EHDEN 社群推出的 web 工具,逐步取代 RabbitInAHat:
- 更現代的拖放 UI
- 產出 dbt/SQL 程式
- 將對應存入 DB 以利協作
- 整合 USAGI 與 DQD
- Docker compose 易於部署
git clone https://github.com/OHDSI/Perseus
cd Perseus
docker compose up
# 連到 localhost:80
8. Incremental ETL
HIS 資料集大 → 不可能每晚重跑全量。Incremental 模式:
注意事項:
- 在來源追蹤
updated_at— 若沒有 → 加 trigger 或 CDC(Debezium) - 變動的 person 須重新計算 Drug_Era / Condition_Era
- ETL 當下使用的詞彙版本要快照(concept_id 雖穩定,但
Maps to會變)
9. 驗證 ETL
3 層:
- dbt tests(relationships、unique、not_null) — 每次 ETL 執行
- Data Quality Dashboard — 3000+ 自動規則,每週執行
- ACHILLES — descriptive 報告,與歷史對比
詳情請見 ATLAS、Data Quality Dashboard 與 ACHILLES。
10. 效能技巧
| 問題 | 解法 |
|---|---|
| ETL 很慢 | 以 Bulk COPY 取代 INSERT,依 person_id 範圍平行分區 |
| 詞彙查詢慢 | 將 source_to_standard 查詢表 Materialize |
| Concept_ancestor 查詢觸發 full scan | 為常用世代 Materialize「diabetes_descendant_set」 |
| Drug_Era 重算耗時 | 只對變動 person 增量計算 |
| 資料大(1000 萬以上 person) | 將 CDM 依年份或 person_id 範圍分割 |
11. CI/CD 模式
# .github/workflows/etl.yml
name: OMOP ETL Daily
on:
  schedule:
    - cron: '0 2 * * *'  # UTC 凌晨 2 點 = 越南上午 9 點
jobs:
  etl:
    runs-on: self-hosted  # 可存取來源 DB 的內網
    steps:
      - uses: actions/checkout@v4
      - run: dbt deps
      - run: dbt seed
      - run: dbt run --target prod
      - run: dbt test --target prod
      - name: Run DQD
        run: Rscript scripts/run_dqd.R
      - name: Notify Slack
        if: failure()
        uses: ...
12. 需保留的文件
- ETL Specification(Git 中的 Markdown)
- Scan Report(xlsx,去識別化)
- USAGI session 檔
- SOURCE_TO_CONCEPT_MAP
- 每次執行的 DQD 報告
- ACHILLES history
- 詞彙版本紀錄
13. 反模式
- ❌ 用 Python/Pandas 隨手寫 ETL,沒有規格 → 不可重現
- ❌ 將對應寫死於程式 → 衛生部目錄變動時難以更新
- ❌ 不做合理性驗證 → 資料量增加後 DQD 報錯
- ❌ 忽略 incremental ETL → 每晚 8 小時只在重複處理沒變的資料
- ❌ 未快照詞彙 → 6 個月後的分析無法重現
- ❌ 1 對 1 對應而忽略階層 → 失去語意脈絡
結論
OMOP ETL 是專案,不是任務。投入正確流程(WhiteRabbit → RabbitInAHat → USAGI → dbt + DQD)能比放任作業節省好幾個月。最關鍵的是:把每個對應決策都記錄下來。
下一篇:ATLAS、Data Quality Dashboard 與 ACHILLES — 營運 OMOP analytics。