この章を飛ばしても OMOP は構築できます — ただし解析結果は常に間違いになります。Vocabulary こそ OMOP に本物の意味を与える 部分です。本記事では Concept、階層、マッピング、Athena ワークフローを深掘りします。
1. なぜ Vocabulary が重要か
実例:3 つのデータソースがあるとします:
- 病院 A:「ICD-10 E11.9」の診断コード
- 病院 B:「ICD-10 E11」のコード
- 病院 C:SNOMED「44054006」のコード
3 つすべて 2 型糖尿病 を指しています。標準化しなければ「2 型糖尿病の患者総数」のクエリは誤った数値を返します。
OMOP は 1 つの Standard Concept(ここでは concept_id = 201826、SNOMED 44054006)を選び、すべての source code をそれにマッピングすることで解決します。
2. Concept — 基本単位
Concept は CONCEPT テーブルの 1 行です:
| concept_id | concept_name | domain_id | vocabulary_id | concept_class_id | standard_concept | concept_code |
|---|---|---|---|---|---|---|
| 201826 | Type 2 diabetes mellitus | Condition | SNOMED | Clinical Finding | S | 44054006 |
| 192279 | Diabetic complication | Condition | SNOMED | Clinical Finding | C | 74627003 |
| 45757466 | E11 (ICD-10-CM) | Condition | ICD10CM | ICD10CM code | (null = Source) | E11 |
standard_concept:
- S(Standard):解析に使用
- C(Classification):分類用、Standard ではない
- NULL(Source):元コード、source_value 保存用
3. Vocabulary と Domain
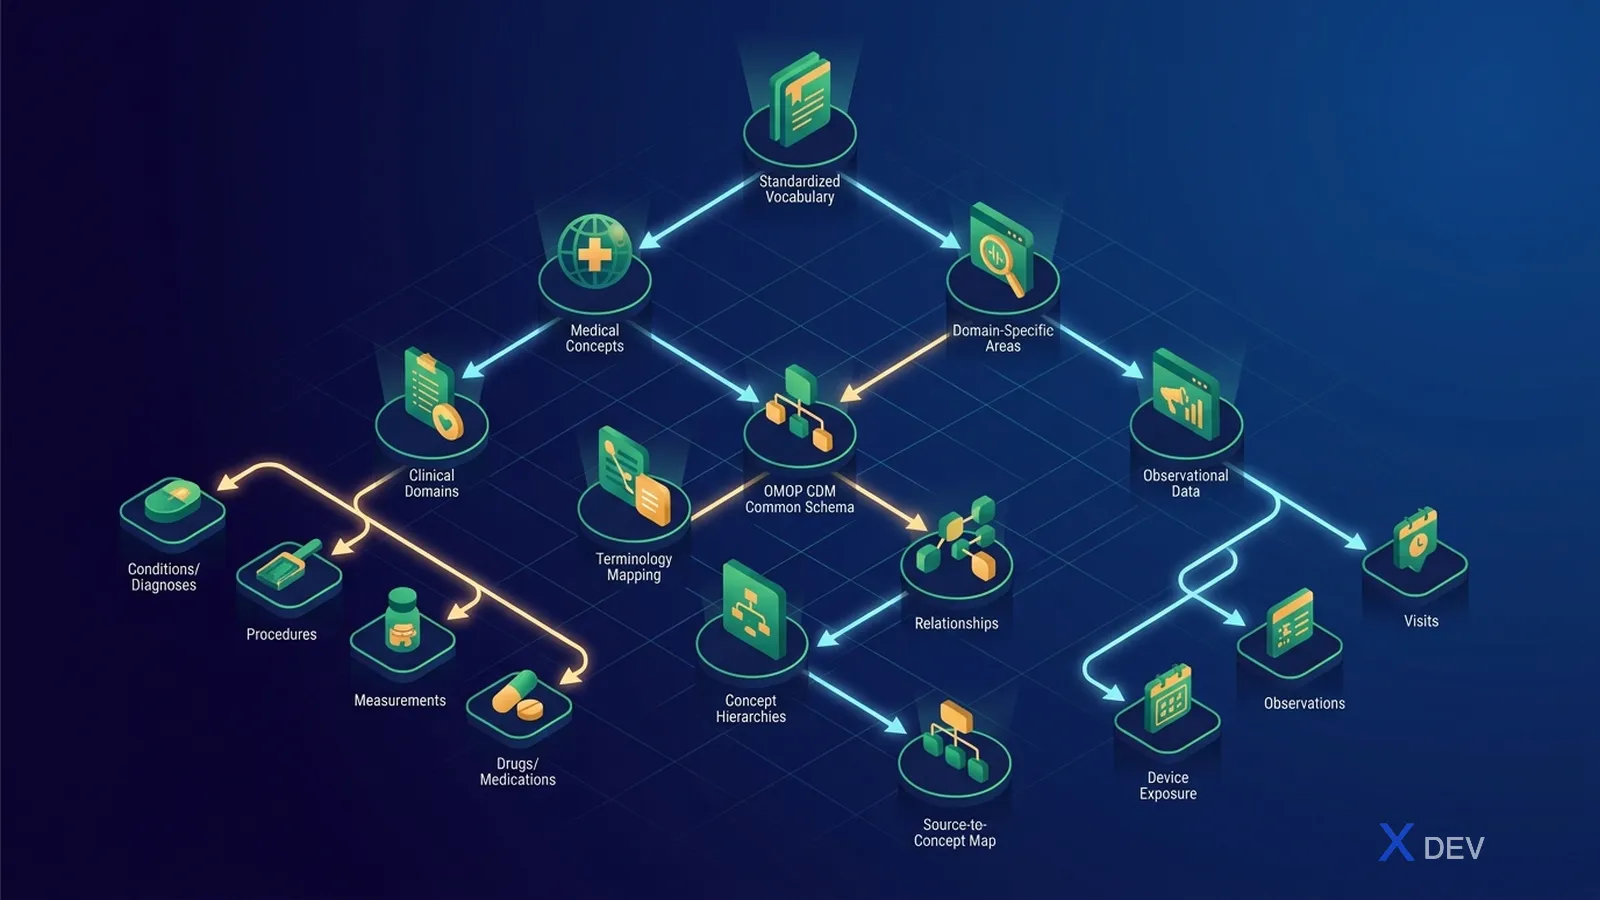
| Domain | OMOP テーブル | 主な Standard Vocabulary |
|---|---|---|
| Condition | CONDITION_OCCURRENCE | SNOMED CT |
| Drug | DRUG_EXPOSURE | RxNorm + RxNorm Extension |
| Procedure | PROCEDURE_OCCURRENCE | SNOMED CT、CPT4、ICD-10-PCS |
| Measurement | MEASUREMENT | LOINC、SNOMED CT |
| Observation | OBSERVATION | SNOMED CT、LOINC |
| Device | DEVICE_EXPOSURE | SNOMED CT |
| Unit | (横断) | UCUM |
| Race / Ethnicity | PERSON | OMOP Custom(ベトナム向けマッピング必要) |
4. Concept Relationship
CONCEPT_RELATIONSHIP テーブルは concept 間の関係を保持します:
| concept_id_1 | concept_id_2 | relationship_id |
|---|---|---|
| 45757466 (ICD10 E11) | 201826 (SNOMED Diabetes T2) | "Maps to" |
| 201826 | 45757466 | "Mapped from" |
| 1503297 (Metformin) | 1503328 (Metformin 500mg tablet) | "Has form" |
Maps to は極めて重要です — source → standard マッピングはこれを使います:
-- ICD-10 E11 に対応する Standard Concept を探す
SELECT c2.concept_id, c2.concept_name
FROM concept c1
JOIN concept_relationship cr ON c1.concept_id = cr.concept_id_1
  AND cr.relationship_id = 'Maps to'
JOIN concept c2 ON cr.concept_id_2 = c2.concept_id
WHERE c1.vocabulary_id = 'ICD10CM' AND c1.concept_code = 'E11';
5. Concept Ancestor — 階層
CONCEPT_ANCESTOR は子孫の階層を保持します:
-- "Diabetes mellitus" のすべての子孫(Type 1、Type 2、妊娠糖尿病、…)を探す
SELECT c.concept_id, c.concept_name, ca.min_levels_of_separation
FROM concept_ancestor ca
JOIN concept c ON ca.descendant_concept_id = c.concept_id
WHERE ca.ancestor_concept_id = 201820  -- Diabetes mellitus
  AND c.standard_concept = 'S';
コホート定義時に強力です:「あらゆる種類の糖尿病患者」 = ancestor 201820 だけで済みます。
6. Athena — Vocabulary のポータル
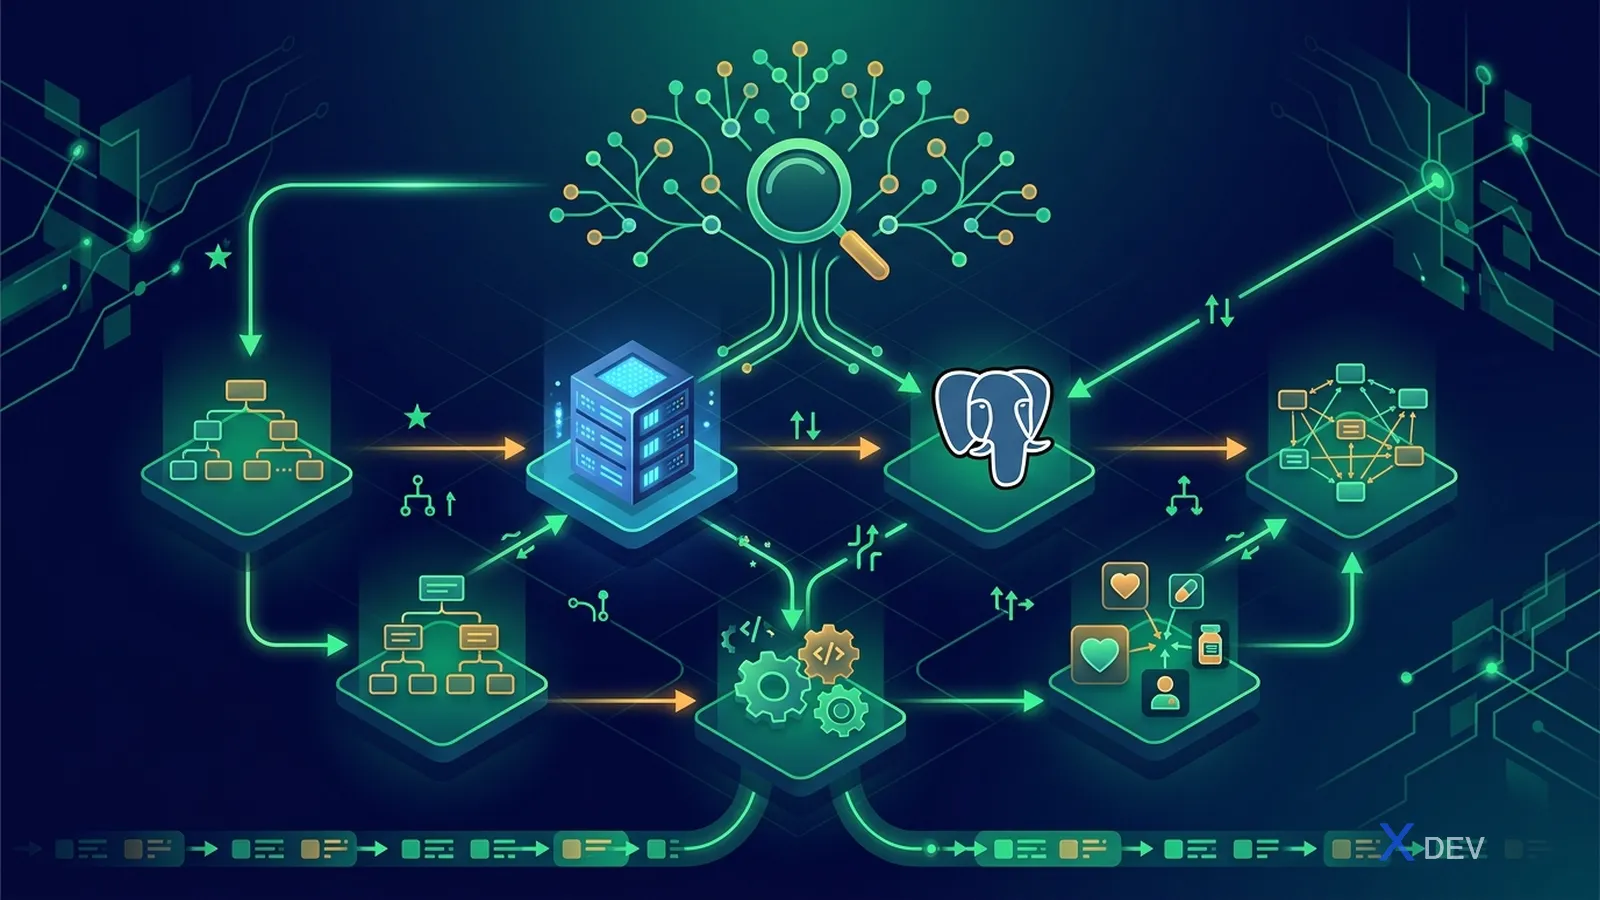
手順:
- athena.ohdsi.org で無料アカウント作成
- 必要な Vocabulary を選択(SNOMED、RxNorm、LOINC、ICD10CM、ICD10、ATC など)
- 一部の Vocabulary は ライセンス が必要(ベトナムの SNOMED CT:SNOMED International の affiliate ライセンス登録が必要 — ベトナムは low-income member のため無料)
- zip をダウンロード — CONCEPT.csv、CONCEPT_RELATIONSHIP.csv などが含まれる
- CDM データベースにインポート
7. Vocabulary を Postgres にインポート
-- CommonDataModel DDL に従ってスキーマとテーブルを作成
\i OMOPCDM_postgresql_5.4_ddl.sql

-- CSV インポート(例)
COPY concept FROM '/path/CONCEPT.csv' DELIMITER E'\t' CSV HEADER QUOTE E'\b';
COPY concept_relationship FROM '/path/CONCEPT_RELATIONSHIP.csv' DELIMITER E'\t' CSV HEADER QUOTE E'\b';
COPY concept_ancestor FROM '/path/CONCEPT_ANCESTOR.csv' DELIMITER E'\t' CSV HEADER QUOTE E'\b';
-- ...

-- インデックス作成
\i OMOPCDM_postgresql_5.4_indices.sql

-- PK 作成
\i OMOPCDM_postgresql_5.4_primary_keys.sql
インポート後:完全版で約 600 万 concept、約 12 GB。必要な vocabulary だけ選んでサイズを削れます。
8. USAGI — コードマッピングツール
USAGI は source code(ベトナム ICD-10、保健省医薬品リスト)を Standard Concept にマッピングするのを支援します:
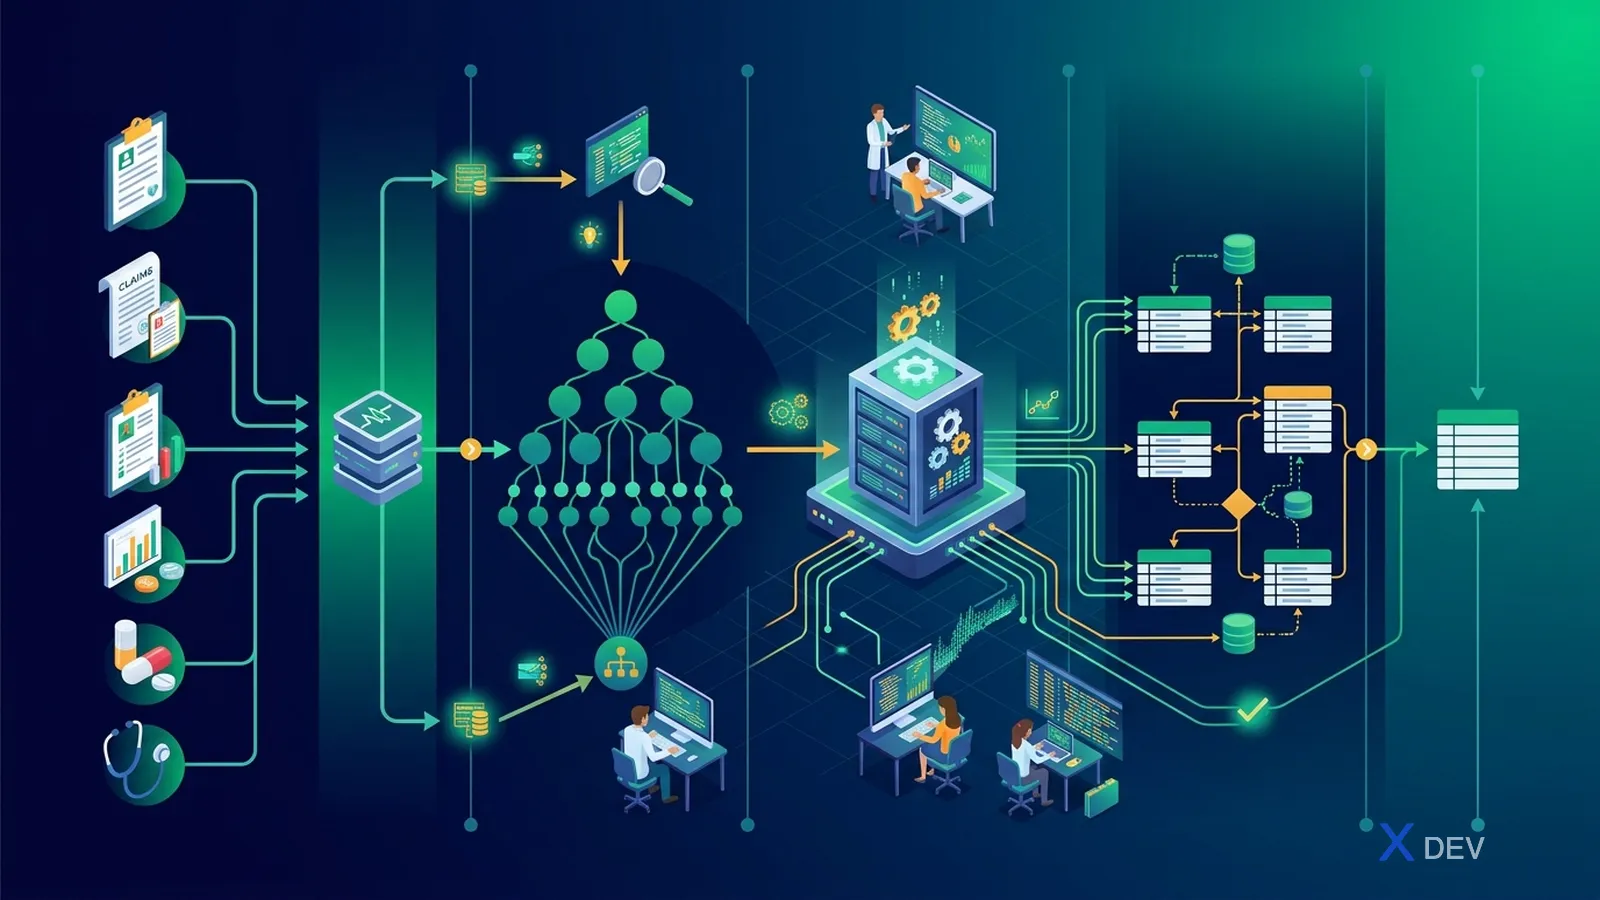
ワークフロー:
source_code, source_name列を持つ CSV を入力- USAGI が Lucene で検索
- ユーザーが上位マッチをレビューし、承認または修正
SOURCE_TO_CONCEPT_MAPテーブルにエクスポート
9. ベトナム向け Vocabulary
9.1 ベトナム向け Custom Vocabulary
対応する standard が存在しない場合(例:ベトナムの 54 民族)、Custom Vocabulary を作成します:
vocabulary_id = 'VN_DANTOC'concept_idは 20 億以上(OHDSI が custom 用に確保している範囲)- VOCABULARY テーブルに登録
INSERT INTO vocabulary VALUES
  ('VN_DANTOC', 'Dân tộc Việt Nam (54)', 'http://...', '1.0', 2000000001);

INSERT INTO concept VALUES
  (2000001001, 'Kinh', 'Race', 'VN_DANTOC', 'Race', 'S', '01', NULL, NULL);
-- ...
9.2 SNOMED CT VN
ベトナムは 2024 年に保健省を通じて SNOMED International の Member に登録されました。国内の個人/組織は affiliate ライセンスが無料です。snomed.org で登録できます。
10. Vocabulary のアップグレード
Athena は毎月 vocabulary をリリースします。アップグレード手順:
注意:concept_id はバージョン間で stable ですが、Maps to 関係は変わる可能性があるため、*_concept_id カラムを更新するため ETL を再実行する必要があります。
11. よくある SQL パターン
11.1 source code から standard concept を引く
SELECT c2.concept_id, c2.concept_name, c2.vocabulary_id
FROM concept c1
JOIN concept_relationship cr ON c1.concept_id = cr.concept_id_1
  AND cr.relationship_id = 'Maps to'
JOIN concept c2 ON cr.concept_id_2 = c2.concept_id
WHERE c1.vocabulary_id = 'ICD10CM'
  AND c1.concept_code = 'E11.9';
11.2 ある ancestor のすべての descendant を探す
SELECT c.concept_id, c.concept_name
FROM concept_ancestor ca
JOIN concept c ON ca.descendant_concept_id = c.concept_id
WHERE ca.ancestor_concept_id = 201820  -- Diabetes mellitus
  AND c.standard_concept = 'S';
11.3 RxNorm:ingredient を含むすべての product を探す
SELECT product.concept_id, product.concept_name
FROM concept ing
JOIN concept_ancestor ca ON ing.concept_id = ca.ancestor_concept_id
JOIN concept product ON ca.descendant_concept_id = product.concept_id
WHERE ing.concept_name = 'Metformin'
  AND ing.concept_class_id = 'Ingredient'
  AND product.concept_class_id IN ('Branded Drug', 'Clinical Drug');
12. よくある落とし穴
- ❌ Vocabulary アップグレードを忘れ、obsolete な concept で解析する
- ❌ source→standard マッピングが誤っており、コホートが数千人ずれる
- ❌ 解析で Standard(S)の代わりに Classification(C)concept を使う
- ❌ 階層を忘れ、亜型がコホートから漏れる(例:「糖尿病」で Type 1.5 が抜ける)
- ❌ Custom concept_id が標準と衝突する(必ず 20 億以上を使う)
- ❌ アップグレード前に vocabulary をバックアップしない
13. 新規プロジェクト向け推奨ワークフロー
- OHDSI Themis の規約を読む
- Vocabulary subset(SNOMED + ICD10CM + RxNorm + LOINC + ATC + UCUM)をダウンロード — ベトナムの 90% をカバー
- SNOMED International affiliate に登録(ベトナムは無料)
- Postgres にインポート + インデックス作成
- マッピングチームに USAGI をセットアップ
- ボリュームの大きい source code から先にマッピング(上位 100 ICD-10 + 上位 200 薬剤 = ボリュームの 80% カバー)
- マッピングを
SOURCE_TO_CONCEPT_MAPに保存し Git にコミット - 四半期ごとに vocabulary アップグレードをスケジューリング
まとめ
Vocabulary は OMOP の価値の 50% を占めます。きちんと投資すれば、どんなデータセットも join して分析できます。投資が中途半端だと、解析結果は常に疑念を抱かれることになります。小さく始め、厳密にレビューし、定期的にアップグレードしましょう。
次の記事:OMOP コア臨床テーブル — Person、Visit、Condition、Drug、Measurement、Observation。