你可以略過這部分而直接做 OMOP — 但分析結果永遠會出錯。詞彙是讓 OMOP 真正具有意義的關鍵。本文深入探討 Concept、階層、對應與 Athena 工作流程。
1. 為何詞彙如此重要
實際範例:你有 3 個資料來源:
- 醫院 A:診斷代碼「ICD-10 E11.9」
- 醫院 B:代碼「ICD-10 E11」
- 醫院 C:SNOMED 代碼「44054006」
3 者都指第二型糖尿病。如果不標準化,「第二型糖尿病病人總數」這個查詢會得出錯誤的數字。
OMOP 的解法是選定唯一一個 Standard Concept(這裡是 concept_id = 201826、SNOMED 44054006),並將所有來源代碼對應到它。
2. Concept — 基本單位
Concept 是 CONCEPT 資料表中的一列:
| concept_id | concept_name | domain_id | vocabulary_id | concept_class_id | standard_concept | concept_code |
|---|---|---|---|---|---|---|
| 201826 | Type 2 diabetes mellitus | Condition | SNOMED | Clinical Finding | S | 44054006 |
| 192279 | Diabetic complication | Condition | SNOMED | Clinical Finding | C | 74627003 |
| 45757466 | E11 (ICD-10-CM) | Condition | ICD10CM | ICD10CM code | (null = Source) | E11 |
standard_concept:
- S(Standard):用於分析
- C(Classification):用於分類,非標準
- NULL(Source):原始代碼,用於儲存 source_value
3. Vocabulary 與 Domain
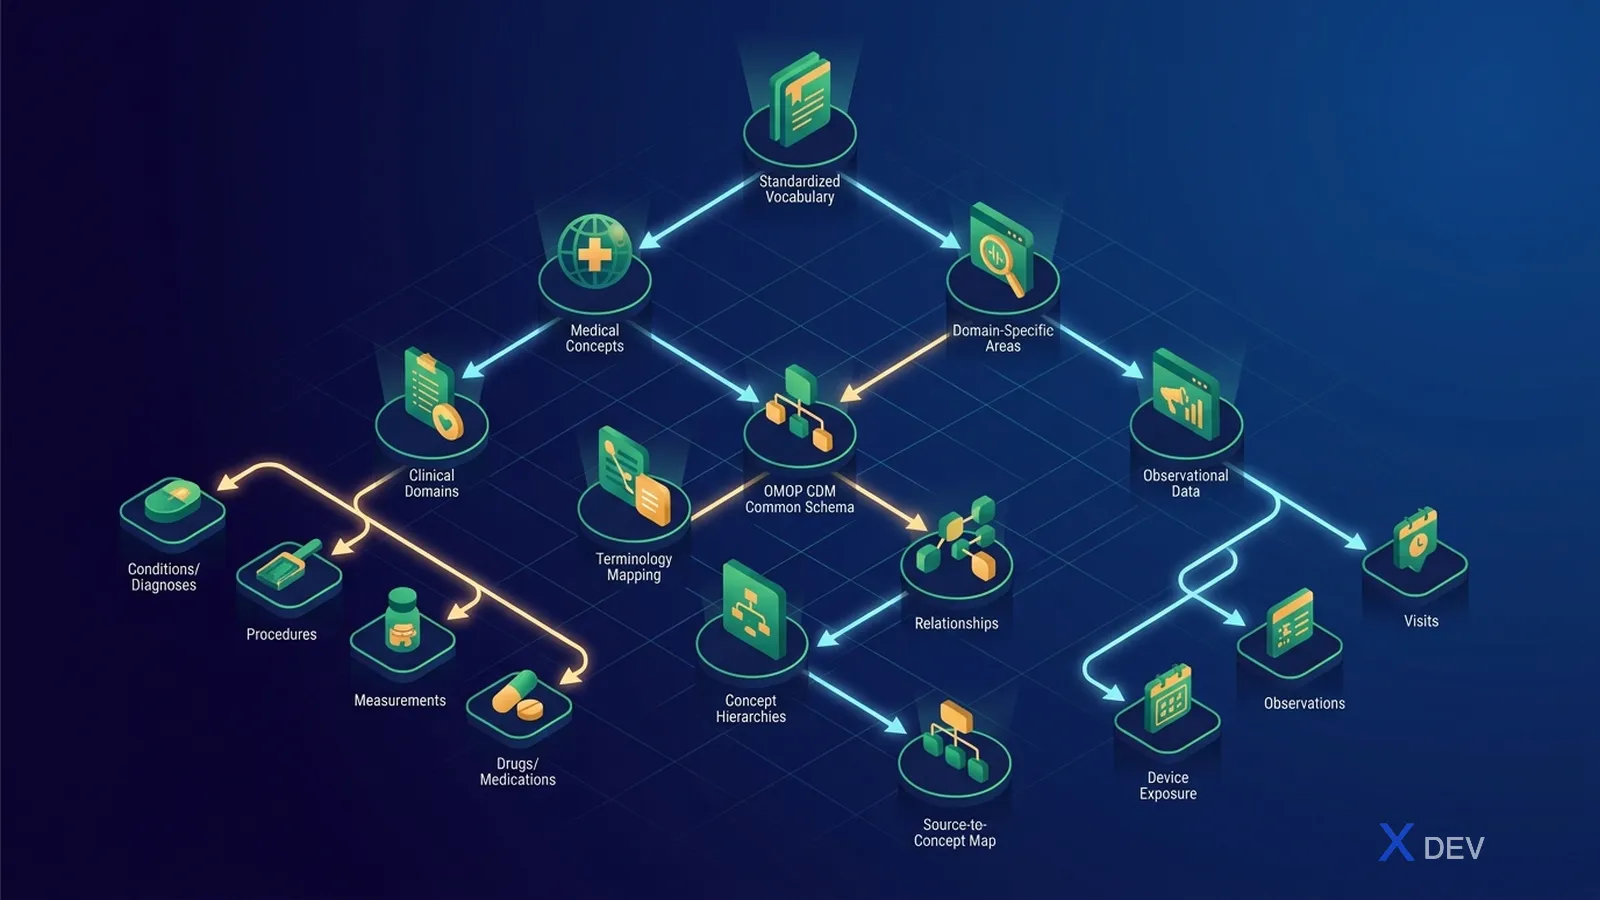
| Domain | OMOP 資料表 | 主要 Standard Vocabulary |
|---|---|---|
| Condition | CONDITION_OCCURRENCE | SNOMED CT |
| Drug | DRUG_EXPOSURE | RxNorm + RxNorm Extension |
| Procedure | PROCEDURE_OCCURRENCE | SNOMED CT、CPT4、ICD-10-PCS |
| Measurement | MEASUREMENT | LOINC、SNOMED CT |
| Observation | OBSERVATION | SNOMED CT、LOINC |
| Device | DEVICE_EXPOSURE | SNOMED CT |
| Unit | (across) | UCUM |
| Race / Ethnicity | PERSON | OMOP Custom(越南需要對應) |
4. Concept Relationship
CONCEPT_RELATIONSHIP 資料表儲存 concept 之間的關係:
| concept_id_1 | concept_id_2 | relationship_id |
|---|---|---|
| 45757466 (ICD10 E11) | 201826 (SNOMED Diabetes T2) | "Maps to" |
| 201826 | 45757466 | "Mapped from" |
| 1503297 (Metformin) | 1503328 (Metformin 500mg tablet) | "Has form" |
Maps to 至為關鍵 — 這是來源 → 標準對應的方式:
-- 找出對應 ICD-10 E11 的 Standard Concept
SELECT c2.concept_id, c2.concept_name
FROM concept c1
JOIN concept_relationship cr ON c1.concept_id = cr.concept_id_1
  AND cr.relationship_id = 'Maps to'
JOIN concept c2 ON cr.concept_id_2 = c2.concept_id
WHERE c1.vocabulary_id = 'ICD10CM' AND c1.concept_code = 'E11';
5. Concept Ancestor — 階層
CONCEPT_ANCESTOR 儲存階層後代關係:
-- 找出「Diabetes mellitus」的所有後代(第一型、第二型、妊娠等)
SELECT c.concept_id, c.concept_name, ca.min_levels_of_separation
FROM concept_ancestor ca
JOIN concept c ON ca.descendant_concept_id = c.concept_id
WHERE ca.ancestor_concept_id = 201820  -- Diabetes mellitus
  AND c.standard_concept = 'S';
定義世代時極為強大:「任一型糖尿病病人」= 只需用 ancestor 201820 即可。
6. Athena — 詞彙入口網
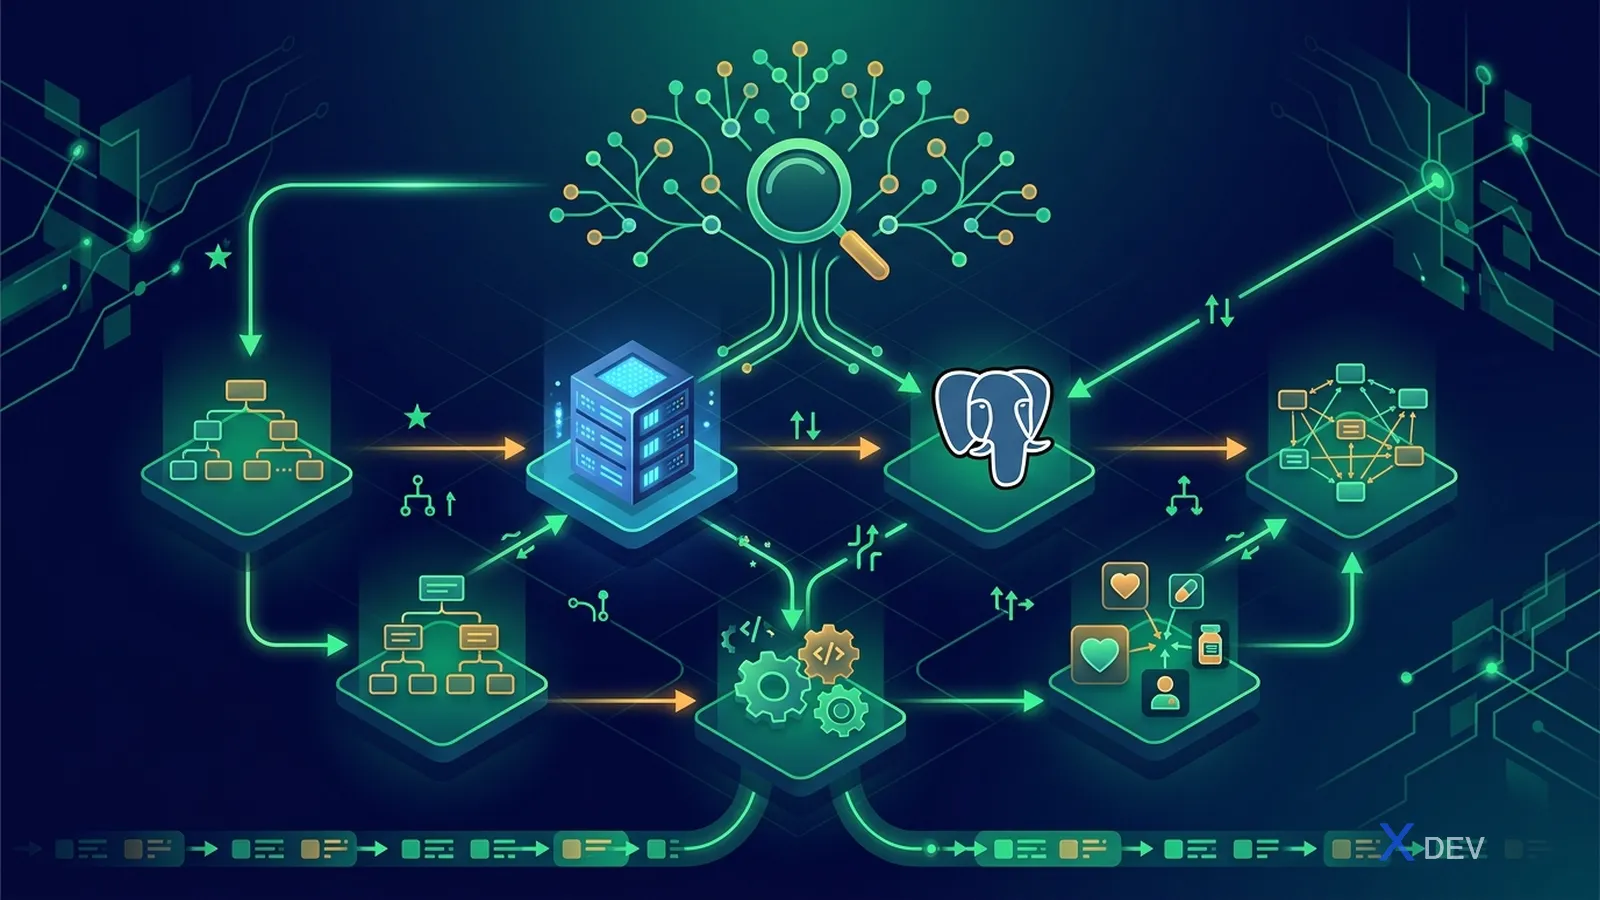
流程:
- 在 athena.ohdsi.org 建立免費帳號
- 選擇所需的 vocabulary(SNOMED、RxNorm、LOINC、ICD10CM、ICD10、ATC 等)
- 部分 vocabulary 需 license(SNOMED CT 對越南而言:需註冊 SNOMED International affiliate license — 越南屬低收入會員,免費)
- 下載 zip — 包含 CONCEPT.csv、CONCEPT_RELATIONSHIP.csv 等
- 匯入 CDM 資料庫
7. 將詞彙匯入 Postgres
-- 依 CommonDataModel DDL 建立 schema 與資料表
\i OMOPCDM_postgresql_5.4_ddl.sql

-- 匯入 CSV(範例)
COPY concept FROM '/path/CONCEPT.csv' DELIMITER E'\t' CSV HEADER QUOTE E'\b';
COPY concept_relationship FROM '/path/CONCEPT_RELATIONSHIP.csv' DELIMITER E'\t' CSV HEADER QUOTE E'\b';
COPY concept_ancestor FROM '/path/CONCEPT_ANCESTOR.csv' DELIMITER E'\t' CSV HEADER QUOTE E'\b';
-- ...

-- 建立索引
\i OMOPCDM_postgresql_5.4_indices.sql

-- 建立主鍵
\i OMOPCDM_postgresql_5.4_primary_keys.sql
匯入後:約 600 萬個 concept(完整版),約 12 GB。可只選需要的 vocabulary 來精簡。
8. USAGI — 代碼對應工具
USAGI 協助將來源代碼(越南 ICD-10、衛生部藥品目錄)對應至 Standard Concept:
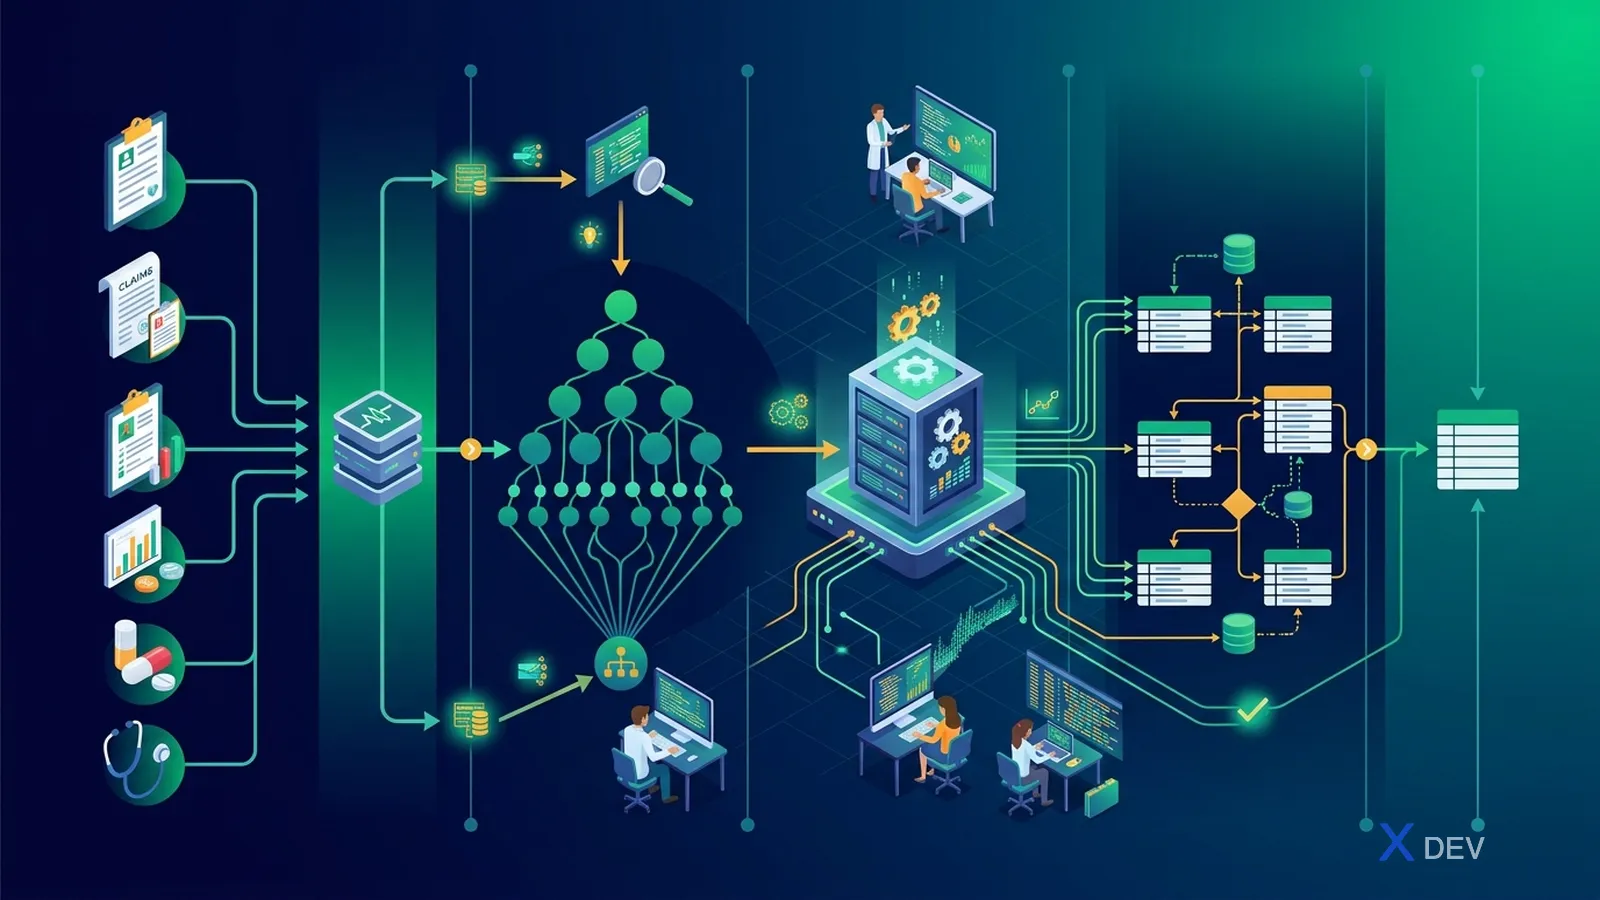
工作流程:
- 輸入 CSV 檔具有
source_code, source_name欄位 - USAGI 以 Lucene 進行搜尋
- 使用者審查 top match,接受或修改
- 匯出 →
SOURCE_TO_CONCEPT_MAP資料表
9. 越南專用詞彙
9.1 越南 Custom Vocabulary
當沒有對應的標準時(例如越南 54 個民族),建立 Custom Vocabulary:
vocabulary_id = 'VN_DANTOC'concept_id從 20 億起跳(OHDSI 為 custom 保留的範圍)- 在 VOCABULARY 資料表中註冊
INSERT INTO vocabulary VALUES
  ('VN_DANTOC', '越南民族 (54)', 'http://...', '1.0', 2000000001);

INSERT INTO concept VALUES
  (2000001001, 'Kinh', 'Race', 'VN_DANTOC', 'Race', 'S', '01', NULL, NULL);
-- ...
9.2 越南 SNOMED CT
越南是 SNOMED International Member(2024 年由衛生部註冊)。Affiliate license 對國內個人/組織免費。請至 snomed.org 註冊。
10. 詞彙升級
Athena 每月發布詞彙更新。升級流程:
注意:concept_id 在版本間 穩定,但 Maps to 關係可能變動 → 需重跑 ETL 以更新 *_concept_id 欄位。
11. 常見 SQL 模式
11.1 從來源代碼查詢 standard concept
SELECT c2.concept_id, c2.concept_name, c2.vocabulary_id
FROM concept c1
JOIN concept_relationship cr ON c1.concept_id = cr.concept_id_1
  AND cr.relationship_id = 'Maps to'
JOIN concept c2 ON cr.concept_id_2 = c2.concept_id
WHERE c1.vocabulary_id = 'ICD10CM'
  AND c1.concept_code = 'E11.9';
11.2 找出 ancestor 的所有後代
SELECT c.concept_id, c.concept_name
FROM concept_ancestor ca
JOIN concept c ON ca.descendant_concept_id = c.concept_id
WHERE ca.ancestor_concept_id = 201820  -- Diabetes mellitus
  AND c.standard_concept = 'S';
11.3 RxNorm:依成分找出所有含此成分的藥品
SELECT product.concept_id, product.concept_name
FROM concept ing
JOIN concept_ancestor ca ON ing.concept_id = ca.ancestor_concept_id
JOIN concept product ON ca.descendant_concept_id = product.concept_id
WHERE ing.concept_name = 'Metformin'
  AND ing.concept_class_id = 'Ingredient'
  AND product.concept_class_id IN ('Branded Drug', 'Clinical Drug');
12. 常見陷阱
- ❌ 忘記詞彙升級 → 分析使用了過時的 concept
- ❌ 來源 → 標準對應錯誤 → 世代偏差數千人
- ❌ 在分析中使用 Classification(C)而非 Standard(S)concept
- ❌ 忽略階層 → 世代漏掉變異型(例如 Diabetes 漏掉 Type 1.5)
- ❌ Custom concept_id 與標準衝突(必須使用 20 億以上範圍)
- ❌ 升級前未備份詞彙
13. 新專案建議工作流程
- 閱讀 OHDSI 的 Themis convention
- 下載 vocabulary 子集(SNOMED + ICD10CM + RxNorm + LOINC + ATC + UCUM)— 可涵蓋 90% 越南需求
- 註冊 SNOMED International affiliate(越南免費)
- 匯入 Postgres + 建立索引
- 為對應團隊設定 USAGI
- 優先對應量最大的來源代碼(top 100 ICD-10 + top 200 藥品 = 涵蓋 80% volume)
- 將對應結果存入
SOURCE_TO_CONCEPT_MAP+ 提交 Git - 排程每季升級詞彙
結論
詞彙佔 OMOP 50% 的價值。投入正確 — 你能 join 並分析任何資料集;投入錯誤 — 你的分析永遠會被質疑。從小處開始,嚴格審核,定期升級。
下一篇:OMOP Core Clinical Tables — Person、Visit、Condition、Drug、Measurement、Observation。