はじめに
数学は、AI モデルが「考える」ために使用する言語です。でも心配しないでください。AI を理解するのに 数学者である必要はありません。この記事では、本当に必要なものに焦点を当て、最初に実際の例を使って説明し、次にコードに入ります。
学習のヒント: 各セクションには、実践的な例→コード例→簡単な演習が含まれています。理解できない部分がある場合は、まず実践例を読んでください。
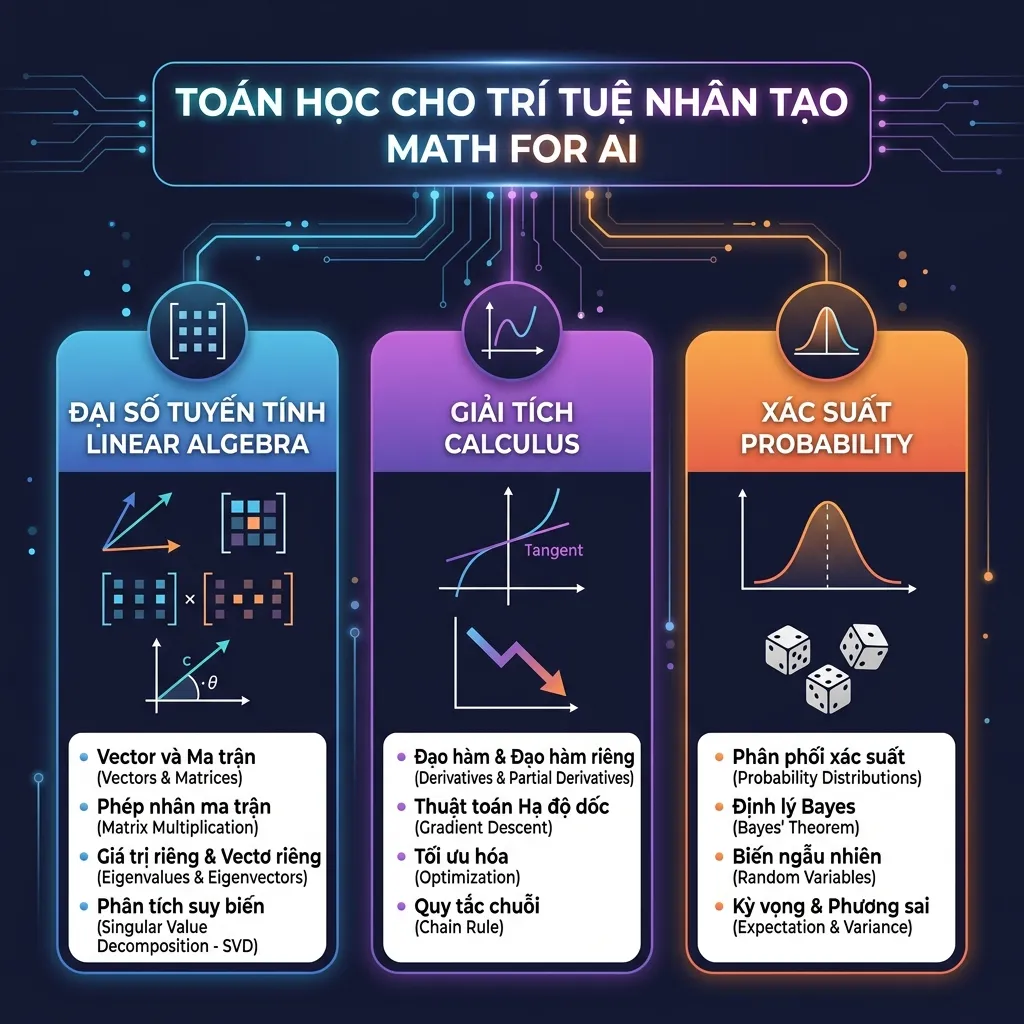
このレッスンは 4 つの主要な部分に分かれています。
| パート | あなたは学びます | なぜ AI が必要なのか |
|---|---|---|
| 1.線形代数 | ベクトル、行列、ドット積 | データ表現と変換 |
| 2.微積分 | 導関数、連鎖ルール | 「学習」する方法を知る — モデルチューニング |
| 3.勾配降下法 | 最適化アルゴリズム | AIは実際にどのように訓練されるのか |
| 4.確率 | 確率、ソフトマックス | 出力とモデルの評価 |
import numpy as np
import matplotlib.pyplot as plt

# Thiết lập seed để kết quả tái tạo được
np.random.seed(42)
1. 線形代数 — 線形代数
簡単なまとめ
💡 一文: 線形代数は AI によるデータの表現と変換に役立ちます。 AI のすべて (単語、画像、音声) は、コンピューターが処理できるように 数値 (ベクトル/行列) に変換されます。
1.1 スカラー、ベクトル、行列、テンソル — 簡単な説明
天気について説明していると想像してください。
- スカラー = 「今日の気温 37℃」 → 1 つの数値のみ
- ベクトル = 「今日の気温 37°C、湿度 80%、風速 15km/h」 → 1 行の数字 (多次元記述)
- マトリックス = 1 週間全体の天気表 (7 日間 × 3 指標) → 数値表
- Tensor = 50 都市の気象データ × 365 日 × 3 つのインデックス → 複数の積み上げテーブル
| コンセプト | 実際の例 | AI の例 |
|---|---|---|
| スカラー | 温度: 37°C | 学習率: 0.001 |
| ベクトル | GPS 座標: (10.8°、106.6°) | 単語「猫」の埋め込み: [0.2, -0.5, 0.8, ...] |
| マトリックス | 授業成績表(生徒×教科) | 単語埋め込みのバッチ |
| テンソル | 動画(フレーム×高さ×幅×色)| LLM のシーケンスのバッチ |
簡単に言うと: スカラー = 1 つの数値、ベクトル = 1 行の数値、行列 = 数値のテーブル、テンソル = 複数の積み重ねられた数値テーブル。
# Scalar — số vô hướng (1 giá trị duy nhất)
learning_rate = 0.001  # Tốc độ học
temperature = 0.7      # "Sáng tạo" khi sinh text

# Vector — mảng 1 chiều
# Ví dụ: vị trí một quán cafe trên Google Maps cần 2 số (lat, long)
# Trong AI: mỗi từ được biểu diễn bằng hàng trăm số
word_embedding = np.array([0.2, -0.5, 0.8, 0.1, -0.3])
print(f"Vector shape: {word_embedding.shape}")  # (5,)

# Matrix — mảng 2 chiều (bảng)
# Ví dụ: bảng điểm 8 học sinh × 3 môn
# Trong AI: 8 tokens × 512 chiều embedding
batch_embeddings = np.random.randn(8, 512)
print(f"Matrix shape: {batch_embeddings.shape}")  # (8, 512)

# Tensor — mảng n chiều
# Ví dụ: 32 câu × 128 từ/câu × 512 chiều embedding
batched_sequences = np.random.randn(32, 128, 512)
print(f"Tensor shape: {batched_sequences.shape}")  # (32, 128, 512)
💡 演習 1.1: カラー写真が 100 枚ある場合、各写真は 224×224 ピクセル、3 カラー チャネル (RGB) です。このテンソルはどのような形をしていますか? NumPy を使用してランダム テンソルを作成するコードを作成します。
1.2 内積 — 「類似性の測定」
通常の生活の例: あなたは、2 人の人が同じような興味を持っているかどうかを知りたいと考えています。各人が 3 つの映画ジャンル (アクション、ロマンス、ホラー) を 1→5 で評価します。
- An: [5、1、4] (アクションとホラーが好き)
- ビン: [4, 2, 5] (アクションとホラーも好き)
- ち:[1、5、1](好きな気持ちだけ)
内積は、設定が同じであれば 大きい 数値を与え、異なる場合には **小さい ** 数値を与えます。
an   = np.array([5, 1, 4])
binh = np.array([4, 2, 5])
chi  = np.array([1, 5, 1])

# Dot product: nhân tương ứng rồi cộng
# An · Bình = 5×4 + 1×2 + 4×5 = 20 + 2 + 20 = 42 → GẦN!
# An · Chi  = 5×1 + 1×5 + 4×1 = 5 + 5 + 4 = 14 → XA!
print(f"An · Bình = {np.dot(an, binh)}")  # 42 (tương đồng cao)
print(f"An · Chi  = {np.dot(an, chi)}")   # 14 (tương đồng thấp)
AI においてそれが重要なのはなぜですか? これはまさに 注意メカニズム の仕組みであり、文内の単語間の「関連性」の度合いを測定します。 ChatGPT は、「猫は 椅子 に横たわっています」と読み取ると、ドット積を使用して、「嘘」が「椅子」よりも「猫」に強く関連していることを認識します。
# Cosine Similarity — dot product đã "chuẩn hóa" (từ -1 đến 1)
# Giống đo góc giữa 2 mũi tên:
#   - Cùng hướng = 1 (rất giống)
#   - Vuông góc = 0 (không liên quan)
#   - Ngược hướng = -1 (trái ngược)
def cosine_similarity(v1, v2):
    return np.dot(v1, v2) / (np.linalg.norm(v1) * np.linalg.norm(v2))

print(f"Cosine(An, Bình) = {cosine_similarity(an, binh):.4f}")  # ~0.96 (rất giống)
print(f"Cosine(An, Chi)  = {cosine_similarity(an, chi):.4f}")   # ~0.39 (khác nhiều)
💡 演習 1.2:
- 設定 [3, 3, 3] (同様に) を持つ人物「Dung」を追加します。 Dung と An、Binh、Chi のコサイン類似度を計算します。ドゥンに一番似ているのは誰ですか?
- 考えてみてください: 「Ha」に優先順位 [10、2、8] (An と同じですが 2 倍) がある場合、An と Ha のコサイン類似度はいくらですか?なぜそのような結果になるのでしょうか?
1.3 行列の乗算 — 「データ変換」
通常の生活の例: コーヒーメニュー (ドリンク 3 種類) と食材の価格があります。各種類の水の価格を計算したいとします。
| コーヒー (g) | 牛乳 (ml) | 砂糖(g) | |
|---|---|---|---|
| ストーンブラック | 20 | 0 | 10 |
| アイスミルク | 15 | 50 | 15 |
| アンダーカット | 10 | 80 | 20 |
原材料価格:コーヒー=500VND/g、ミルク=30VND/ml、砂糖=50VND/g
# Menu (3 loại nước × 3 nguyên liệu)
menu = np.array([
    [20, 0,  10],   # Đen đá
    [15, 50, 15],   # Sữa đá
    [10, 80, 20],   # Bạc xỉu
])

# Giá nguyên liệu (3 nguyên liệu × 1 giá)
gia = np.array([[500], [30], [50]])

# Nhân ma trận = tính giá mỗi loại nước!
gia_nuoc = menu @ gia
print("Giá mỗi loại nước:")
for ten, g in zip(["Đen đá", "Sữa đá", "Bạc xỉu"], gia_nuoc):
    print(f"  {ten}: {int(g[0]):,}đ")
# Đen đá: 10,500đ  |  Sữa đá: 9,750đ  |  Bạc xỉu: 8,400đ
形状ルール: A (m×n) と B (n×p) を乗算すると、結果は形状 (m×p) になります。 A の列数 ** は B の行数と等しくなければなりません。
(3, 3) @ (3, 1) = (3, 1)   ✅ 3 loại nước × 1 giá
(8, 768) @ (768, 256) = (8, 256)   ✅ Trong neural network
(3, 3) @ (2, 1) = ???       ❌ 3 ≠ 2, không nhân được!
ニューラル ネットワークの場合: 各線形層はまさに行列の乗算であり、入力データを新しい形式に変換します。
# Neural network layer: output = input × W + b
batch_size, input_dim, output_dim = 32, 768, 256
X = np.random.randn(batch_size, input_dim)      # 32 câu, 768 chiều
W = np.random.randn(input_dim, output_dim) * 0.02  # Trọng số
b = np.zeros(output_dim)                         # Bias
output = X @ W + b
print(f"Linear layer: ({batch_size}, {input_dim}) → ({output.shape})")
💡 演習 1.3:
- 関数を書く
matrix_multiply(A, B)最初から3ループでfor(未使用@素敵なnp.dot)。と比較して結果を確認してくださいA @ B。- 入力の形状が (16, 512) で、出力の形状 (16, 128) が必要な場合、行列 W はどのような形状でなければなりませんか?
1.4 転置とノルム
# Transpose — "lật" bảng (hàng → cột, cột → hàng)
# Ví dụ: bạn có bảng điểm (học sinh × môn), lật thành (môn × học sinh)
M = np.array([[1, 2, 3], [4, 5, 6]])  # (2 hàng, 3 cột)
print(f"M shape: {M.shape}")      # (2, 3)
print(f"M.T shape: {M.T.shape}")  # (3, 2) — lật!

# L2 Norm — "độ dài" vector (khoảng cách từ gốc)
# Ví dụ: bạn ở vị trí (3, 4), cách gốc tọa độ bao xa?
v = np.array([3.0, 4.0])
norm = np.linalg.norm(v)  # sqrt(3² + 4²) = 5.0
print(f"Khoảng cách: {norm}")

# Normalize — biến vector thành "vector đơn vị" (dài = 1)
# Giống như: giữ nguyên hướng đi nhưng quy về cùng 1 bước chân
# Rất quan trọng trong AI — word embeddings luôn được normalize!
v_unit = v / np.linalg.norm(v)
print(f"Unit vector: {v_unit}, length = {np.linalg.norm(v_unit):.6f}")  # 1.0
💡 演習 1.4: 3 つのベクトルがあるとします: a = [1, 0, 0]、b = [0, 1, 0]、c = [1, 1, 0]。ベクトル c を正規化し、c (正規化) と a、b の間のコサイン類似度を計算します。結果を正規化前と比較します。
2. 微積分 — 微積分
簡単なまとめ
💡 一文: 微積分は、より適切に予測するために どのように調整する必要があるかを AI に伝えます。微分値 = 「変化率」 = 「進む方向」。
2.1 導関数 — 「変化率」
通常の生活の例: 車を運転すると、速度計は 60 km/h を示します。この数値は、時間の経過に伴う距離の導関数であり、距離がどの程度の速さで変化しているかを示します。
もう 1 つのもっと身近な例:
- 体重が減ってきていますね。今週、0.5 kg 減少しました → 時間の経過による体重微分値 = -0.5 kg/週
- 来週は 0.1 kg しか減りません → 微分値 = -0.1 → 減少率は 遅くなります!
AI の場合: 導関数は、重みを変更したときに 損失がどのように変化するかを示します。そこから、重みをどの方向に調整すればよいかがわかります。
# f(x) = x² → f'(x) = 2x
# Tại x=3: f'(3) = 6 → nếu x tăng 1 nhỏ, f(x) tăng ~6
def f(x):
    return x**2

# Cách tính đạo hàm bằng số (không cần biết công thức)
# Ý tưởng: lấy 2 điểm rất gần nhau, tính độ dốc
# f'(x) ≈ [f(x + h) - f(x - h)] / (2h)
def numerical_gradient(func, x, h=1e-5):
    return (func(x + h) - func(x - h)) / (2 * h)

x = 3.0
print(f"f'(3) công thức: {2*x}")                    # 6.0
print(f"f'(3) tính số:   {numerical_gradient(f, x):.6f}")  # 6.000000
💡 演習 2.1:
- f(x) = x³ - 2x とします。式 (3x² - 2) を使用して f'(x) を計算し、次と等しくなります。
numerical_gradient。 x = 2 での結果を比較します。- f(x) = sin(x) とします。使用する
numerical_gradientf'(0)、f'(π/2)、f'(π)を計算します。理論値cos(x)と比較してください。
2.2 部分導関数 — 「部分導関数」
通常の生活の例: あなたはケーキを焼いています。品質は温度と時間によって決まります:
- 温度だけを上げた場合(時間を同じに保つ)→ケーキはどう変化しますか? → 温度による偏導関数
- 時間だけを増やす(温度を同じに保つ)場合 → ケーキはどう変化しますか? → 時間の経過に伴う偏導関数
AI の場合: モデルには 数百万の重み (パラメータ) があります。偏導関数は、「この重みを w₁₂₃₄₅ に変更した場合、損失は増加しますか、それとも減少しますか?」と述べています。 すべての重みの偏微分を計算 = 勾配 — 最速の損失方向を示すベクトル。
# f(x, y) = x² + 3xy + y²
# ∂f/∂x = 2x + 3y  (đạo hàm theo x, coi y là hằng số)
# ∂f/∂y = 3x + 2y  (đạo hàm theo y, coi x là hằng số)

def f_multi(x, y):
    return x**2 + 3*x*y + y**2

h = 1e-5
x, y = 2.0, 1.0

# Tính đạo hàm riêng bằng số
# Cách làm: giữ nguyên biến kia, chỉ thay đổi biến cần tính
df_dx = (f_multi(x + h, y) - f_multi(x - h, y)) / (2 * h)
df_dy = (f_multi(x, y + h) - f_multi(x, y - h)) / (2 * h)

print(f"∂f/∂x tại (2,1): {df_dx:.4f} (lý thuyết: {2*x + 3*y})")  # 7.0
print(f"∂f/∂y tại (2,1): {df_dy:.4f} (lý thuyết: {3*x + 2*y})")  # 8.0
print(f"Gradient = [{df_dx:.1f}, {df_dy:.1f}]")  # [7.0, 8.0] — hướng loss tăng nhanh nhất
💡 演習 2.2: f(x, y) = (x - 3)² + (y + 2)² とします。これは、(3, -2) を底とする「放物面」関数です。 (0, 0) と (3, -2) での勾配を計算します。根元の勾配は何ですか?なぜ?
2.3 チェーン ルール — 「チェーン ルール」
通常の生活の例: ガソリン価格が牛肉麺の価格にどれだけ影響するかを知りたいですか?
Giá xăng ↑10% → Chi phí vận chuyển ↑5% → Giá thịt bò ↑3% → Giá bún bò ↑2%
直接的な影響は合計でしょうか? 比率を掛ける: 10% × 0.5 × 0.6 × 0.67 ≈ 2%
これは連鎖規則です: f が g に依存するとき、g は x に依存します → df/dx = df/dg × dg/dx。
なぜそれほど重要なのでしょうか? それは、バックプロパゲーションの基礎**、つまりニューラル ネットワークがどのように「学習」するかであるためです。 100 層のネットワークでは、連鎖ルールにより、すべての層を通る出力から入力までの勾配を計算できます。
# z = (x² + 1)³
# Chia thành 2 bước: g(x) = x² + 1, rồi f(g) = g³
# Chain rule: dz/dx = f'(g) × g'(x) = 3g² × 2x = 3(x²+1)² × 2x

def z(x):
    return (x**2 + 1)**3

x = 2.0
# Theo chain rule: 3 × (4+1)² × (2×2) = 3 × 25 × 4 = 300
analytical = 3 * (x**2 + 1)**2 * (2 * x)
numerical = numerical_gradient(z, x)

print(f"dz/dx công thức: {analytical}")       # 300.0
print(f"dz/dx tính số:   {numerical:.4f}")     # 300.0000
💡 演習 2.3:
- y = sin(x²) とします。連鎖則を使用して dy/dx を計算します: cos(x²) × 2x。確認者
numerical_gradientx = 1 の場合。- より実用的: 単純なニューラル ネットワークの場合: 出力 = sigmoid(w × x + b)。シグモイド(z) = 1/(1+e^(-z)) の場合。 x=2、w=0.5、b=0のとき、連鎖則を使用してd(出力)/dwを計算します。
3. 勾配降下法 — ニューラル ネットワークの「学習アルゴリズム」。
簡単なまとめ
💡 一文: 勾配降下法は、AI が損失曲面を「下り坂」で自動的に最適なパラメーターのセットを見つける方法です。
3.1 ビジュアル
通常の生活の例: あなたは 濃霧の山の上に立っていて、何も見えません。山のふもとに行きたい(最低限のものを見つける)。唯一の方法: 足元の地面を感じ、最も急な方向を見つけて、少し踏み込みます。繰り返す。
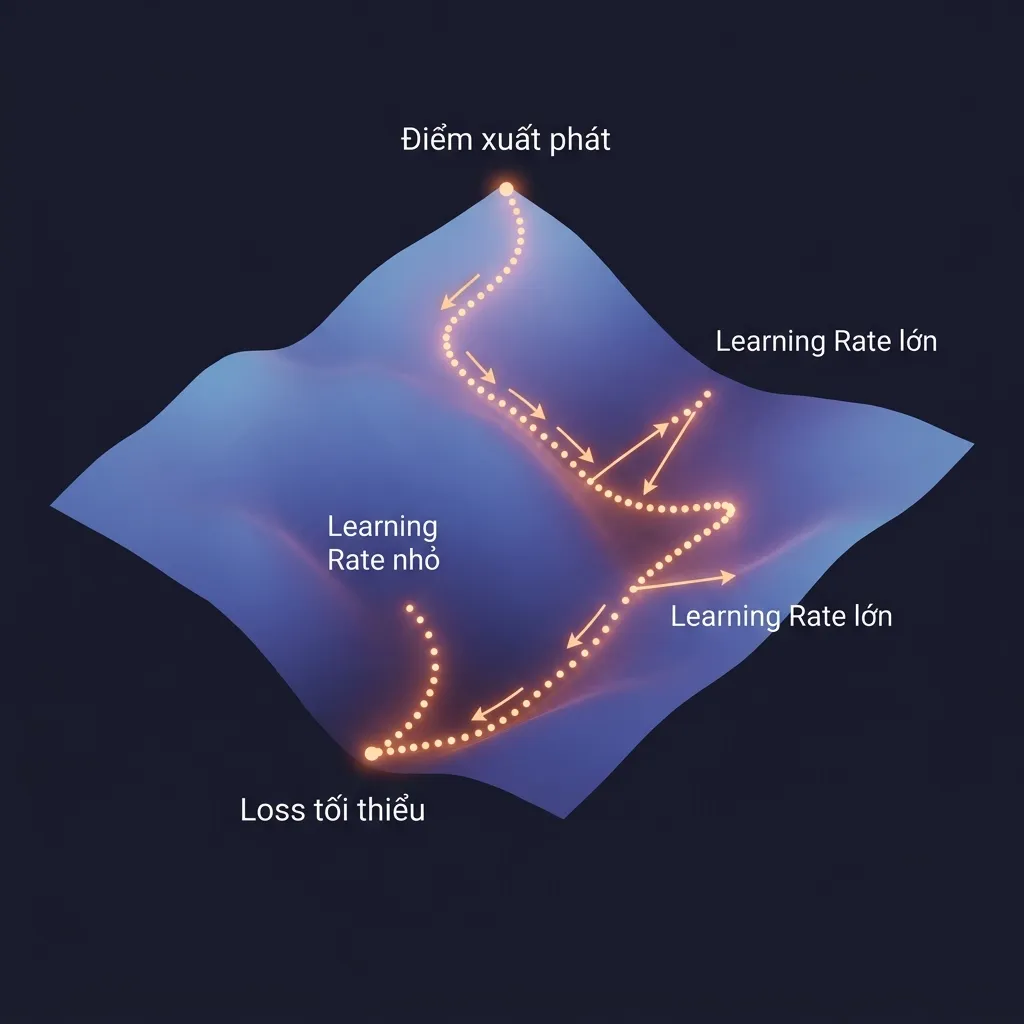
θ_new = θ_old - α × ∇L(θ)
  ↑         ↑      ↑
  vị trí   learning  hướng dốc
  mới      rate      nhất
α(学習率) = ステップサイズ- 小さすぎる → ステップが到達しない (100,000 エポックが必要) ・大きすぎる → 行ったり来たりして収束しない(損失が大きくなる!)
- 中程度→高速かつ安定した収束
∇L(θ)= 最も急な方向 (勾配)- マイナス記号: グラデーション方向の反対に進みます (グラデーションは増加方向を示します。減少させたいと考えています)
3.2 デモ: 直線 y = wx + b の当てはめ
問題: 与えられたデータから、y ≈ wx + b となる w と b を見つけます。これは、すべてのニューラル ネットワークが通過する必要がある最初のステップです。
# Dữ liệu thật: y = 3x + 1.5 + noise
np.random.seed(42)
X = np.linspace(-2, 2, 100)
y_true = 3 * X + 1.5 + np.random.randn(100) * 0.3

# Bắt đầu với w, b ngẫu nhiên (chưa biết đáp án)
w = np.random.randn()  # w ban đầu
b = np.random.randn()  # b ban đầu
lr = 0.01
n = len(X)

print(f"Ban đầu: w={w:.3f}, b={b:.3f} (cần tìm: w≈3.0, b≈1.5)")

for epoch in range(500):
    # Bước 1: Dự đoán (Forward Pass)
    y_pred = w * X + b

    # Bước 2: Tính sai số (Loss = Mean Squared Error)
    loss = np.mean((y_pred - y_true) ** 2)

    # Bước 3: Tính gradient (hướng cần điều chỉnh)
    # "w cần thay đổi bao nhiêu?" và "b cần thay đổi bao nhiêu?"
    dL_dw = np.mean(2 * (y_pred - y_true) * X)
    dL_db = np.mean(2 * (y_pred - y_true))

    # Bước 4: Cập nhật w, b (đi ngược hướng gradient)
    w -= lr * dL_dw
    b -= lr * dL_db

    if epoch % 100 == 0:
        print(f"  Epoch {epoch:3d} | Loss: {loss:.4f} | w={w:.3f}, b={b:.3f}")

print(f"\nKết quả: w={w:.4f} (≈3.0), b={b:.4f} (≈1.5) ✅")
3.3 勾配降下のバリエーション
| バリエーション | 更新するたびに | を使用します。利点 | デメリット | 実際の例 |
|---|---|---|---|---|
| バッチ GD | データセット全体 | 正確な勾配 | 遅い、RAM を消費する | 1000 件のレビューをすべて読んでから決めてください。 |
| シンガポールドル | 1 つのランダムなサンプル | 急いで、ローカル min を終了します | 大きく変動する | 1 件のレビューを読んですぐに決定 |
| ミニバッチ | 32 ~ 256 サンプル | バランスが良い | バッチサイズを調整する必要があります | 32 件のレビューを読んで決定 |
| アダム | ミニバッチ + アダプティブ LR | 高速かつ安定したコンバージェンス | 複数のハイパーパラメータ | 32 件のレビューを読んで、読書速度を調整 |
事実: 今日のほぼすべての AI モデルは Adam または AdamW を使用しています。これらはレッスン 3 以降継続的に使用されます。
💡 演習 3:
- 変更してみる
lr = 0.1(大きめ)。損失が収束するかどうかを観察します。それから試してみてくださいlr = 0.0001(小さすぎる) — 収束するまでに何エポックかかりますか?- 課題: 放物線 y = ax² + bx + c に適合するように上記の勾配降下法コードを変更します。ヒント: 3 つの変数 a、b、c と 3 つの勾配が必要です。
4. 確率 — 確率
簡単なまとめ
💡 一文: 確率は、AI が **自信を持って予測するのに役立ちます ** — AI は、「これは猫です」と言う代わりに、「これは 90% 猫、8% 犬、2% ウサギ」と言います。
4.1 ベイズの定理 — 「信念の更新」
通常の生活の例: メールが届きます。読む前に、電子メールの 30% がスパムであると推定します (個人的な経験)。 「お金」という単語を含むメールを見た後、あなたは自分の信念を更新します。スパムの可能性はどの程度増加しますか?
- スパムメールの 80% に「お金」という単語が含まれています
- 通常のメールには「お金」という単語が含まれるメールが 10%
# Bayes: P(spam|tiền) = P(tiền|spam) × P(spam) / P(tiền)
# Đọc: "Xác suất spam BIẾT RẰNG có từ tiền"

p_spam = 0.3                    # Prior: niềm tin ban đầu
p_ham = 0.7
p_tien_spam = 0.8               # P(tiền|spam): 80% spam có từ "tiền"
p_tien_ham = 0.1                # P(tiền|ham): 10% email thường có từ "tiền"

# P(tiền) = tổng xác suất gặp từ "tiền" trong mọi loại email
p_tien = p_tien_spam * p_spam + p_tien_ham * p_ham
print(f"P(gặp từ 'tiền' bất kỳ): {p_tien:.2f}")  # 0.31

# P(spam | tiền) — xác suất spam sau khi thấy từ "tiền"
p_spam_tien = (p_tien_spam * p_spam) / p_tien
print(f"P(spam | có từ 'tiền'): {p_spam_tien:.1%}")  # 77.4%
# → Từ 30% nghi ngờ, giờ tăng lên 77.4% chắc chắn là spam!
AI の場合: ベイズの定理は、多くの古典的な ML アルゴリズム (単純ベイズ、ベイジアン ニューラル ネットワーク) の基礎です。 「より多くの証拠が利用可能になるにつれて信念を更新する」というベイズ主義の考え方が AI 全体に貫かれています。
💡 演習 4.1: 電子メールに「free」という単語も含まれている場合 (P("free"|spam) = 0.6、P("free"|ham) = 0.05)、ベイズを再度適用してスパム確率を更新します (結果 77.4% を新しい事前分布として使用)。現在スパムの確率はどれくらいですか?
4.2 Softmax — 「スコアを確率に変換する」
通常の生活の例: LLM は「The cat is...」を読み、次の 5 つの単語に対してスコア (ロジット) を与えました。しかし、「スコア」は直感的には意味がありません。これを 確率 (合計 = 100%) に変換する必要があります。
| から | スコア (ロジット) | 確率 (ソフトマックス) |
|---|---|---|
| 「睡眠」 | 2.1 | 33.9% |
| 「食べる」 | 1.5 | 18.6% |
| 「走る」 | 0.3 | 5.6% |
| 「飛ぶ」 | -0.8 | 1.9% |
| "読む" | 1.9 | 27.8% |
Softmax は 2 つのことを行います: (1) すべての数値を正に変換し、(2) 合計 = 1 を正規化します。
def softmax(x):
    x_shifted = x - np.max(x)  # Trừ max để tránh overflow (e^1000 = ∞!)
    exp_x = np.exp(x_shifted)  # Biến thành dương
    return exp_x / np.sum(exp_x)  # Chuẩn hóa tổng = 1

logits = np.array([2.1, 1.5, 0.3, -0.8, 1.9])
probs = softmax(logits)

tokens = ["ngủ", "ăn", "chạy", "bay", "đọc"]
print("Xác suất từ tiếp theo:")
for token, p in zip(tokens, probs):
    bar = "█" * int(p * 50)
    print(f"  '{token}': {p:.1%} {bar}")

print(f"\nTổng: {probs.sum():.6f}")  # Luôn = 1.0
出力:
  'ngủ':  33.9% █████████████████
  'ăn':   18.6% █████████
  'chạy':  5.6% ██
  'bay':   1.9%
  'đọc':  27.8% █████████████
興味深いメモ: ChatGPT を使用する場合、パラメータ
temperature「創造性レベル」をコントロールします。温度が高い→確率がより均一(創造性)、温度が低い→最も高い点から集中します(創造性が低い)。
💡 演習 4.2:
- 温度を使用してソフトマックスを実装します。
softmax(x / T)。上記のロジットで T=0.5、T=1.0、T=2.0 を試してください。確率分布がどのように変化するかを観察します。- T → 0 の場合、ソフトマックスはどのような結果を与えますか? T → ∞ になるとどうなるでしょうか?
4.3 クロスエントロピー損失 — 「間違ったレベルの測定」
通常の生活の例: 4 つの回答 (A、B、C、D) がある多肢選択テスト。正解はBです。
- 自信を持って B (90%) を選択 → ほぼ正しい → 損失が少ない
- あなたは自信を持って D (90%) を選択します → あなたは間違っています → 非常に大きな損失
- 各回答に対して 25% をランダムに推測します → 平均損失
モデルに自信があるが間違っている場合、クロスエントロピー 重いペナルティが発生します。
# Đáp án đúng: từ tiếp theo là "ngủ" (index 0)
y_true = np.array([1, 0, 0, 0, 0])  # One-hot: chỉ "ngủ" = 1

# Dự đoán tốt: model tự tin "ngủ" đúng
y_good = softmax(np.array([3.0, 0.5, 0.1, -1.0, 0.5]))
# Dự đoán tệ: model nghĩ là "bay"
y_bad  = softmax(np.array([-1.0, 0.5, 0.1, 3.0, 0.5]))

def cross_entropy(y_true, y_pred, eps=1e-15):
    y_pred = np.clip(y_pred, eps, 1)  # Tránh log(0) = -∞
    return -np.sum(y_true * np.log(y_pred))

print(f"Loss (dự đoán tốt): {cross_entropy(y_true, y_good):.4f}")  # Nhỏ ≈ 0.1
print(f"Loss (dự đoán tệ):  {cross_entropy(y_true, y_bad):.4f}")   # Lớn ≈ 4.0

# Perplexity = "mức bối rối" = exp(loss)
# PPL thấp = model ít bối rối = dự đoán tốt
# PPL = 1 → hoàn hảo, PPL = 50000 → đoán bừa
avg_loss = 2.3
ppl = np.exp(avg_loss)
print(f"\nPerplexity: {ppl:.2f} (mô hình tốt thường < 20)")
💡 演習 4.3:
- y_true = [0, 1, 0]、y_pred = [0.1, 0.8, 0.1] について、手動で (電卓を使用して) クロスエントロピーを計算します。ヒント: -log(0.8) = ?
- モデルが y_pred = [0, 1, 0] を完全に予測する場合、クロスエントロピー = ?なぜ?
- 実際の連絡先: ChatGPT がモデルの複雑度 = 3.5 を報告している場合、これは何を意味しますか?
レッスンの概要
| トピックス | 簡単な理解 | AI におけるアプリケーション |
|---|---|---|
| 内積 | 2 つのベクトルの類似性の測定 | 注意メカニズム |
| 行列乗算 | 「フィルター」を通じてデータを変換する | 線状層 |
| デリバティブ | 変化率 | 調整方法を知る |
| チェーンルール | 影響率を乗算する | バックプロパゲーション |
| 勾配降下法 | 下り坂を下りて底を探します | 任意のモデルをトレーニングする |
| ソフトマックス | スコア → 確率 | LLMの出力層 |
| クロスエントロピー | 「間違った」レベルの測定 | 損失関数トレーニング |
一般的な演習
- ✅ 各セクションの小さな演習をすべて完了します (1.1、1.2、1.3、1.4、2.1、2.2、2.3、3、4.1、4.2、4.3)。
- 勾配降下法を実装して、次の最小値を見つけます。
f(x, y) = (x-3)² + (y+2)²開始点 (0, 0) から。結果は (3, -2) になるはずです - ミニプロジェクト: 簡単な「映画のおすすめ」システムを作成します。
- 5 ユーザーの場合、各ユーザーは 4 つの映画を評価します (1→5)
- コサイン類似度を使用して最も類似したユーザーを見つけます
- ユーザー A が見たことはないが、A が好きなユーザーが好む映画を提案する
- 元の記事「Attending Is All You Need」(2017 年)の要約を次の URL で読んでください。
arxiv.org/abs/1706.03762— 記事のどこで、そしてなぜ「ドット積」について言及しているのかを調べてください。
次のレッスン: この数学を使用して、ニューラル ネットワーク をゼロから構築します。これは、あらゆる AI モデルの中核であるニューラル ネットワークです。