簡介
數學是人工智慧模型用來「思考」的語言。但別擔心—你不必成為數學家才能理解人工智慧!本文重點在於真正需要什麼,首先用現實生活中的範例進行解釋,然後進入程式碼。
學習技巧: 每節都有實際例子→說明性代碼→小練習。如果您不明白任何部分,請先閱讀實際範例。
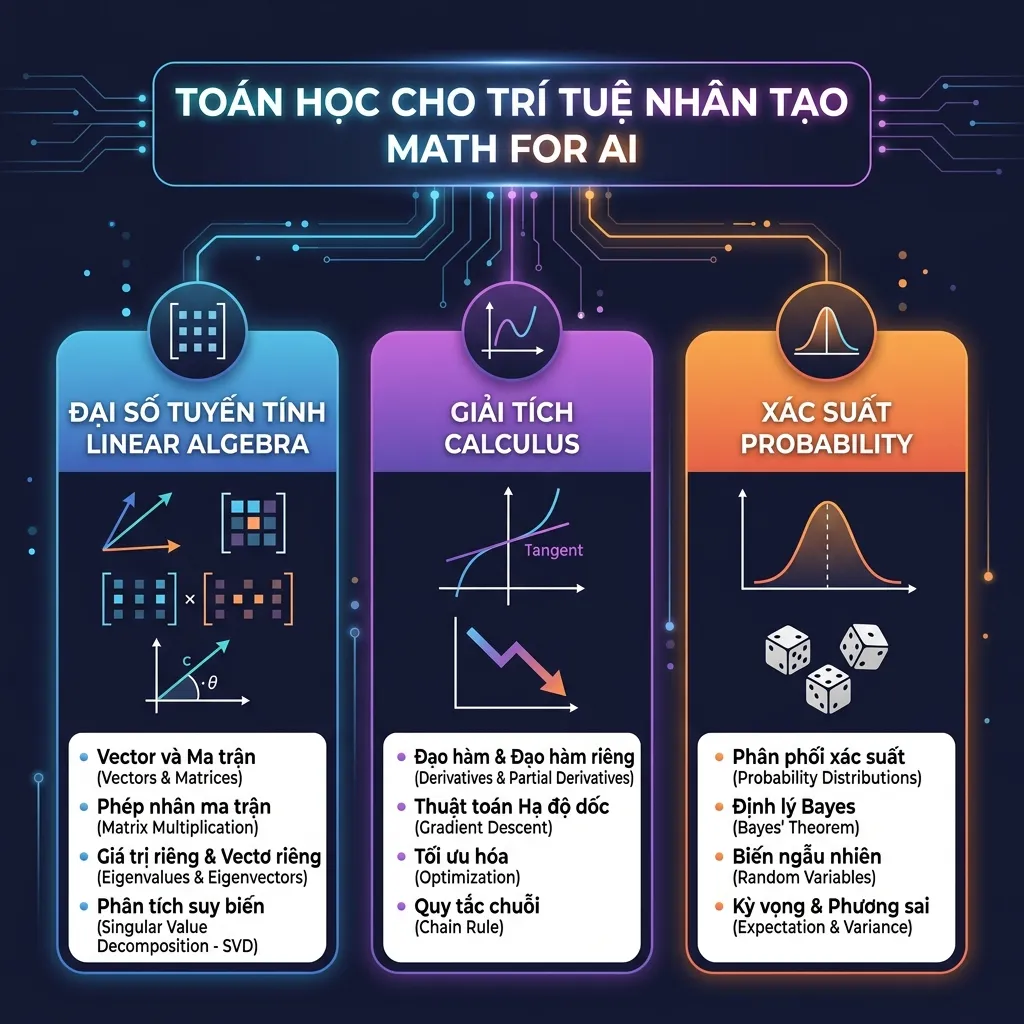
本課主要分為4個部分:
| 部分 | 你會學到 | 為什麼需要人工智慧 |
|---|---|---|
| 1.線性代數 | 向量、矩陣、點積 | 資料表示與轉換 |
| 2.微積分 | 導數、鍊式法則 | 知道如何「學習」-模型調優 |
| 3.梯度下降 | 優化演算法 | 人工智慧實際上是如何訓練的 |
| 4.機率 | 機率,Softmax | 輸出與模型評估 |
import numpy as np
import matplotlib.pyplot as plt

# Thiết lập seed để kết quả tái tạo được
np.random.seed(42)
1. 線性代數——線性代數
快速總結
💡 一句話: 線性代數幫助AI表示和轉換資料。人工智慧中的一切——文字、圖像、聲音——都被轉換成數字(向量/矩陣)供電腦處理。
1.1 標量、向量、矩陣、張量 — 簡單解釋
想像一下您正在描述天氣:
- 標量 =「今天 37°C」→ 只有 1 個數字
- 向量 =“今天37°C,濕度80%,風速15km/h” → 1行數字(多維描述)
- 矩陣 = 全週天氣表(7天×3個指標)→ 數字表
- 張量 = 50個城市的天氣資料×365天×3個指數→ 多個堆疊表
| 概念 | 現實生活中的例子 | 人工智慧中的例子 |
|---|---|---|
| 標量 | 溫度:37°C | 學習率:0.001 |
| 向量 | GPS座標:(10.8°,106.6°) | 嵌入單字「cat」:[0.2, -0.5, 0.8, ...] |
| 矩陣 | 班級成績單(學生×科目) | 批量詞嵌入 |
| 張量 | 影片(幀×高×寬×顏色) | LLM |
簡而言之: 標量 = 1 個數字,向量 = 1 行數字,矩陣 = 數字表,張量 = 多個堆疊的數字表。
# Scalar — số vô hướng (1 giá trị duy nhất)
learning_rate = 0.001  # Tốc độ học
temperature = 0.7      # "Sáng tạo" khi sinh text

# Vector — mảng 1 chiều
# Ví dụ: vị trí một quán cafe trên Google Maps cần 2 số (lat, long)
# Trong AI: mỗi từ được biểu diễn bằng hàng trăm số
word_embedding = np.array([0.2, -0.5, 0.8, 0.1, -0.3])
print(f"Vector shape: {word_embedding.shape}")  # (5,)

# Matrix — mảng 2 chiều (bảng)
# Ví dụ: bảng điểm 8 học sinh × 3 môn
# Trong AI: 8 tokens × 512 chiều embedding
batch_embeddings = np.random.randn(8, 512)
print(f"Matrix shape: {batch_embeddings.shape}")  # (8, 512)

# Tensor — mảng n chiều
# Ví dụ: 32 câu × 128 từ/câu × 512 chiều embedding
batched_sequences = np.random.randn(32, 128, 512)
print(f"Tensor shape: {batched_sequences.shape}")  # (32, 128, 512)
**💡練習1.1:**如果你有100張彩色照片,每張照片都是224×224像素,3個顏色通道(RGB)。這個張量有什麼形狀?編寫程式碼以使用 NumPy 創建隨機張量。
1.2 點積—“測量相似度”
日常生活中的例子: 你想知道兩個人是否有相似的興趣。每個人對 3 種電影類型(動作、愛情、恐怖)進行評分,從 1→5:
- An:[5,1,4](喜歡動作和恐怖)
- Binh:[4,2,5](也喜歡動作和恐怖)
- Chi: [1, 5, 1](只喜歡感情)
如果偏好相同,則點積將給出大數字,如果偏好不同,則點積將給出小。
an   = np.array([5, 1, 4])
binh = np.array([4, 2, 5])
chi  = np.array([1, 5, 1])

# Dot product: nhân tương ứng rồi cộng
# An · Bình = 5×4 + 1×2 + 4×5 = 20 + 2 + 20 = 42 → GẦN!
# An · Chi  = 5×1 + 1×5 + 4×1 = 5 + 5 + 4 = 14 → XA!
print(f"An · Bình = {np.dot(an, binh)}")  # 42 (tương đồng cao)
print(f"An · Chi  = {np.dot(an, chi)}")   # 14 (tương đồng thấp)
為什麼它在人工智慧中很重要? ** 這正是注意力機制的工作原理-測量句子中單字之間的「相關性」程度!當 ChatGPT 讀取“貓躺在椅子**”時,它使用點積知道“說謊”與“貓”的相關性比與“椅子”的相關性更強。
# Cosine Similarity — dot product đã "chuẩn hóa" (từ -1 đến 1)
# Giống đo góc giữa 2 mũi tên:
#   - Cùng hướng = 1 (rất giống)
#   - Vuông góc = 0 (không liên quan)
#   - Ngược hướng = -1 (trái ngược)
def cosine_similarity(v1, v2):
    return np.dot(v1, v2) / (np.linalg.norm(v1) * np.linalg.norm(v2))

print(f"Cosine(An, Bình) = {cosine_similarity(an, binh):.4f}")  # ~0.96 (rất giống)
print(f"Cosine(An, Chi)  = {cosine_similarity(an, chi):.4f}")   # ~0.39 (khác nhiều)
💡練習 1.2:
- 增加一個人“Dung”,其偏好為 [3, 3, 3](同樣)。計算 Dung 與 An、Binh、Chi 的餘弦相似度。誰最像鄧?
- 想想: 如果「Ha」的偏好為 [10, 2, 8](與 An 相同,但為雙倍),An 和 Ha 之間的餘弦相似度是多少?為什麼結果會是這樣呢?
1.3 矩陣乘法—“資料變換”
日常生活範例: 您有咖啡菜單(3 種飲料)和原料價格。您想要計算每種水的價格:
| 咖啡(克) | 牛奶(毫升) | 糖(克) | |
|---|---|---|---|
| 石黑 | 20 | 0 | 10 |
| 冰牛奶 | 15 | 15 50 | 50 15 |
| 底切 | 10 | 10 80 | 20 |
原料價格:咖啡= 500越南盾/克,牛奶= 30越南盾/毫升,糖= 50越南盾/克
# Menu (3 loại nước × 3 nguyên liệu)
menu = np.array([
    [20, 0,  10],   # Đen đá
    [15, 50, 15],   # Sữa đá
    [10, 80, 20],   # Bạc xỉu
])

# Giá nguyên liệu (3 nguyên liệu × 1 giá)
gia = np.array([[500], [30], [50]])

# Nhân ma trận = tính giá mỗi loại nước!
gia_nuoc = menu @ gia
print("Giá mỗi loại nước:")
for ten, g in zip(["Đen đá", "Sữa đá", "Bạc xỉu"], gia_nuoc):
    print(f"  {ten}: {int(g[0]):,}đ")
# Đen đá: 10,500đ  |  Sữa đá: 9,750đ  |  Bạc xỉu: 8,400đ
形狀規則: A (m×n) 與 B (n×p) 相乘,結果為形狀 (m×p)。 A ** 中的列數必須等於 B 中的行數。
(3, 3) @ (3, 1) = (3, 1)   ✅ 3 loại nước × 1 giá
(8, 768) @ (768, 256) = (8, 256)   ✅ Trong neural network
(3, 3) @ (2, 1) = ???       ❌ 3 ≠ 2, không nhân được!
在神經網路中: 每個線性層實際上都是一個矩陣乘法 - 將輸入資料轉換為新的形式。
# Neural network layer: output = input × W + b
batch_size, input_dim, output_dim = 32, 768, 256
X = np.random.randn(batch_size, input_dim)      # 32 câu, 768 chiều
W = np.random.randn(input_dim, output_dim) * 0.02  # Trọng số
b = np.zeros(output_dim)                         # Bias
output = X @ W + b
print(f"Linear layer: ({batch_size}, {input_dim}) → ({output.shape})")
💡練習 1.3:
- 寫一個函數
matrix_multiply(A, B)從一開始就3個循環for(未使用@不錯np.dot)。透過比較檢查結果A @ B。- 如果輸入的形狀為 (16, 512),而您想要輸出形狀為 (16, 128),則矩陣 W 必須具有什麼形狀?
1.4 轉置與範數
# Transpose — "lật" bảng (hàng → cột, cột → hàng)
# Ví dụ: bạn có bảng điểm (học sinh × môn), lật thành (môn × học sinh)
M = np.array([[1, 2, 3], [4, 5, 6]])  # (2 hàng, 3 cột)
print(f"M shape: {M.shape}")      # (2, 3)
print(f"M.T shape: {M.T.shape}")  # (3, 2) — lật!

# L2 Norm — "độ dài" vector (khoảng cách từ gốc)
# Ví dụ: bạn ở vị trí (3, 4), cách gốc tọa độ bao xa?
v = np.array([3.0, 4.0])
norm = np.linalg.norm(v)  # sqrt(3² + 4²) = 5.0
print(f"Khoảng cách: {norm}")

# Normalize — biến vector thành "vector đơn vị" (dài = 1)
# Giống như: giữ nguyên hướng đi nhưng quy về cùng 1 bước chân
# Rất quan trọng trong AI — word embeddings luôn được normalize!
v_unit = v / np.linalg.norm(v)
print(f"Unit vector: {v_unit}, length = {np.linalg.norm(v_unit):.6f}")  # 1.0
💡練習 1.4: 給定 3 個向量:a = [1, 0, 0],b = [0, 1, 0],c = [1, 1, 0]。將向量c歸一化,然後計算c(歸一化後)與a、b之間的餘弦相似度。將結果與標準化前進行比較。
2. 微積分 — 微積分
快速總結
💡 **一句話:**微積分告訴AI 應該如何調整才能更好地預測。導數=“變化率”=“前進方向”。
2.1 導數—“變化率”
正常生活範例: 你開車,車速表顯示60公里/小時。這個數字是距離隨時間的導數 - 它告訴您距離變化的速度有多快。
另一個更熟悉的例子:
- 你正在減肥。本週您減掉了 0.5 公斤 → 體重隨時間的導數 = -0.5 公斤/週
- 下週你只會損失0.1公斤 → 導數 = -0.1 → 損失速度減慢!
在人工智慧中:導數顯示了當我們改變權重時損失如何變化——從那裡我們知道要向哪個方向調整權重。
# f(x) = x² → f'(x) = 2x
# Tại x=3: f'(3) = 6 → nếu x tăng 1 nhỏ, f(x) tăng ~6
def f(x):
    return x**2

# Cách tính đạo hàm bằng số (không cần biết công thức)
# Ý tưởng: lấy 2 điểm rất gần nhau, tính độ dốc
# f'(x) ≈ [f(x + h) - f(x - h)] / (2h)
def numerical_gradient(func, x, h=1e-5):
    return (func(x + h) - func(x - h)) / (2 * h)

x = 3.0
print(f"f'(3) công thức: {2*x}")                    # 6.0
print(f"f'(3) tính số:   {numerical_gradient(f, x):.6f}")  # 6.000000
💡練習 2.1:
- 設 f(x) = x3 - 2x。使用公式 (3x² - 2) 計算 f'(x) 並等於
numerical_gradient。比較 x = 2 處的結果。- 設 f(x) = sin(x)。使用
numerical_gradient計算 f'(0)、f'(π/2)、f'(π)。與理論值cos(x)進行比較。
2.2 偏導數——“偏導數”
日常生活中的例子: 你正在烤蛋糕。質量取決於溫度和時間:
- 如果只提高溫度(保持時間不變)→蛋糕會發生什麼變化? → 對溫度的偏導數
- 如果只增加時間(保持溫度不變)→蛋糕會發生什麼變化? → 隨時間的偏導數
在人工智慧中:模型具有數百萬個權重(參數)。偏導數表示:「如果我只改變這個權重 w₁2₃₄₅,損失會增加還是減少?」。計算 所有 權重的偏導數 = 梯度 - 指示最快損失方向的向量。
# f(x, y) = x² + 3xy + y²
# ∂f/∂x = 2x + 3y  (đạo hàm theo x, coi y là hằng số)
# ∂f/∂y = 3x + 2y  (đạo hàm theo y, coi x là hằng số)

def f_multi(x, y):
    return x**2 + 3*x*y + y**2

h = 1e-5
x, y = 2.0, 1.0

# Tính đạo hàm riêng bằng số
# Cách làm: giữ nguyên biến kia, chỉ thay đổi biến cần tính
df_dx = (f_multi(x + h, y) - f_multi(x - h, y)) / (2 * h)
df_dy = (f_multi(x, y + h) - f_multi(x, y - h)) / (2 * h)

print(f"∂f/∂x tại (2,1): {df_dx:.4f} (lý thuyết: {2*x + 3*y})")  # 7.0
print(f"∂f/∂y tại (2,1): {df_dy:.4f} (lý thuyết: {3*x + 2*y})")  # 8.0
print(f"Gradient = [{df_dx:.1f}, {df_dy:.1f}]")  # [7.0, 8.0] — hướng loss tăng nhanh nhất
💡練習 2.2: 設 f(x, y) = (x - 3)² + (y + 2)²。這是一個底數為 (3, -2) 的「拋物面」函數。計算 (0, 0) 和 (3, -2) 處的梯度。底部的梯度是多少?為什麼?
2.3 鍊式法則—“鍊式法則”
日常生活範例:您想知道汽油價格對牛肉麵價格有多大影響?
Giá xăng ↑10% → Chi phí vận chuyển ↑5% → Giá thịt bò ↑3% → Giá bún bò ↑2%
總的直接影響? 將比率相乘:10% × 0.5 × 0.6 × 0.67 ≈ 2%
這就是 鍊式法則:當 f 依賴 g 時,g 依賴 x → df/dx = df/dg × dg/dx。
為什麼這麼重要? 因為它是反向傳播的基礎—神經網路如何「學習」。在 100 層網路中,鍊式法則允許計算所有層從輸出到輸入的梯度。
# z = (x² + 1)³
# Chia thành 2 bước: g(x) = x² + 1, rồi f(g) = g³
# Chain rule: dz/dx = f'(g) × g'(x) = 3g² × 2x = 3(x²+1)² × 2x

def z(x):
    return (x**2 + 1)**3

x = 2.0
# Theo chain rule: 3 × (4+1)² × (2×2) = 3 × 25 × 4 = 300
analytical = 3 * (x**2 + 1)**2 * (2 * x)
numerical = numerical_gradient(z, x)

print(f"dz/dx công thức: {analytical}")       # 300.0
print(f"dz/dx tính số:   {numerical:.4f}")     # 300.0000
💡練習 2.3:
- 設 y = sin(x²)。使用鍊式法則計算 dy/dx:cos(x²) × 2x。檢查依據
numerical_gradient當 x = 1 時。- 更實用: 對於簡單的神經網路:輸出 = sigmoid(w × x + b)。 sigmoid(z) = 1/(1+e^(-z))。當 x=2、w=0.5、b=0 時,使用鍊式法則計算 d(output)/dw。
3. 梯度下降-神經網路的「學習演算法」。
快速總結
💡 **一句話:梯度下降就是AI如何透過在損失面上“走下坡路”,自動找到最好的一組參數。
3.1 視覺
正常生活的例子:你站在濃霧中的山上-什麼也看不見。你想去山腳下(找到最小值)。唯一的方法:感受腳周圍的地面,找到最陡的方向,向下邁一小步。重複。
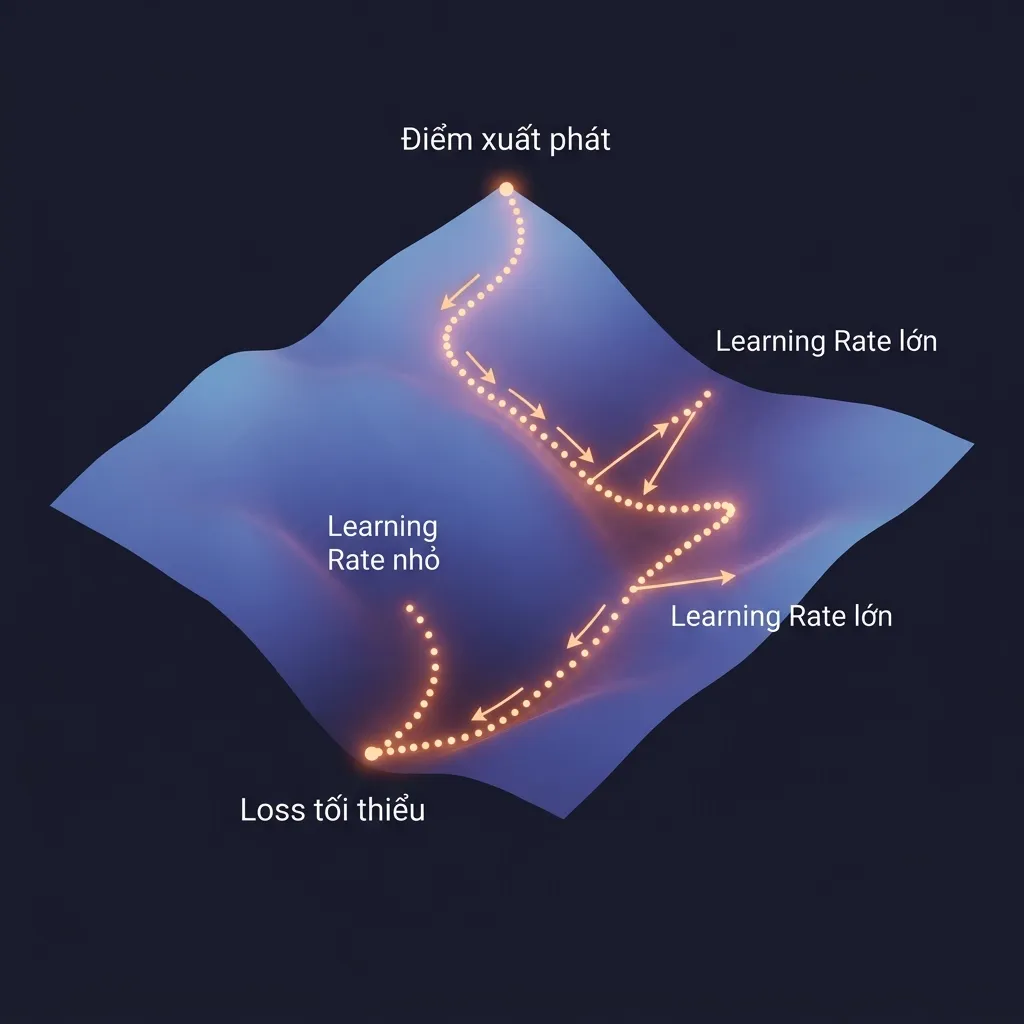
θ_new = θ_old - α × ∇L(θ)
  ↑         ↑      ↑
  vị trí   learning  hướng dốc
  mới      rate      nhất
α(學習率)= 步長- 太小→步數永遠達不到(需要 100,000 epoch)
- 太大→來回跳躍,不收斂(損失增加!)
- 中→快速穩定的收斂
∇L(θ)= 最陡方向(梯度)- 減號:與梯度方向相反(梯度表示增加方向,我們想要減少)
3.2 示範:擬合直線 y = wx + b
問題:給定數據,找到 w 和 b,使得 y ≈ wx + b。這是每個神經網路都必須經歷的第一步!
# Dữ liệu thật: y = 3x + 1.5 + noise
np.random.seed(42)
X = np.linspace(-2, 2, 100)
y_true = 3 * X + 1.5 + np.random.randn(100) * 0.3

# Bắt đầu với w, b ngẫu nhiên (chưa biết đáp án)
w = np.random.randn()  # w ban đầu
b = np.random.randn()  # b ban đầu
lr = 0.01
n = len(X)

print(f"Ban đầu: w={w:.3f}, b={b:.3f} (cần tìm: w≈3.0, b≈1.5)")

for epoch in range(500):
    # Bước 1: Dự đoán (Forward Pass)
    y_pred = w * X + b

    # Bước 2: Tính sai số (Loss = Mean Squared Error)
    loss = np.mean((y_pred - y_true) ** 2)

    # Bước 3: Tính gradient (hướng cần điều chỉnh)
    # "w cần thay đổi bao nhiêu?" và "b cần thay đổi bao nhiêu?"
    dL_dw = np.mean(2 * (y_pred - y_true) * X)
    dL_db = np.mean(2 * (y_pred - y_true))

    # Bước 4: Cập nhật w, b (đi ngược hướng gradient)
    w -= lr * dL_dw
    b -= lr * dL_db

    if epoch % 100 == 0:
        print(f"  Epoch {epoch:3d} | Loss: {loss:.4f} | w={w:.3f}, b={b:.3f}")

print(f"\nKết quả: w={w:.4f} (≈3.0), b={b:.4f} (≈1.5) ✅")
3.3 梯度下降變化
| 變體 | 每次更新時,請使用 | 優點 | 缺點 | 現實生活中的例子 |
|---|---|---|---|---|
| 批量GD | 整個資料集 | 精準梯度 | 速度慢,消耗 RAM | 閱讀所有 1000 條評論,然後做出決定 |
| 新元 | 1 個隨機樣本 | 快,退出本地分鐘 | 波動較大 | 閱讀 1 則評論,然後立即決定 |
| 小批量 | 32–256 個樣本 | 良好的平衡性 | 需要調整批量大小 | 閱讀 32 條評論然後決定 |
| 亞當 | 小批量+自適應 lr | 快速穩定收斂 | 多個超參數 | 閱讀 32 則評論 + 調整閱讀速度 |
事實: 如今幾乎每個 AI 模型都使用 Adam 或 AdamW - 從第 3 課開始,您將不斷遇到它們。
💡練習 3: 1.嘗試改變
lr = 0.1(更大)。觀察損失是否收斂。然後嘗試lr = 0.0001(太小)-需要幾個 epoch 才能收斂? 2. 挑戰: 修改上面的梯度下降程式碼以適應拋物線 y = ax² + bx + c。提示:需要 3 個變數 a、b、c 和 3 個梯度。
4.機率——機率
快速總結
💡 一句話: 機率幫助 AI 自信地做出預測 - AI 不會說“這是一隻貓”,而是說“90% 這是一隻貓,8% 是狗,2% 是兔子”。
4.1 貝葉斯定理—“更新信念”
正常生活範例: 您收到一封電子郵件。在閱讀之前,您估計 30% 的電子郵件是垃圾郵件(個人經驗)。看到一封包含「金錢」一詞的電子郵件後,您更新您的信念:垃圾郵件的可能性增加了多少?
- 在垃圾郵件中,80% 包含「金錢」一詞
- 在普通電子郵件中,10% 包含「金錢」一詞
# Bayes: P(spam|tiền) = P(tiền|spam) × P(spam) / P(tiền)
# Đọc: "Xác suất spam BIẾT RẰNG có từ tiền"

p_spam = 0.3                    # Prior: niềm tin ban đầu
p_ham = 0.7
p_tien_spam = 0.8               # P(tiền|spam): 80% spam có từ "tiền"
p_tien_ham = 0.1                # P(tiền|ham): 10% email thường có từ "tiền"

# P(tiền) = tổng xác suất gặp từ "tiền" trong mọi loại email
p_tien = p_tien_spam * p_spam + p_tien_ham * p_ham
print(f"P(gặp từ 'tiền' bất kỳ): {p_tien:.2f}")  # 0.31

# P(spam | tiền) — xác suất spam sau khi thấy từ "tiền"
p_spam_tien = (p_tien_spam * p_spam) / p_tien
print(f"P(spam | có từ 'tiền'): {p_spam_tien:.1%}")  # 77.4%
# → Từ 30% nghi ngờ, giờ tăng lên 77.4% chắc chắn là spam!
在人工智慧中: 貝葉斯定理是許多經典機器學習演算法(樸素貝葉斯、貝葉斯神經網路)的基礎。貝葉斯思維——「隨著更多證據的出現而更新信念」——貫穿整個人工智慧。
💡練習 4.1: 如果電子郵件還包含單字「free」(P(“free”|spam) = 0.6,P(“free”|ham) = 0.05),則透過再次應用貝葉斯來更新垃圾郵件機率(使用結果 77.4% 作為新的先驗)。現在垃圾郵件的機率是多少?
4.2 Softmax —“將分數轉換為機率”
正常生活範例: LLM 剛剛讀到「The cat is...」並給出了接下來 5 個單字的分數(logits)。但「分數」沒有直覺意義——我們需要將其轉換為機率(總和 = 100%):
| 來自 | 分數(對數) | 機率 (softmax) |
|---|---|---|
| 「睡覺」 | 2.1 | 2.1 33.9% |
| 「吃」 | 1.5 | 1.5 18.6% |
| 「跑」 | 0.3 | 0.3 5.6% |
| 「飛」 | -0.8 | -0.8 1.9% |
| “閱讀” | 1.9 | 1.9 27.8% |
Softmax 做了兩件事:(1) 將每個數字變成正數,(2) 將總和歸一化為 1。
def softmax(x):
    x_shifted = x - np.max(x)  # Trừ max để tránh overflow (e^1000 = ∞!)
    exp_x = np.exp(x_shifted)  # Biến thành dương
    return exp_x / np.sum(exp_x)  # Chuẩn hóa tổng = 1

logits = np.array([2.1, 1.5, 0.3, -0.8, 1.9])
probs = softmax(logits)

tokens = ["ngủ", "ăn", "chạy", "bay", "đọc"]
print("Xác suất từ tiếp theo:")
for token, p in zip(tokens, probs):
    bar = "█" * int(p * 50)
    print(f"  '{token}': {p:.1%} {bar}")

print(f"\nTổng: {probs.sum():.6f}")  # Luôn = 1.0
輸出:
  'ngủ':  33.9% █████████████████
  'ăn':   18.6% █████████
  'chạy':  5.6% ██
  'bay':   1.9%
  'đọc':  27.8% █████████████
有趣的說明: 使用 ChatGPT 時,參數
temperature控制「創造力水平」:溫度高→機率更均勻(創造力),溫度低→從最高點開始關注(創造力較少)。
💡練習 4.2:
- 實現帶有溫度的softmax:
softmax(x / T)。使用上述 logits 嘗試 T=0.5、T=1.0、T=2.0。觀察機率分佈如何變化。 2.當T→0時,softmax會給出什麼結果?當 T → ∞ 時會發生什麼事?
4.3 交叉熵損失 — “測量錯誤的水平”
正常生活範例: 多項選擇測試,有 4 個答案(A、B、C、D)。正確答案是B。
- 你自信地選擇 B (90%) → 你幾乎是正確的 → 低損失
- 你自信地選擇 D (90%) → 你錯了 → 損失非常高
- 你隨機猜測每個答案的 25% → 平均損失
當模型有信心但錯誤時,交叉熵重罰!
# Đáp án đúng: từ tiếp theo là "ngủ" (index 0)
y_true = np.array([1, 0, 0, 0, 0])  # One-hot: chỉ "ngủ" = 1

# Dự đoán tốt: model tự tin "ngủ" đúng
y_good = softmax(np.array([3.0, 0.5, 0.1, -1.0, 0.5]))
# Dự đoán tệ: model nghĩ là "bay"
y_bad  = softmax(np.array([-1.0, 0.5, 0.1, 3.0, 0.5]))

def cross_entropy(y_true, y_pred, eps=1e-15):
    y_pred = np.clip(y_pred, eps, 1)  # Tránh log(0) = -∞
    return -np.sum(y_true * np.log(y_pred))

print(f"Loss (dự đoán tốt): {cross_entropy(y_true, y_good):.4f}")  # Nhỏ ≈ 0.1
print(f"Loss (dự đoán tệ):  {cross_entropy(y_true, y_bad):.4f}")   # Lớn ≈ 4.0

# Perplexity = "mức bối rối" = exp(loss)
# PPL thấp = model ít bối rối = dự đoán tốt
# PPL = 1 → hoàn hảo, PPL = 50000 → đoán bừa
avg_loss = 2.3
ppl = np.exp(avg_loss)
print(f"\nPerplexity: {ppl:.2f} (mô hình tốt thường < 20)")
💡練習 4.3:
- 手動計算交叉熵(使用計算機):y_true = [0, 1, 0],y_pred = [0.1, 0.8, 0.1]。提示:-log(0.8) = ?
- 如果模型完美預測 y_pred = [0, 1, 0],則交叉熵 = ?為什麼?
- 實際聯繫: 當您看到 ChatGPT 報告某個模型的困惑度 = 3.5 時,這意味著什麼?
課程總結
| 主題 | 簡單理解 | 人工智慧中的應用 |
|---|---|---|
| 點積 | 測量兩個向量的相似度 | 注意力機制 |
| 矩陣乘法 | 透過「過濾器」轉換資料 | 線性圖層 |
| 衍生性商品 | 變化率 | 知道如何調整 |
| 鍊式法則 | 乘以影響力比率 | 反向傳播 |
| 梯度下降 | 下山尋底 | 訓練任何模型 |
| Softmax | 分數 → 機率 | LLM輸出層 |
| 交叉熵 | 測量「錯誤」水平 | 損失函數訓練 |
一般練習
- ✅ 完成每個部分的所有小練習(1.1, 1.2, 1.3, 1.4, 2.1, 2.2, 2.3, 3, 4.1, 4.2, 4.3)
- 實施梯度下降來找出最小值
f(x, y) = (x-3)² + (y+2)²從起點 (0, 0) 開始。結果應該是 (3, -2) - 迷你專案: 創建一個簡單的「推薦電影」系統:
- 對於 5 位用戶,每位用戶對 4 部電影進行評分(1→5)
- 使用餘弦相似度來尋找最相似的用戶
- 推薦用戶A沒看過但用戶喜歡A喜歡的電影
- 閱讀原文「Attention Is All You Need」(2017)的摘要:
arxiv.org/abs/1706.03762—找出文章提到「點積」的位置和原因。
下一課: 我們將使用這個數學從頭開始建立 神經網路 - 神經網絡,每個人工智慧模型的核心。