Giới thiệu
Toán học là ngôn ngữ mà các mô hình AI dùng để "suy nghĩ". Nhưng đừng lo — bạn không cần phải là nhà toán học để hiểu AI! Bài này tập trung vào những gì thực sự cần thiết, giải thích bằng ví dụ đời thường trước, rồi mới đi vào code.
Mẹo học: Mỗi phần đều có ví dụ thực tế → code minh họa → bài tập nhỏ. Nếu phần nào chưa hiểu, đọc lại ví dụ thực tế trước.
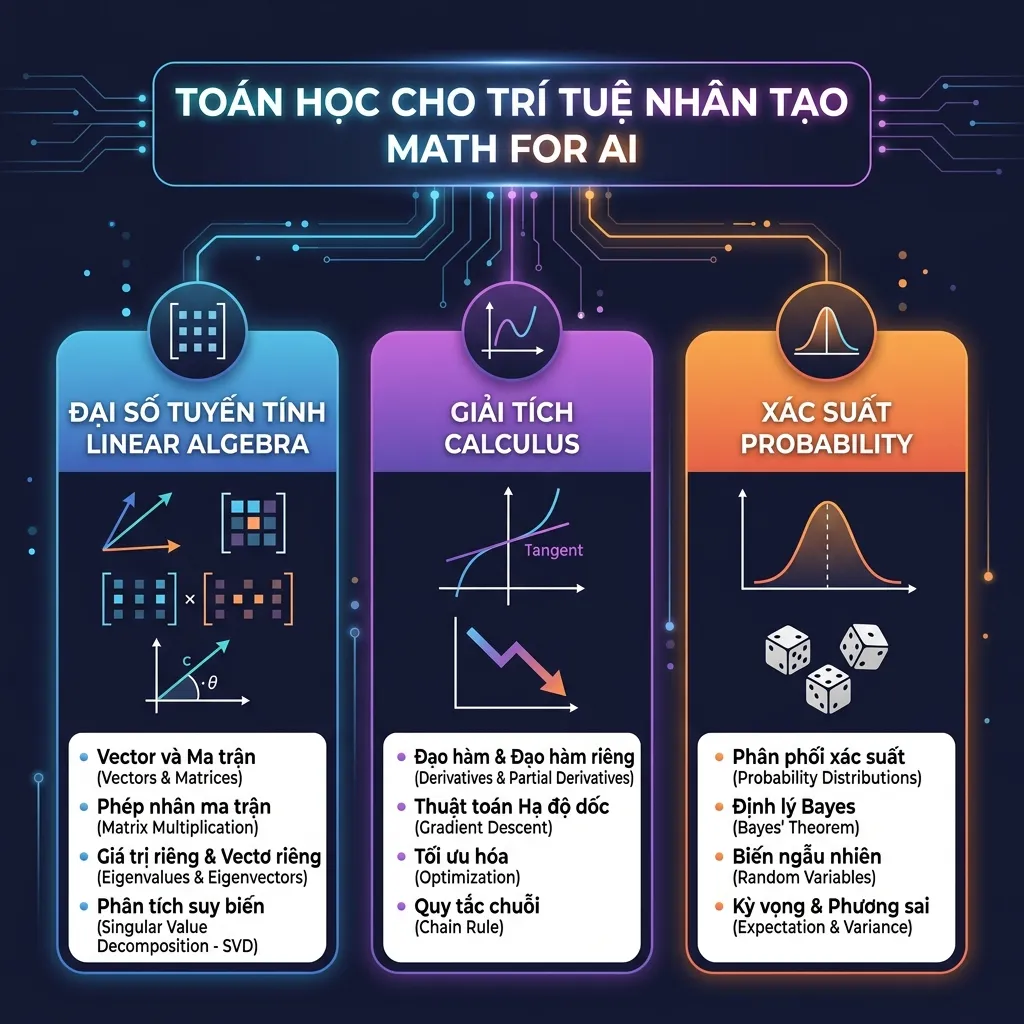
Bài học này chia thành 4 phần chính:
| Phần | Bạn sẽ học | Tại sao cần cho AI |
|---|---|---|
| 1. Linear Algebra | Vector, Matrix, Dot Product | Biểu diễn & biến đổi dữ liệu |
| 2. Calculus | Đạo hàm, Chain Rule | Biết cách "học" — điều chỉnh mô hình |
| 3. Gradient Descent | Thuật toán tối ưu | Cách AI thực sự được huấn luyện |
| 4. Probability | Xác suất, Softmax | Output & đánh giá mô hình |
import numpy as np
import matplotlib.pyplot as plt

# Thiết lập seed để kết quả tái tạo được
np.random.seed(42)
1. Linear Algebra — Đại số tuyến tính
Tóm tắt nhanh
💡 Một câu: Linear Algebra giúp AI biểu diễn và biến đổi dữ liệu. Mọi thứ trong AI — từ, ảnh, âm thanh — đều được chuyển thành số (vector/matrix) để máy tính xử lý được.
1.1 Scalar, Vector, Matrix, Tensor — Giải thích đơn giản
Hãy tưởng tượng bạn đang mô tả thời tiết:
- Scalar = "Hôm nay 37°C" → chỉ 1 số
- Vector = "Hôm nay 37°C, độ ẩm 80%, gió 15km/h" → 1 hàng số (mô tả nhiều chiều)
- Matrix = Bảng thời tiết cả tuần (7 ngày × 3 chỉ số) → bảng số
- Tensor = Dữ liệu thời tiết của 50 thành phố × 365 ngày × 3 chỉ số → nhiều bảng xếp chồng
| Khái niệm | Ví dụ đời thường | Ví dụ trong AI |
|---|---|---|
| Scalar | Nhiệt độ: 37°C | Learning rate: 0.001 |
| Vector | Tọa độ GPS: (10.8°, 106.6°) | Embedding của từ "mèo": [0.2, -0.5, 0.8, ...] |
| Matrix | Bảng điểm lớp (học sinh × môn) | Batch of word embeddings |
| Tensor | Video (frame × chiều cao × chiều rộng × màu) | Batch of sequences trong LLM |
Tóm lại: Scalar = 1 số, Vector = 1 hàng số, Matrix = bảng số, Tensor = nhiều bảng số xếp chồng.
# Scalar — số vô hướng (1 giá trị duy nhất)
learning_rate = 0.001  # Tốc độ học
temperature = 0.7      # "Sáng tạo" khi sinh text

# Vector — mảng 1 chiều
# Ví dụ: vị trí một quán cafe trên Google Maps cần 2 số (lat, long)
# Trong AI: mỗi từ được biểu diễn bằng hàng trăm số
word_embedding = np.array([0.2, -0.5, 0.8, 0.1, -0.3])
print(f"Vector shape: {word_embedding.shape}")  # (5,)

# Matrix — mảng 2 chiều (bảng)
# Ví dụ: bảng điểm 8 học sinh × 3 môn
# Trong AI: 8 tokens × 512 chiều embedding
batch_embeddings = np.random.randn(8, 512)
print(f"Matrix shape: {batch_embeddings.shape}")  # (8, 512)

# Tensor — mảng n chiều
# Ví dụ: 32 câu × 128 từ/câu × 512 chiều embedding
batched_sequences = np.random.randn(32, 128, 512)
print(f"Tensor shape: {batched_sequences.shape}")  # (32, 128, 512)
💡 Bài tập 1.1: Nếu bạn có 100 bức ảnh màu, mỗi ảnh 224×224 pixels, 3 kênh màu (RGB). Tensor này có shape là gì? Viết code tạo tensor ngẫu nhiên đó bằng NumPy.
1.2 Dot Product — "Đo mức tương đồng"
Ví dụ đời thường: Bạn muốn biết 2 người có sở thích giống nhau không. Mỗi người đánh giá 3 thể loại phim (hành động, tình cảm, kinh dị) từ 1→5:
- An: [5, 1, 4] (thích hành động & kinh dị)
- Bình: [4, 2, 5] (cũng thích hành động & kinh dị)
- Chi: [1, 5, 1] (chỉ thích tình cảm)
Dot product sẽ cho số lớn nếu sở thích giống nhau, nhỏ nếu khác nhau.
an   = np.array([5, 1, 4])
binh = np.array([4, 2, 5])
chi  = np.array([1, 5, 1])

# Dot product: nhân tương ứng rồi cộng
# An · Bình = 5×4 + 1×2 + 4×5 = 20 + 2 + 20 = 42 → GẦN!
# An · Chi  = 5×1 + 1×5 + 4×1 = 5 + 5 + 4 = 14 → XA!
print(f"An · Bình = {np.dot(an, binh)}")  # 42 (tương đồng cao)
print(f"An · Chi  = {np.dot(an, chi)}")   # 14 (tương đồng thấp)
Tại sao quan trọng trong AI? Đây chính xác là cách Attention mechanism hoạt động — đo mức độ "liên quan" giữa các từ trong câu! Khi ChatGPT đọc "Con mèo đang nằm trên chiếc ghế", nó dùng dot product để biết "nằm" liên quan mạnh đến "mèo" hơn là "ghế".
# Cosine Similarity — dot product đã "chuẩn hóa" (từ -1 đến 1)
# Giống đo góc giữa 2 mũi tên:
#   - Cùng hướng = 1 (rất giống)
#   - Vuông góc = 0 (không liên quan)
#   - Ngược hướng = -1 (trái ngược)
def cosine_similarity(v1, v2):
    return np.dot(v1, v2) / (np.linalg.norm(v1) * np.linalg.norm(v2))

print(f"Cosine(An, Bình) = {cosine_similarity(an, binh):.4f}")  # ~0.96 (rất giống)
print(f"Cosine(An, Chi)  = {cosine_similarity(an, chi):.4f}")   # ~0.39 (khác nhiều)
💡 Bài tập 1.2:
- Thêm một người "Dung" với sở thích [3, 3, 3] (thích đều). Tính cosine similarity của Dung với An, Bình, Chi. Ai giống Dung nhất?
- Thử nghĩ: Nếu "Hà" có sở thích [10, 2, 8] (giống An nhưng gấp đôi), cosine similarity giữa An và Hà là bao nhiêu? Tại sao kết quả lại như vậy?
1.3 Matrix Multiplication — "Biến đổi dữ liệu"
Ví dụ đời thường: Bạn có menu cafe (3 loại nước) và giá nguyên liệu. Bạn muốn tính giá mỗi loại nước:
| Cà phê (g) | Sữa (ml) | Đường (g) | |
|---|---|---|---|
| Đen đá | 20 | 0 | 10 |
| Sữa đá | 15 | 50 | 15 |
| Bạc xỉu | 10 | 80 | 20 |
Giá nguyên liệu: Cà phê = 500đ/g, Sữa = 30đ/ml, Đường = 50đ/g
# Menu (3 loại nước × 3 nguyên liệu)
menu = np.array([
    [20, 0,  10],   # Đen đá
    [15, 50, 15],   # Sữa đá
    [10, 80, 20],   # Bạc xỉu
])

# Giá nguyên liệu (3 nguyên liệu × 1 giá)
gia = np.array([[500], [30], [50]])

# Nhân ma trận = tính giá mỗi loại nước!
gia_nuoc = menu @ gia
print("Giá mỗi loại nước:")
for ten, g in zip(["Đen đá", "Sữa đá", "Bạc xỉu"], gia_nuoc):
    print(f"  {ten}: {int(g[0]):,}đ")
# Đen đá: 10,500đ  |  Sữa đá: 9,750đ  |  Bạc xỉu: 8,400đ
Quy tắc shape: Khi nhân A (m×n) với B (n×p), kết quả có shape (m×p). Số cột của A phải bằng số hàng của B.
(3, 3) @ (3, 1) = (3, 1)   ✅ 3 loại nước × 1 giá
(8, 768) @ (768, 256) = (8, 256)   ✅ Trong neural network
(3, 3) @ (2, 1) = ???       ❌ 3 ≠ 2, không nhân được!
Trong Neural Network: Mỗi linear layer chính xác là một phép nhân ma trận — biến đổi dữ liệu đầu vào thành dạng mới.
# Neural network layer: output = input × W + b
batch_size, input_dim, output_dim = 32, 768, 256
X = np.random.randn(batch_size, input_dim)      # 32 câu, 768 chiều
W = np.random.randn(input_dim, output_dim) * 0.02  # Trọng số
b = np.zeros(output_dim)                         # Bias
output = X @ W + b
print(f"Linear layer: ({batch_size}, {input_dim}) → ({output.shape})")
💡 Bài tập 1.3:
- Viết hàm
matrix_multiply(A, B)từ đầu bằng 3 vòng lặpfor(không dùng@haynp.dot). Kiểm tra kết quả bằng cách so sánh vớiA @ B.- Nếu input có shape (16, 512) và bạn muốn output shape (16, 128), matrix W phải có shape gì?
1.4 Transpose và Norm
# Transpose — "lật" bảng (hàng → cột, cột → hàng)
# Ví dụ: bạn có bảng điểm (học sinh × môn), lật thành (môn × học sinh)
M = np.array([[1, 2, 3], [4, 5, 6]])  # (2 hàng, 3 cột)
print(f"M shape: {M.shape}")      # (2, 3)
print(f"M.T shape: {M.T.shape}")  # (3, 2) — lật!

# L2 Norm — "độ dài" vector (khoảng cách từ gốc)
# Ví dụ: bạn ở vị trí (3, 4), cách gốc tọa độ bao xa?
v = np.array([3.0, 4.0])
norm = np.linalg.norm(v)  # sqrt(3² + 4²) = 5.0
print(f"Khoảng cách: {norm}")

# Normalize — biến vector thành "vector đơn vị" (dài = 1)
# Giống như: giữ nguyên hướng đi nhưng quy về cùng 1 bước chân
# Rất quan trọng trong AI — word embeddings luôn được normalize!
v_unit = v / np.linalg.norm(v)
print(f"Unit vector: {v_unit}, length = {np.linalg.norm(v_unit):.6f}")  # 1.0
💡 Bài tập 1.4: Cho 3 vector: a = [1, 0, 0], b = [0, 1, 0], c = [1, 1, 0]. Normalize vector c rồi tính cosine similarity giữa c (đã normalize) và a, b. So sánh kết quả với khi chưa normalize.
2. Calculus — Giải tích
Tóm tắt nhanh
💡 Một câu: Calculus cho AI biết nên điều chỉnh như thế nào để dự đoán tốt hơn. Đạo hàm = "tốc độ thay đổi" = "hướng cần đi".
2.1 Đạo hàm — "Tốc độ thay đổi"
Ví dụ đời thường: Bạn lái xe, đồng hồ tốc độ hiện 60 km/h. Con số này chính là đạo hàm của quãng đường theo thời gian — nó cho biết quãng đường đang thay đổi nhanh bao nhiêu.
Một ví dụ khác gần gũi hơn:
- Bạn đang giảm cân. Tuần này bạn giảm được 0.5 kg → đạo hàm cân nặng theo thời gian = -0.5 kg/tuần
- Tuần sau bạn chỉ giảm 0.1 kg → đạo hàm = -0.1 → tốc độ giảm chậm lại!
Trong AI: Đạo hàm cho biết loss đang thay đổi ra sao khi ta thay đổi trọng số — từ đó biết nên điều chỉnh trọng số theo hướng nào.
# f(x) = x² → f'(x) = 2x
# Tại x=3: f'(3) = 6 → nếu x tăng 1 nhỏ, f(x) tăng ~6
def f(x):
    return x**2

# Cách tính đạo hàm bằng số (không cần biết công thức)
# Ý tưởng: lấy 2 điểm rất gần nhau, tính độ dốc
# f'(x) ≈ [f(x + h) - f(x - h)] / (2h)
def numerical_gradient(func, x, h=1e-5):
    return (func(x + h) - func(x - h)) / (2 * h)

x = 3.0
print(f"f'(3) công thức: {2*x}")                    # 6.0
print(f"f'(3) tính số:   {numerical_gradient(f, x):.6f}")  # 6.000000
💡 Bài tập 2.1:
- Cho f(x) = x³ - 2x. Tính f'(x) bằng công thức (3x² - 2) và bằng
numerical_gradient. So sánh kết quả tại x = 2.- Cho f(x) = sin(x). Dùng
numerical_gradientđể tính f'(0), f'(π/2), f'(π). So sánh với giá trị lý thuyết cos(x).
2.2 Partial Derivatives — "Đạo hàm riêng"
Ví dụ đời thường: Bạn đang nướng bánh. Chất lượng phụ thuộc vào nhiệt độ và thời gian:
- Nếu chỉ tăng nhiệt độ (giữ nguyên thời gian) → bánh thay đổi thế nào? → Đạo hàm riêng theo nhiệt độ
- Nếu chỉ tăng thời gian (giữ nguyên nhiệt độ) → bánh thay đổi thế nào? → Đạo hàm riêng theo thời gian
Trong AI: Mô hình có hàng triệu trọng số (parameters). Đạo hàm riêng cho biết: "Nếu tôi chỉ thay đổi trọng số w₁₂₃₄₅ này, loss sẽ tăng hay giảm?". Tính đạo hàm riêng cho tất cả trọng số = gradient — vector chỉ hướng loss giảm nhanh nhất.
# f(x, y) = x² + 3xy + y²
# ∂f/∂x = 2x + 3y  (đạo hàm theo x, coi y là hằng số)
# ∂f/∂y = 3x + 2y  (đạo hàm theo y, coi x là hằng số)

def f_multi(x, y):
    return x**2 + 3*x*y + y**2

h = 1e-5
x, y = 2.0, 1.0

# Tính đạo hàm riêng bằng số
# Cách làm: giữ nguyên biến kia, chỉ thay đổi biến cần tính
df_dx = (f_multi(x + h, y) - f_multi(x - h, y)) / (2 * h)
df_dy = (f_multi(x, y + h) - f_multi(x, y - h)) / (2 * h)

print(f"∂f/∂x tại (2,1): {df_dx:.4f} (lý thuyết: {2*x + 3*y})")  # 7.0
print(f"∂f/∂y tại (2,1): {df_dy:.4f} (lý thuyết: {3*x + 2*y})")  # 8.0
print(f"Gradient = [{df_dx:.1f}, {df_dy:.1f}]")  # [7.0, 8.0] — hướng loss tăng nhanh nhất
💡 Bài tập 2.2: Cho f(x, y) = (x - 3)² + (y + 2)². Đây là hàm "bát úp" (paraboloid) có đáy tại (3, -2). Tính gradient tại (0, 0) và tại (3, -2). Gradient tại đáy bằng bao nhiêu? Tại sao?
2.3 Chain Rule — "Quy tắc dây chuyền"
Ví dụ đời thường: Bạn muốn biết giá xăng ảnh hưởng giá bún bò bao nhiêu?
Giá xăng ↑10% → Chi phí vận chuyển ↑5% → Giá thịt bò ↑3% → Giá bún bò ↑2%
Tổng ảnh hưởng trực tiếp? Nhân các tỷ lệ với nhau: 10% × 0.5 × 0.6 × 0.67 ≈ 2%
Đây chính là chain rule: khi f phụ thuộc g, g phụ thuộc x → df/dx = df/dg × dg/dx.
Tại sao cực kỳ quan trọng? Vì nó là nền tảng của Backpropagation — cách neural network "học" được. Trong network 100 lớp, chain rule cho phép tính gradient từ output ngược về input qua tất cả các lớp.
# z = (x² + 1)³
# Chia thành 2 bước: g(x) = x² + 1, rồi f(g) = g³
# Chain rule: dz/dx = f'(g) × g'(x) = 3g² × 2x = 3(x²+1)² × 2x

def z(x):
    return (x**2 + 1)**3

x = 2.0
# Theo chain rule: 3 × (4+1)² × (2×2) = 3 × 25 × 4 = 300
analytical = 3 * (x**2 + 1)**2 * (2 * x)
numerical = numerical_gradient(z, x)

print(f"dz/dx công thức: {analytical}")       # 300.0
print(f"dz/dx tính số:   {numerical:.4f}")     # 300.0000
💡 Bài tập 2.3:
- Cho y = sin(x²). Tính dy/dx bằng chain rule: cos(x²) × 2x. Kiểm tra bằng
numerical_gradienttại x = 1.- Thực tế hơn: Cho neural network đơn giản: output = sigmoid(w × x + b). Với sigmoid(z) = 1/(1+e^(-z)). Tính d(output)/dw bằng chain rule khi x=2, w=0.5, b=0.
3. Gradient Descent — "Thuật toán học" của Neural Network
Tóm tắt nhanh
💡 Một câu: Gradient Descent là cách AI tự động tìm bộ tham số tốt nhất bằng cách "đi xuống dốc" trên bề mặt loss.
3.1 Trực quan
Ví dụ đời thường: Bạn đứng trên ngọn núi trong sương mù dày đặc — không nhìn thấy gì. Bạn muốn xuống chân núi (tìm minimum). Cách duy nhất: sờ mặt đất quanh chân, tìm hướng dốc nhất, bước xuống một bước nhỏ. Lặp lại.
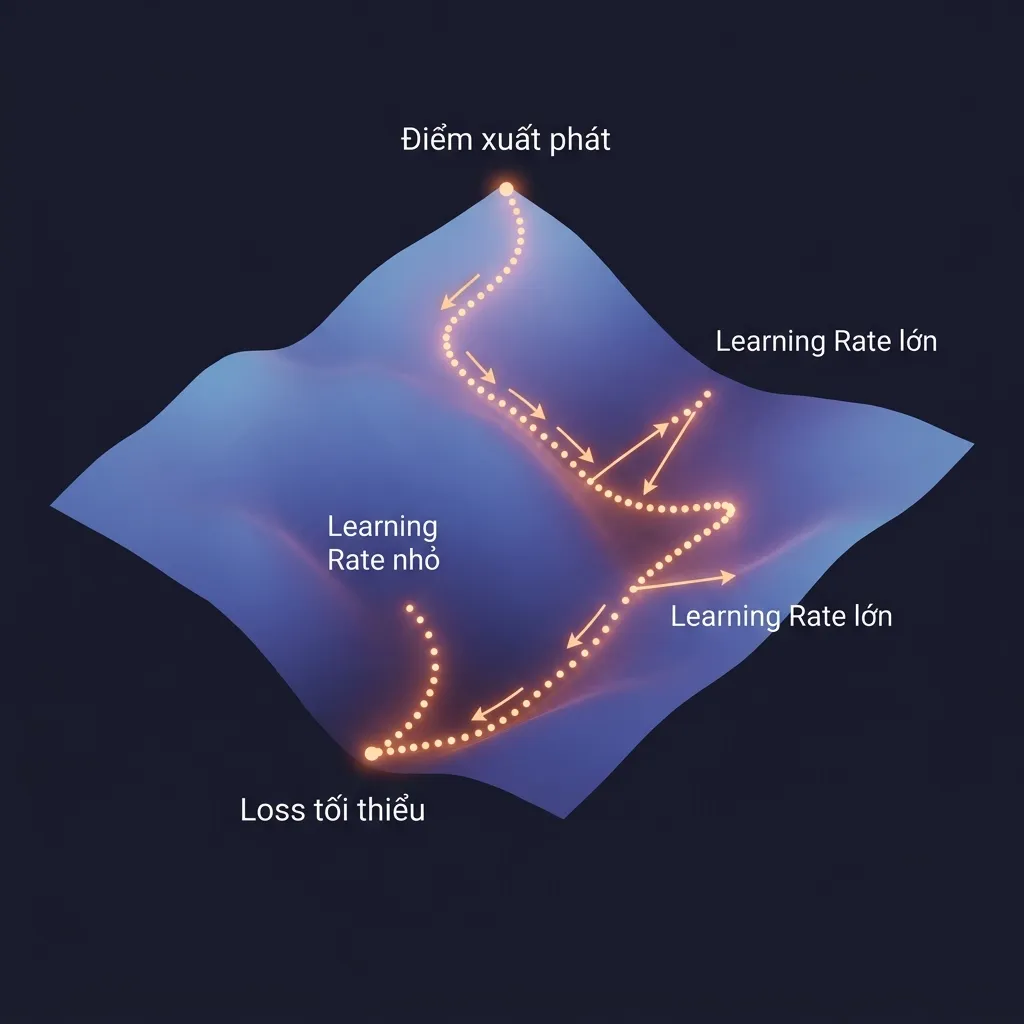
θ_new = θ_old - α × ∇L(θ)
  ↑         ↑      ↑
  vị trí   learning  hướng dốc
  mới      rate      nhất
α(learning rate) = kích thước bước chân- Quá nhỏ → bước mãi không tới (cần 100,000 epoch)
- Quá lớn → nhảy qua nhảy lại, không hội tụ (loss tăng!)
- Vừa phải → hội tụ nhanh và ổn định
∇L(θ)= hướng dốc nhất (gradient)- Dấu trừ: đi ngược hướng gradient (gradient chỉ hướng tăng, ta muốn giảm)
3.2 Demo: Fit đường thẳng y = wx + b
Bài toán: Cho dữ liệu, tìm w và b sao cho y ≈ wx + b. Đây là bước đầu tiên mà mọi neural network đều phải trải qua!
# Dữ liệu thật: y = 3x + 1.5 + noise
np.random.seed(42)
X = np.linspace(-2, 2, 100)
y_true = 3 * X + 1.5 + np.random.randn(100) * 0.3

# Bắt đầu với w, b ngẫu nhiên (chưa biết đáp án)
w = np.random.randn()  # w ban đầu
b = np.random.randn()  # b ban đầu
lr = 0.01
n = len(X)

print(f"Ban đầu: w={w:.3f}, b={b:.3f} (cần tìm: w≈3.0, b≈1.5)")

for epoch in range(500):
    # Bước 1: Dự đoán (Forward Pass)
    y_pred = w * X + b

    # Bước 2: Tính sai số (Loss = Mean Squared Error)
    loss = np.mean((y_pred - y_true) ** 2)

    # Bước 3: Tính gradient (hướng cần điều chỉnh)
    # "w cần thay đổi bao nhiêu?" và "b cần thay đổi bao nhiêu?"
    dL_dw = np.mean(2 * (y_pred - y_true) * X)
    dL_db = np.mean(2 * (y_pred - y_true))

    # Bước 4: Cập nhật w, b (đi ngược hướng gradient)
    w -= lr * dL_dw
    b -= lr * dL_db

    if epoch % 100 == 0:
        print(f"  Epoch {epoch:3d} | Loss: {loss:.4f} | w={w:.3f}, b={b:.3f}")

print(f"\nKết quả: w={w:.4f} (≈3.0), b={b:.4f} (≈1.5) ✅")
3.3 Các biến thể Gradient Descent
| Variant | Mỗi lần cập nhật dùng | Ưu điểm | Nhược điểm | Ví dụ đời thường |
|---|---|---|---|---|
| Batch GD | Toàn bộ dataset | Gradient chính xác | Chậm, tốn RAM | Đọc hết 1000 review rồi quyết định |
| SGD | 1 sample ngẫu nhiên | Nhanh, thoát local min | Dao động nhiều | Đọc 1 review rồi quyết định ngay |
| Mini-batch | 32–256 samples | Cân bằng tốt | Cần tune batch size | Đọc 32 reviews rồi quyết định |
| Adam | Mini-batch + adaptive lr | Hội tụ nhanh, ổn định | Nhiều hyperparameter | Đọc 32 reviews + điều chỉnh tốc độ đọc |
Thực tế: Hầu hết mọi model AI hiện nay đều dùng Adam hoặc AdamW — bạn sẽ gặp chúng liên tục từ bài 3 trở đi.
💡 Bài tập 3:
- Thử thay đổi
lr = 0.1(lớn hơn). Quan sát loss có hội tụ không. Sau đó thửlr = 0.0001(quá nhỏ) — mất bao nhiêu epoch để hội tụ?- Thử thách: Sửa code gradient descent ở trên để fit đường parabol y = ax² + bx + c. Gợi ý: cần 3 biến a, b, c và 3 gradient.
4. Probability — Xác suất
Tóm tắt nhanh
💡 Một câu: Probability giúp AI đưa ra dự đoán có độ tin cậy — thay vì nói "đây là mèo", AI nói "90% đây là mèo, 8% chó, 2% thỏ".
4.1 Bayes Theorem — "Cập nhật niềm tin"
Ví dụ đời thường: Bạn nhận được email. Trước khi đọc, bạn ước lượng 30% email là spam (kinh nghiệm cá nhân). Sau khi thấy email chứa từ "tiền" — bạn cập nhật niềm tin: khả năng spam tăng lên bao nhiêu?
- Trong email spam, 80% chứa từ "tiền"
- Trong email bình thường, 10% chứa từ "tiền"
# Bayes: P(spam|tiền) = P(tiền|spam) × P(spam) / P(tiền)
# Đọc: "Xác suất spam BIẾT RẰNG có từ tiền"

p_spam = 0.3                    # Prior: niềm tin ban đầu
p_ham = 0.7
p_tien_spam = 0.8               # P(tiền|spam): 80% spam có từ "tiền"
p_tien_ham = 0.1                # P(tiền|ham): 10% email thường có từ "tiền"

# P(tiền) = tổng xác suất gặp từ "tiền" trong mọi loại email
p_tien = p_tien_spam * p_spam + p_tien_ham * p_ham
print(f"P(gặp từ 'tiền' bất kỳ): {p_tien:.2f}")  # 0.31

# P(spam | tiền) — xác suất spam sau khi thấy từ "tiền"
p_spam_tien = (p_tien_spam * p_spam) / p_tien
print(f"P(spam | có từ 'tiền'): {p_spam_tien:.1%}")  # 77.4%
# → Từ 30% nghi ngờ, giờ tăng lên 77.4% chắc chắn là spam!
Trong AI: Bayes' theorem là nền tảng của nhiều thuật toán ML kinh điển (Naive Bayes, Bayesian Neural Networks). Tư duy Bayesian — "cập nhật niềm tin khi có thêm bằng chứng" — xuyên suốt toàn bộ AI.
💡 Bài tập 4.1: Nếu email còn chứa thêm từ "miễn phí" (P("miễn phí"|spam) = 0.6, P("miễn phí"|ham) = 0.05), cập nhật xác suất spam bằng cách áp dụng Bayes thêm một lần nữa (dùng kết quả 77.4% làm prior mới). Xác suất spam giờ là bao nhiêu?
4.2 Softmax — "Chuyển điểm thành xác suất"
Ví dụ đời thường: LLM vừa đọc "Con mèo đang..." và cho điểm (logits) cho 5 từ tiếp theo. Nhưng "điểm số" không có ý nghĩa trực quan — ta cần chuyển thành xác suất (tổng = 100%):
| Từ | Điểm (logits) | Xác suất (softmax) |
|---|---|---|
| "ngủ" | 2.1 | 33.9% |
| "ăn" | 1.5 | 18.6% |
| "chạy" | 0.3 | 5.6% |
| "bay" | -0.8 | 1.9% |
| "đọc" | 1.9 | 27.8% |
Softmax làm 2 việc: (1) biến mọi số thành dương, (2) chuẩn hóa cho tổng = 1.
def softmax(x):
    x_shifted = x - np.max(x)  # Trừ max để tránh overflow (e^1000 = ∞!)
    exp_x = np.exp(x_shifted)  # Biến thành dương
    return exp_x / np.sum(exp_x)  # Chuẩn hóa tổng = 1

logits = np.array([2.1, 1.5, 0.3, -0.8, 1.9])
probs = softmax(logits)

tokens = ["ngủ", "ăn", "chạy", "bay", "đọc"]
print("Xác suất từ tiếp theo:")
for token, p in zip(tokens, probs):
    bar = "█" * int(p * 50)
    print(f"  '{token}': {p:.1%} {bar}")

print(f"\nTổng: {probs.sum():.6f}")  # Luôn = 1.0
Output:
  'ngủ':  33.9% █████████████████
  'ăn':   18.6% █████████
  'chạy':  5.6% ██
  'bay':   1.9%
  'đọc':  27.8% █████████████
Lưu ý thú vị: Khi dùng ChatGPT, parameter
temperaturekiểm soát "mức sáng tạo": temperature cao → xác suất đều hơn (sáng tạo), temperature thấp → tập trung vào từ điểm cao nhất (ít sáng tạo).
💡 Bài tập 4.2:
- Implement softmax với temperature:
softmax(x / T). Thử T=0.5, T=1.0, T=2.0 với logits trên. Quan sát phân phối xác suất thay đổi thế nào.- Khi T → 0, softmax sẽ cho kết quả gì? Khi T → ∞ thì sao?
4.3 Cross-Entropy Loss — "Đo mức sai"
Ví dụ đời thường: Thi trắc nghiệm 4 đáp án (A, B, C, D). Đáp án đúng là B.
- Bạn tự tin chọn B (90%) → bạn gần đúng → loss thấp
- Bạn tự tin chọn D (90%) → bạn sai to → loss rất cao
- Bạn đoán bừa 25% cho mỗi đáp án → loss trung bình
Cross-entropy phạt nặng khi model tự tin mà sai!
# Đáp án đúng: từ tiếp theo là "ngủ" (index 0)
y_true = np.array([1, 0, 0, 0, 0])  # One-hot: chỉ "ngủ" = 1

# Dự đoán tốt: model tự tin "ngủ" đúng
y_good = softmax(np.array([3.0, 0.5, 0.1, -1.0, 0.5]))
# Dự đoán tệ: model nghĩ là "bay"
y_bad  = softmax(np.array([-1.0, 0.5, 0.1, 3.0, 0.5]))

def cross_entropy(y_true, y_pred, eps=1e-15):
    y_pred = np.clip(y_pred, eps, 1)  # Tránh log(0) = -∞
    return -np.sum(y_true * np.log(y_pred))

print(f"Loss (dự đoán tốt): {cross_entropy(y_true, y_good):.4f}")  # Nhỏ ≈ 0.1
print(f"Loss (dự đoán tệ):  {cross_entropy(y_true, y_bad):.4f}")   # Lớn ≈ 4.0

# Perplexity = "mức bối rối" = exp(loss)
# PPL thấp = model ít bối rối = dự đoán tốt
# PPL = 1 → hoàn hảo, PPL = 50000 → đoán bừa
avg_loss = 2.3
ppl = np.exp(avg_loss)
print(f"\nPerplexity: {ppl:.2f} (mô hình tốt thường < 20)")
💡 Bài tập 4.3:
- Tính cross-entropy bằng tay (dùng máy tính) cho: y_true = [0, 1, 0], y_pred = [0.1, 0.8, 0.1]. Gợi ý: -log(0.8) = ?
- Nếu model dự đoán hoàn hảo y_pred = [0, 1, 0], cross-entropy = ? Tại sao?
- Liên hệ thực tế: Khi bạn thấy ChatGPT báo perplexity = 3.5 cho một mô hình, điều đó có ý nghĩa gì?
Tóm tắt bài học
| Chủ đề | Hiểu đơn giản | Ứng dụng trong AI |
|---|---|---|
| Dot product | Đo mức tương đồng 2 vector | Attention mechanism |
| Matrix mul | Biến đổi dữ liệu qua "bộ lọc" | Linear layers |
| Đạo hàm | Tốc độ thay đổi | Biết nên điều chỉnh thế nào |
| Chain rule | Nhân tỷ lệ ảnh hưởng | Backpropagation |
| Gradient descent | Đi xuống dốc tìm đáy | Huấn luyện mọi mô hình |
| Softmax | Điểm → xác suất | Output layer của LLM |
| Cross-entropy | Đo mức "sai" | Loss function huấn luyện |
Bài tập tổng hợp
- ✅ Hoàn thành tất cả bài tập nhỏ trong từng phần (1.1, 1.2, 1.3, 1.4, 2.1, 2.2, 2.3, 3, 4.1, 4.2, 4.3)
- Implement Gradient Descent để tìm minimum của
f(x, y) = (x-3)² + (y+2)²từ điểm khởi đầu (0, 0). Kết quả phải ra (3, -2) - Mini-project: Tạo hệ thống "recommend phim" đơn giản:
- Cho 5 user, mỗi user đánh giá 4 phim (1→5)
- Dùng cosine similarity để tìm user giống nhau nhất
- Gợi ý phim mà user A chưa xem nhưng user giống A thích
- Đọc abstract bài báo gốc "Attention Is All You Need" (2017) tại
arxiv.org/abs/1706.03762— tìm xem bài báo nhắc đến "dot product" ở đâu và tại sao
Bài tiếp theo: Chúng ta sẽ dùng toán học này để xây dựng Neural Networks từ đầu — mạng nơ-ron, phần cốt lõi của mọi mô hình AI.