はじめに
前回の記事では、一般的なニューラル ネットワークである MLP を構築しました。しかし、MLP には問題があります。それは、データの構造を理解できないということです。画像の場合、MLP はすべてのピクセルを同じように「認識」します。どのピクセルがどのピクセルの隣にあるかはわかりません。テキストの場合、MLP はどの単語が最初に来てどの単語が後に来るかの順序を知りません。
この記事では、特定の種類のデータを処理するために構築された 3 つの特殊なアーキテクチャを紹介します。
| 建築 | のために生まれた主なアイデア | 実際の例 | |
|---|---|---|---|
| CNN | 写真、ビデオ | 「小さな領域を一つ一つ見てみる」 | Google フォトで写真を分類 |
| RNN | 文字列 (テキスト、音声) | 「読んだ内容を覚えておいてください」 | メッセージを入力する際の単語の提案 |
| LSTM | 長い文字列 | 「選択的記憶」 | Google 翻訳 (2017 年以前) |
ネタバレ: 3 人全員に 弱点 があり、それが 2017 年に登場した トランスフォーマー であり、すべてを変えたものです。その理由を見てみましょう。
1. 畳み込みニューラル ネットワーク (CNN) — 「小さな領域を観察する」
1.1 MLP の画像の問題
手書きの数字 (28×28 ピクセルの画像) を認識したいと想像してください。
-
MLP: 画像を 784 個の数字の行に「引き伸ばす」 → 位置情報が完全に失われます。画像の左上のピクセルと中央のピクセルは 同じように扱われます。さらに、MLP では、最初のレイヤーに 784 × hidden_size パラメーターが必要です。大量!
-
CNN: 小さな領域 (3×3 または 5×5 ピクセル) の画像を「見て」、局所的な特徴 (エッジ、角、曲線) を見つけます。 パラメータが少なく、位置の理解が向上します。
1.2 畳み込み — 「スライディング フィルター」
通常の生活の例: あなたは虫眼鏡で写真を見ます。小さな虫眼鏡 (3×3 cm) を左上隅から右下隅までスライドさせます。それぞれの場所で、そのエリアを要約する 数値 (明るい/暗い、エッジがあるかどうか、コーナーがあるかどうかなど) を記録します。結果→「特徴マップ」。
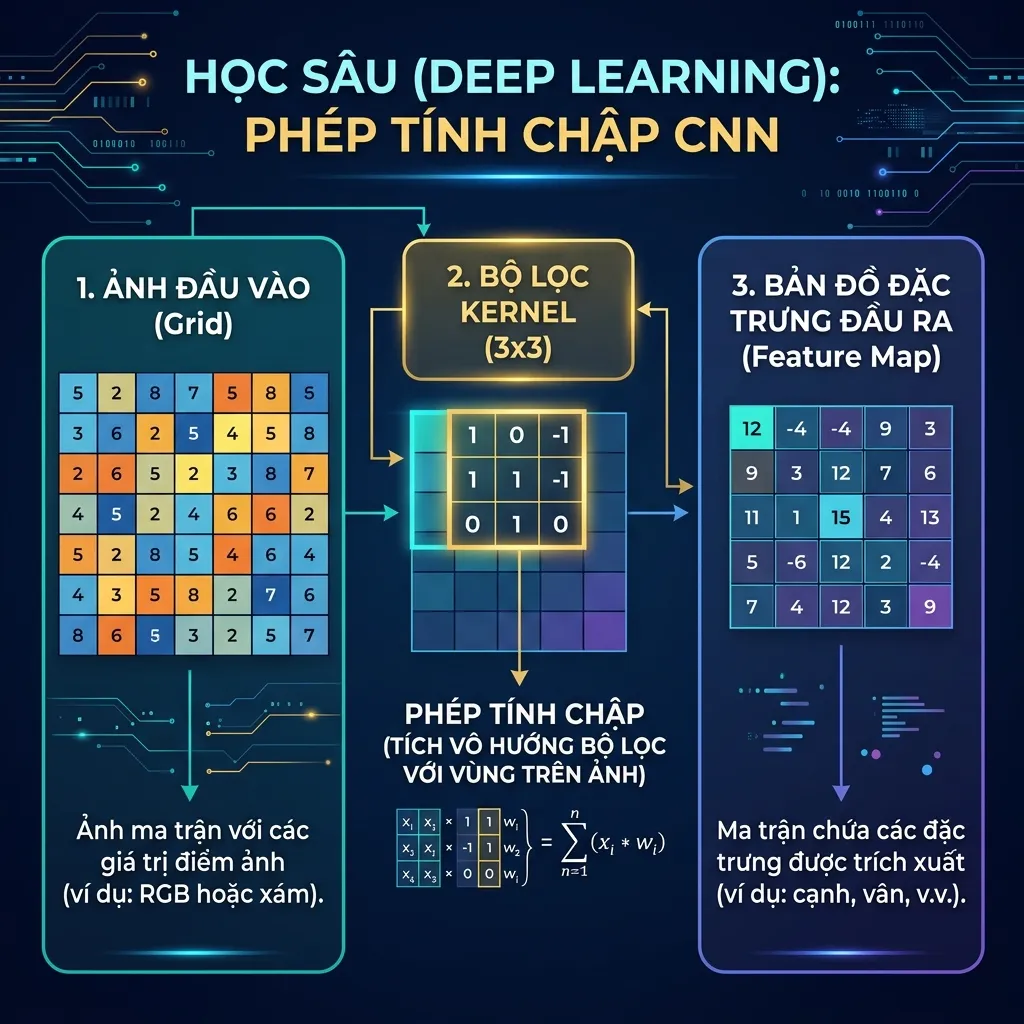
Input image (6×6):     Filter (3×3):     Feature map (4×4):
┌─────────────────┐    ┌─────────┐       ┌─────────────┐
│ 1 1 1 │ 0 0 0  │    │ 1  0  1 │       │ 4  3  2  1  │
│ 1 1 1 │ 0 0 0  │  × │ 0  1  0 │   =   │ ...         │
│ 1 1 1 │ 0 0 0  │    │ 1  0  1 │       │ ...         │
│ 0 0 0 │ 1 1 1  │    └─────────┘       │ 1  2  3  4  │
│ 0 0 0 │ 1 1 1  │      ↑ Trượt          └─────────────┘
│ 0 0 0 │ 1 1 1  │      qua ảnh
└─────────────────┘
各位置で: 対応して乗算し、加算 (ドット積のように!) → 1 つの数値。
CNN の 3 つの大きな利点:
| 利点 | 説明 | 例 |
|---|---|---|
| パラメータの共有 | 画像全体に同じフィルターが使用されます。 1 3×3 フィルター = わずか 9 パラメーター (数千ではなく) | |
| ローカル接続 | 各ニューロンは小さな領域しか認識しません。エッジ、コーナー、テクスチャを検出します。 | |
| 翻訳の不変性 | 物体がどこにあっても認識 | どの隅にいても猫を認識 |
1.3 CNN アーキテクチャ — ピクセルから意思決定まで
CNN は、単純な機能 → 複雑な機能 まで、多くの層を積み重ねています。
Lớp 1: Phát hiện cạnh (edges) ─── Filter đơn giản
    ↓
Lớp 2: Phát hiện góc, texture ─── Kết hợp cạnh
    ↓
Lớp 3: Phát hiện bộ phận (mắt, mũi, tai) ─── Kết hợp góc + texture
    ↓
Lớp 4: Nhận ra đối tượng (mèo, chó) ─── Kết hợp bộ phận
例: 猫の識別: ピクセル → エッジ → 三角形 (耳) + 円 (目) → 「猫」!
import torch
import torch.nn as nn

class SimpleCNN(nn.Module):
    def __init__(self, num_classes=10):
        super().__init__()
        self.features = nn.Sequential(
            # === Lớp 1: Phát hiện đặc trưng cơ bản ===
            nn.Conv2d(1, 32, kernel_size=3, padding=1),  # 28×28 → 28×28, 32 filters
            nn.ReLU(),
            nn.MaxPool2d(2),                              # 28×28 → 14×14 (thu nhỏ)

            # === Lớp 2: Phát hiện đặc trưng phức tạp hơn ===
            nn.Conv2d(32, 64, kernel_size=3, padding=1), # 14×14 → 14×14, 64 filters
            nn.ReLU(),
            nn.MaxPool2d(2),                              # 14×14 → 7×7
        )
        self.classifier = nn.Sequential(
            nn.Flatten(),                # 64 × 7 × 7 = 3136 số
            nn.Linear(64 * 7 * 7, 128), # Dense layer
            nn.ReLU(),
            nn.Linear(128, num_classes)  # Output: 10 lớp (0-9)
        )

    def forward(self, x):
        features = self.features(x)      # Trích xuất đặc trưng
        return self.classifier(features)  # Phân loại

# Test
model = SimpleCNN(num_classes=10)
x = torch.randn(8, 1, 28, 28)  # 8 ảnh, 1 kênh (grayscale), 28×28
output = model(x)
print(f"Input: {x.shape} → Output: {output.shape}")  # [8, 10]
print(f"Tổng parameters: {sum(p.numel() for p in model.parameters()):,}")
1.4 有名な CNN — 歴史的なマイルストーン
| モデル | 年 | 特長 | なぜそれが重要なのか |
|---|---|---|---|
| LeNet-5 | 1998年 | 初の実用的な CNN | 銀行小切手の数字を読み取る |
| アレックスネット | 2012年 | GPU トレーニング、ReLU、ドロップアウト | ImageNet に勝利 → 深層学習が爆発的に普及 |
| VGG | 2014年 | 非常に深い (16 ~ 19 層)、3×3 のみを使用 | 「深い=良い」を証明する |
| ResNet | 2015年 | スキップ接続、152 クラス | 非常に深いネットワークにおける勾配消失を解く |
| EfficientNet | 2019年 | スマートスケール | 速度/精度の最適化 |
💡 演習 1:
- 手で計算します。入力が 32×32 画像の場合、フィルター 5×5、ストライド = 1、パディングなしを使用します。 → 特徴マップのサイズはどれくらいですか?式:
output_size = (input_size - kernel_size) / stride + 12.padding=2 を追加するとどうなるでしょうか?- なぜ MaxPool2d(2) は画像サイズを 1/2 に減らすのですか?
2. シーケンス データの問題 — 「シーケンスが重要」
CNN は画像には最適ですが、連続データ (テキスト、音声、時系列) についてはどうでしょうか?
2.1 なぜ別のアーキテクチャが必要なのでしょうか?
例 1 — 意味の変更の順序:
"Tôi KHÔNG thích pizza"  ≠  "Tôi thích pizza"
→ Từ "không" ở giữa thay đổi nghĩa TOÀN CÂU
例 2 — 遠いコンテキスト:
"Người phụ nữ mặc áo đỏ, đeo kính, cầm ô,
 đứng cạnh cây cổ thụ trong công viên,
 đang ____ với con chó."
→ Cần nhớ "người phụ nữ" từ đầu câu để điền đúng!
例 3 — 可変長:
Input 1: "Xin chào" (2 từ)
Input 2: "Hôm nay trời đẹp quá, chúng ta đi dạo nhé!" (9 từ)
→ MLP cần input cố định → không xử lý được!
CNN は短いテキスト (TextCNN) を処理できますが、長い文の先頭と末尾にある単語間の遠い関係を捉えることは困難です。
💡 練習 2: 語順によって意味が完全に変わるベトナム語の例をさらに 2 つ考えてください。関連用語: 否定的な、受動的な文...
3. リカレント ニューラル ネットワーク (RNN) — 「すべての単語を読んで、頭の中で覚えてください」
3.1 主なアイデア
日常生活の例: あなたは小説を読みました。 ページごとに読み、各ページが終わると、読んだ内容を覚えています (非表示状態)。新しいページ + 古い記憶 → 新しい理解。
RNN もまったく同じように動作します。すべての単語を読み取り、各ステップで更新される隠れ状態 (短期記憶) を維持します。
     x₁ ("Con")    x₂ ("mèo")    x₃ ("đang")    x₄ ("ngủ")
       ↓              ↓              ↓               ↓
h₀ → [RNN] → h₁ → [RNN] → h₂ → [RNN] → h₃ → [RNN] → h₄
 ↑            ↑             ↑             ↑            ↑
(ban đầu    (nhớ          (nhớ          (nhớ         (nhớ toàn
 trống)     "Con")        "Con mèo")    "Con mèo     câu)
                                         đang")
h_t = tanh(W_hh × h_{t-1} + W_xh × x_t + b)
       ↑           ↑              ↑
   activation   ký ức cũ       từ mới
class SimpleRNN(nn.Module):
    def __init__(self, input_size, hidden_size, output_size):
        super().__init__()
        self.hidden_size = hidden_size
        self.rnn = nn.RNN(input_size, hidden_size, batch_first=True)
        self.fc = nn.Linear(hidden_size, output_size)

    def forward(self, x):
        # x: (batch, seq_len, input_size) — batch câu, mỗi câu là chuỗi
        out, hidden = self.rnn(x)
        # Dùng hidden state cuối (chứa ký ức toàn câu) để dự đoán
        return self.fc(hidden.squeeze(0))

# Ví dụ: phân loại câu positive/negative
rnn = SimpleRNN(input_size=128, hidden_size=256, output_size=2)
x = torch.randn(8, 20, 128)  # 8 câu, mỗi câu 20 từ, mỗi từ embedding 128
output = rnn(x)
print(f"Input: {x.shape} → Output: {output.shape}")  # [8, 2]
3.2 消失勾配 — 致命的な弱点
通常の生活の例: あなたは「電話ゲーム」をします。20 人が並び、最初の人が文章をささやき、それを各人に伝えます。最後の人物によって、情報はあまりにも多くの手順を経たため、完全に歪められました。
RNNも同様です!複数のタイム ステップにわたる逆伝播の場合、勾配は同じ行列 W で連続して乗算されます。
∂L/∂h₀ = ∂L/∂h_T × (W)^T lần
| ケース | 結果 | 数値例 |
|---|---|---|
| |W| < 1 | 勾配 → 0 (消失) | 0.9^20 = 0.12 → ほぼ失われます! |
| |W| > 1 | 勾配 → ∞ (爆発) | 1.1^20 = 6.7 → ドーン! |
実際的な結果: 基本的な RNN は、最新の単語を最大 10 ~ 20 個しか覚えていません。 100 ワードの長さの文では、RNN は文の先頭を完全に「忘れて」しまいました。
# Demo: gradient vanishing qua nhiều bước nhân
w = 0.9  # < 1
gradients = [w**t for t in range(20)]
print("Gradient từ t=0 đến t=19:")
print([f"{g:.4f}" for g in gradients])
# [1.0, 0.9, 0.81, 0.729, ..., 0.1351] → giảm 87%!

print(f"\nSau 20 bước: gradient chỉ còn {gradients[-1]:.1%} ban đầu")
print(f"Sau 50 bước: {0.9**50:.6f} → gần như = 0!")
💡 演習 3:
- W = 0.9 ではなく 1.1 の場合、20 ステップ後の勾配はいくらですか? 100歩経ったら?
- グラデーション クリッピング ([-max, max] の間のグラデーションを制限する) は、爆発の解決には役立ちますが、消滅の解決には役立つのはなぜですか?
4. 長短期記憶 (LSTM) — 「選択的記憶」
4.1 主なアイデア
実際の例: RNN と LSTM を比較します:
- RNN = 小さなポストイットのメモ → 少ししか書き込めず、古いものの上に新しいものを書くことができます
- LSTM = ロックされたノートブック上のメモ → 可能性:
- 削除 不要な古い情報 (忘れゲート) — 「ページの削除」
- 追加 重要な新しい情報 (入力ゲート) — 「新しいページを書く」
- 読み取り 必要な情報 (出力ゲート) — 「ページを開いて読む」
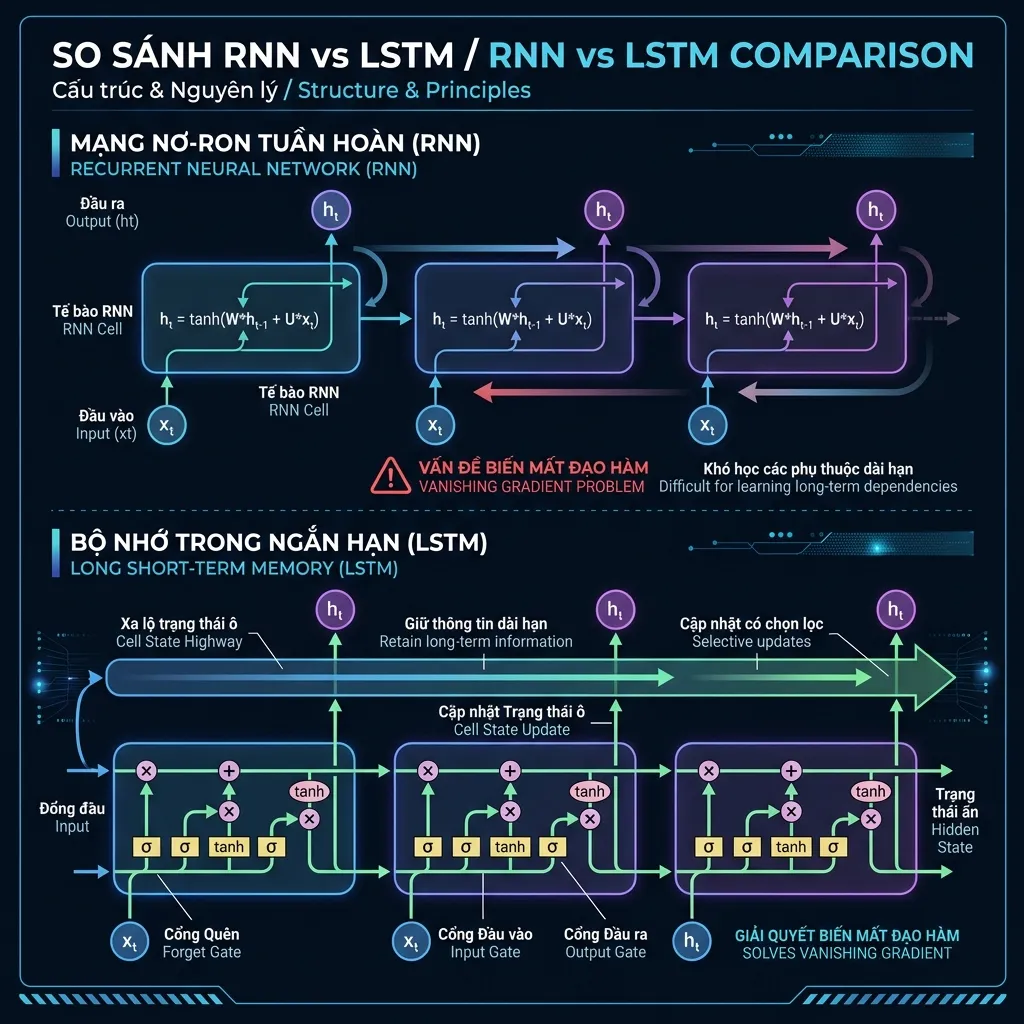
4.2 LSTM の 3 つのゲート
LSTM は 2 つの情報ストリームを維持します。
- セル状態 (C) = "ノートブック" — コンベア ベルトのようにチェーン全体を走る 長期記憶
- 隠し状態 (h) = "ポストイット" — 短期 記憶、現在のステップに使用されます
Forget Gate:  f_t = σ(W_f · [h_{t-1}, x_t] + b_f)    ← "Quên gì?"
Input Gate:   i_t = σ(W_i · [h_{t-1}, x_t] + b_i)    ← "Nhớ gì mới?"
              C̃_t = tanh(W_C · [h_{t-1}, x_t] + b_C)  ← "Thông tin mới"
Cell Update:  C_t = f_t × C_{t-1} + i_t × C̃_t         ← "Cập nhật sổ tay"
Output Gate:  o_t = σ(W_o · [h_{t-1}, x_t] + b_o)     ← "Output gì?"
              h_t = o_t × tanh(C_t)                     ← "Đọc & xuất"
具体的な例 — LSTM は、「私は ベトナムで生まれました。米国の大学で 4 年間学びました。私の母国語は ___ です」という文を読み上げます。
| ステップ | ゲートを忘れてください | 入力ゲート | セルの状態 |
|---|---|---|---|
| 「ベトナム」 | すべてを保管してください | 「国籍: VN」と記入 | {国籍: ベトナム} |
| 「アメリカ」 | VN を保持します (忘れないでください!) | 「留学:アメリカ」と書く | {国籍:ベトナム人、留学先:アメリカ} |
| 「4年」 | すべてを保管してください | 「期間: 4 年」と書く | {国籍:ベトナム、留学:アメリカ、4年} |
| 「お母さん…」 「留学」は忘れてください | 「国籍」に注目 | → 出力:「ベトナム語」 ✅ |
4.3 コード LSTM — 感情の分類
class SentimentLSTM(nn.Module):
    def __init__(self, vocab_size, embed_dim, hidden_size, n_layers=2):
        super().__init__()
        self.embedding = nn.Embedding(vocab_size, embed_dim, padding_idx=0)
        self.lstm = nn.LSTM(
            embed_dim, hidden_size,
            num_layers=n_layers,     # 2 lớp LSTM xếp chồng
            batch_first=True,
            dropout=0.3,             # Chống overfit
            bidirectional=True       # Đọc cả 2 chiều!
        )
        self.fc = nn.Linear(hidden_size * 2, 1)  # ×2 vì bidirectional
        self.sigmoid = nn.Sigmoid()

    def forward(self, x):
        embedded = self.embedding(x)           # Token IDs → vectors
        lstm_out, (hidden, _) = self.lstm(embedded)
        # Lấy hidden state cuối của cả 2 chiều (forward + backward)
        hidden = torch.cat([hidden[-2], hidden[-1]], dim=1)
        return self.sigmoid(self.fc(hidden))   # 0→1: negative→positive

# Ví dụ sử dụng
model = SentimentLSTM(vocab_size=10000, embed_dim=128, hidden_size=256)
x = torch.randint(0, 10000, (8, 50))  # 8 câu, mỗi câu 50 tokens
output = model(x)
print(f"Sentiment predictions: {output.squeeze()[:3]}")  # 3 câu đầu
双方向 LSTM = 双方向読み取り (左→右および右→左)。なぜ?意味を理解するには、後ろも見る必要がある場合があるからです。
"Anh ấy không phải là người ____ nhất, nhưng rất chăm chỉ"
→ Cần đọc "nhưng rất chăm chỉ" (phía sau) để biết ____ = "giỏi" (chứ không phải "tệ")
4.4 RNN、LSTM、GRU の比較
| RNN | LSTM | グル | |
|---|---|---|---|
| ゲート | 0 | 3 (忘れ、入力、出力) | 2 (リセット、更新) |
| パラメータ | 少なくとも | ほとんど | 平均 |
| 遠くまで覚えておいてください | ❌ ~10 単語 | ✅ ~200 単語 | ✅ ~200 単語 |
| 列車の速度 | 速い | 遅い | 平均 |
| 使用する場合 | デモ/学習 | 長文、NLP | 長いテキスト、少ないデータ |
GRU は LSTM の簡易バージョンです。忘れ + 入力ゲートを 更新ゲート に結合し、セル状態を削除します。パフォーマンスは LSTM と同等ですが、パラメーターが少なくなります。
💡 演習 4:
- LSTM には重み行列がいくつありますか?ヒント: 各ゲートには 2 つの行列 (W は入力、U は隠れ状態) とセル状態候補があります。
- hidden_size = 256、input_size = 128 の場合、1 LSTM セルの合計パラメータ = ?式:
4 × (input_size × hidden_size + hidden_size × hidden_size + hidden_size)
5. LSTM の制限とトランスフォーマーが必要な理由
LSTM は RNN よりもはるかに強力ですが、Transformer 革命を引き起こした 2 つの基本的な問題がまだあります。
5.1 ❌ 逐次処理 — 「一度に 1 単語ずつ」
x₁ → h₁ → x₂ → h₂ → x₃ → h₃ → ... → x_1000 → h_1000
     ↑ phải chờ ↑ phải chờ ↑ phải chờ
LSTM 順番に処理する必要があります — h3 は h2 に依存し、h2 は h1 に依存します。これは次のことを意味します:
| 結果 | 説明 | 影響 |
|---|---|---|
| 並列化されていません | GPU には 10,000 コアがありますが、使用されるコアは 1 つだけです | 99.99% の GPU を無駄にしている |
| スロートレーニング | 文 1000 単語 = 1000 の連続ステップ | 日→週→月 |
| スケールできません | 2x 長い = 2x 遅い (リニア) | 長い本や書類を処理できない |
例: 100 万文 × 100 単語 = 1 億 連続 ステップで LSTM をトレーニングします。 Transformer は 並列 = 100 倍高速に処理できます。
5.2 ❌ 情報のボトルネック — 「情報のボトルネック」
セルの状態はさらに記憶するのに役立ちますが、文の すべての意味は 固定 サイズ (例: 256 個の数値) のベクトル h_T を「通過」する必要があります。
"The cat that ate the mouse that lived in the house that Jack built sat on the mat"
                                                                      ↓
                                                              h_T = [0.2, -0.3, ...]
                                                              (nén 15 từ → 256 số!)
1000 単語の文の場合、256 桁のベクトルではすべてを記憶するには十分ではありません → 情報は失われます。
5.3 ✅ ソリューション: トランス (2017)
Transformer は アテンション メカニズム を使用して 両方の問題を解決します。
| LSTM の問題 | 変圧器ソリューション |
|---|---|
| 逐次処理 | 並列化 — すべての単語を一度に処理します。 |
| 情報のボトルネック | 注意 — 各単語は他のすべての単語を「直接見て」います。 |
LSTM: x₁ → x₂ → x₃ → x₄ → x₅  (tuần tự, chậm)

Transformer:
x₁ ←→ x₂
x₁ ←→ x₃     Tất cả từ "nhìn" nhau
x₁ ←→ x₄     cùng lúc, song song!
x₂ ←→ x₃
...
これは、「Attending Is All You Need」 (2017) という記事の画期的な進歩であり、RNN/LSTM をアテンション メカニズムに完全に置き換えます。次の記事でさらに詳しく説明します。
💡 演習 5:
- LSTM は 100 単語の文を 100 のステップで処理します。 Transformer には何ステップが必要ですか? (ヒント: Transformer はすべての単語を並行して処理します)
- Transformer にはなぜ「二次注意コスト」問題があるのですか?ヒント: N 個の単語がある場合、各単語は他にいくつの単語を「参照」する必要がありますか?
6. CNN/RNN/LSTM を引き続き使用する必要があるのはどのような場合ですか?
Transformer が NLP の主流を占めていますが、CNN と LSTM は依然として多くの問題で活躍します。
CNN は現在でも次の目的で使用されています。
- Computer Vision: ResNet、EfficientNet は依然として人気があります (ただし、Vision Transformer が置き換えられています)
- 音声処理: 音声分類のための 1D 畳み込み
- シンプルなテキスト分類: TextCNN は、小さな問題に対して高速、軽量、高精度です。
- エッジ デバイス: 電話機 (MobileNet) で実行できる軽量の CNN
LSTM/GRU は現在でも次の目的で使用されています。
- 小型デバイスの 時系列: IoT 上のセンサー データの予測
- ストリーミング データ: データは連続的に到着します (バッチではありません)。
- 小規模なデータセット: Transformer は少量のデータで簡単にオーバーフィットします。LSTM の方が優れています。
- リアルタイム推論: LSTM が各ステップを処理し、応答が速い
ルール: 大量のデータ + 強力な GPU がある場合 → Transformer。 少量のデータ + 小型デバイスの場合 → CNN/LSTM。
💡 演習 6: 3 つの問題がある場合、どのアーキテクチャを選択しますか?説明:
- スパム/ハムメールを分類 (1000 件のメール、各メール最大 50 ワード)
- チャットボットが質問に回答 (100 万件の会話)
- 監視カメラの顔認識 (リアルタイム)
概要
| 建築 | 強い | 弱い | 用途 | 黄金時代 |
|---|---|---|---|---|
| CNN | ローカル パターン、高速 | 長距離、シーケンス | 画像、短いテキスト | 2012–現在 |
| RNN | 逐次処理 | 消えるグラデーション | 単純なシーケンス | 2013–2017 |
| LSTM | 長距離記憶 | シーケンシャル、遅い | 中程度のシーケンス | 2015–2018 |
| トランス | パラレル、長距離 | コスト O(N²) | NLP、LLM、ビジョン | 2017–現在 |
進化のタイムライン
1998: LeNet (CNN cho chữ số)
  ↓
2012: AlexNet (CNN thắng ImageNet → Deep Learning bùng nổ)
  ↓
2014: Sequence-to-Sequence (LSTM cho dịch thuật)
  ↓
2015: Attention + LSTM (cải thiện dịch thuật)
  ↓
2017: "Attention Is All You Need" → TRANSFORMER 💥
  ↓
2018: BERT, GPT-1 (Transformer thống trị NLP)
  ↓
2020+: GPT-3, ChatGPT → LLM thời đại mới
一般的な演習
- ✅ 各セクション (1、2、3、4、5、6) の小さな演習をすべて完了します。
- PyTorch を使用して、セクション 1.3 で SimpleCNN を実装し、MNIST データセットでトレーニングします。 >98% の精度を達成。
- セクション 4.3 で SentimentLSTM を実装し、映画レビュー データセット (IMDB) でトレーニングします。 >85% の精度を達成。
- 実験比較: 同じテキスト分類問題を (a) MLP、(b) CNN (TextCNN)、(c) LSTM を使用してトレーニングします。精度、トレーニング時間、パラメーターの数を比較します。
- 記事「必要なのは注意だけ」の要約を読みます。著者が RNN を Transformer に置き換えるべき 3 つの理由を挙げています。
次の記事: 注意 メカニズムについて学びます。これは、Transformer とすべての最新の LLM の並外れたパワーの鍵です。