簡介
在上一篇文章中,我們建構了 MLP——通用神經網路。但 MLP 有一個問題:它不理解資料的結構。對於圖像,MLP「看到」每個像素都是一樣的——它不知道哪個像素與哪個像素相鄰。對於文本,MLP 不知道哪些單字在前、哪些單字在後的順序。
本文介紹了三種專門的架構-每種架構都是為了處理特定類型的資料而建構的:
| 建築 | 為 | 而生主要思想 | 現實生活中的例子 |
|---|---|---|---|
| 美國有線電視新聞網 | 照片、影片 | “觀察每個小區域” | Google 相簿將照片分類 |
| RNN | 字串(文字、語音) | “記住你讀過的內容” | 輸入訊息時的單字建議 |
| LSTM | 長串 | 《選擇性記憶》 | Google翻譯(2017 年之前) |
劇透: 這三者都有 弱點,這就是為什麼 Transformer 在 2017 年問世 - 它改變了一切。讓我們找出原因。
1. 卷積神經網路 (CNN) —“觀察小區域”
1.1 MLP 的圖片問題
假設您想要辨識手寫數字(28×28 像素影像):
-
MLP: 將影像「拉伸」成一行 784 個數字 → 完全遺失位置資訊。影像的左上像素和中間像素被視為相同。此外,MLP 第一層需要 784×hidden_size 參數——很多!
-
CNN:「檢視」影像中的小區域(3×3 或 5×5 像素),找出局部特徵(邊緣、角點、曲線)。 更少的參數和更好的位置理解。
1.2 卷積—“滑動濾波器”
日常生活中的例子: 你用放大鏡看照片。小放大鏡(3×3公分),將玻璃從左上角滑到右下角。在每個位置,您記錄一個數字,總結該區域(亮/暗,是否有邊緣,是否有角...)。結果→「特徵圖」。
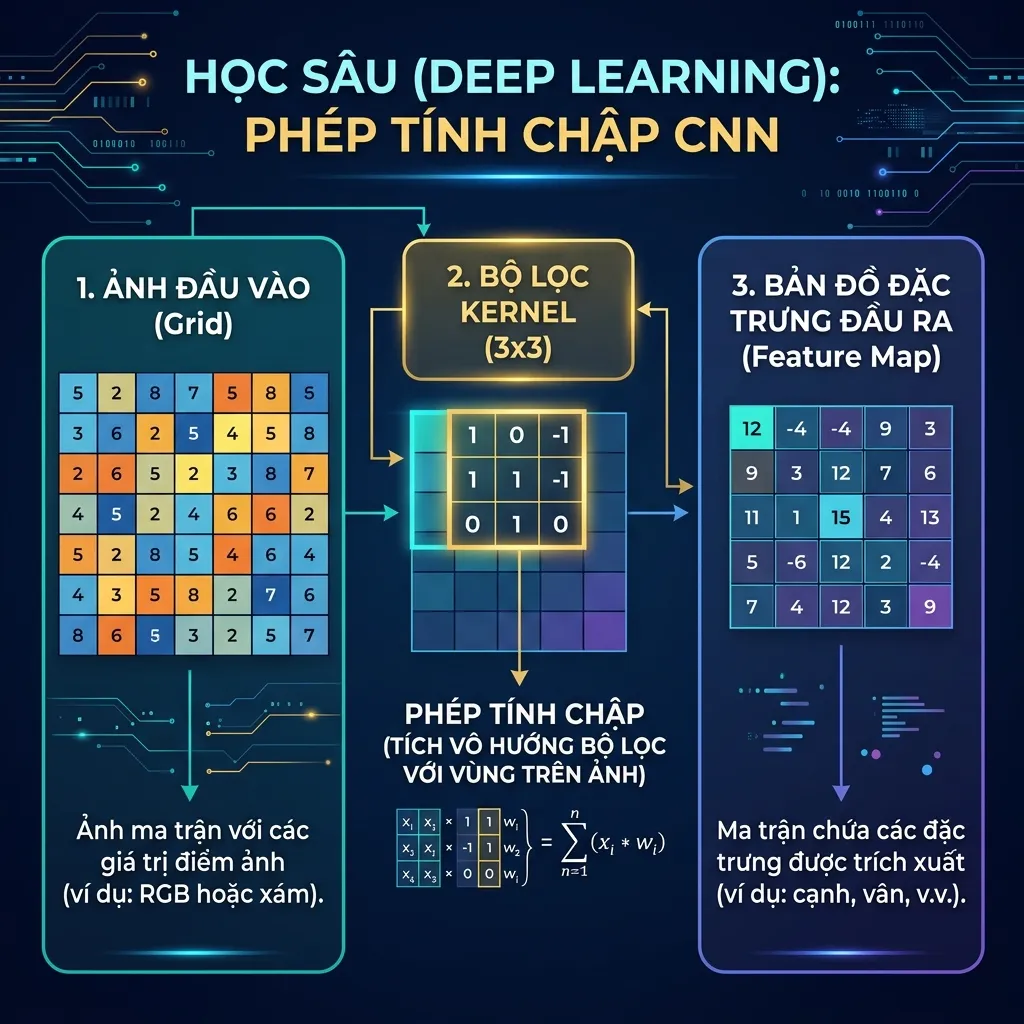
Input image (6×6):     Filter (3×3):     Feature map (4×4):
┌─────────────────┐    ┌─────────┐       ┌─────────────┐
│ 1 1 1 │ 0 0 0  │    │ 1  0  1 │       │ 4  3  2  1  │
│ 1 1 1 │ 0 0 0  │  × │ 0  1  0 │   =   │ ...         │
│ 1 1 1 │ 0 0 0  │    │ 1  0  1 │       │ ...         │
│ 0 0 0 │ 1 1 1  │    └─────────┘       │ 1  2  3  4  │
│ 0 0 0 │ 1 1 1  │      ↑ Trượt          └─────────────┘
│ 0 0 0 │ 1 1 1  │      qua ảnh
└─────────────────┘
在每個位置:相應地相乘,然後相加(如點積!)→ 1 個數字。
CNN的3大優勢:
| 優勢 | 說明 | 範例 |
|---|---|---|
| 參數共用 | 整個影像使用相同的濾鏡 | 1 3×3 濾鏡 = 只有 9 個參數(而不是數千個) |
| 本地連接 | 每個神經元只看到一個小區域偵測邊緣、角點、紋理 | |
| 平移不變性 | 辨識物體,無論它們在哪裡 | 無論貓在哪個角落,都能認出它們 |
1.3 CNN 架構 — 從像素到決策
CNN 堆疊了許多層,從 簡單特徵 → 複雜特徵:
Lớp 1: Phát hiện cạnh (edges) ─── Filter đơn giản
    ↓
Lớp 2: Phát hiện góc, texture ─── Kết hợp cạnh
    ↓
Lớp 3: Phát hiện bộ phận (mắt, mũi, tai) ─── Kết hợp góc + texture
    ↓
Lớp 4: Nhận ra đối tượng (mèo, chó) ─── Kết hợp bộ phận
例如: 貓咪辨識:像素→邊→三角形(耳朵)+圓形(眼睛)→「貓」!
import torch
import torch.nn as nn

class SimpleCNN(nn.Module):
    def __init__(self, num_classes=10):
        super().__init__()
        self.features = nn.Sequential(
            # === Lớp 1: Phát hiện đặc trưng cơ bản ===
            nn.Conv2d(1, 32, kernel_size=3, padding=1),  # 28×28 → 28×28, 32 filters
            nn.ReLU(),
            nn.MaxPool2d(2),                              # 28×28 → 14×14 (thu nhỏ)

            # === Lớp 2: Phát hiện đặc trưng phức tạp hơn ===
            nn.Conv2d(32, 64, kernel_size=3, padding=1), # 14×14 → 14×14, 64 filters
            nn.ReLU(),
            nn.MaxPool2d(2),                              # 14×14 → 7×7
        )
        self.classifier = nn.Sequential(
            nn.Flatten(),                # 64 × 7 × 7 = 3136 số
            nn.Linear(64 * 7 * 7, 128), # Dense layer
            nn.ReLU(),
            nn.Linear(128, num_classes)  # Output: 10 lớp (0-9)
        )

    def forward(self, x):
        features = self.features(x)      # Trích xuất đặc trưng
        return self.classifier(features)  # Phân loại

# Test
model = SimpleCNN(num_classes=10)
x = torch.randn(8, 1, 28, 28)  # 8 ảnh, 1 kênh (grayscale), 28×28
output = model(x)
print(f"Input: {x.shape} → Output: {output.shape}")  # [8, 10]
print(f"Tổng parameters: {sum(p.numel() for p in model.parameters()):,}")
1.4 著名的 CNN — 歷史里程碑
| 型號 | 年份 | 特點 | 為什麼它很重要 |
|---|---|---|---|
| LeNet-5 | 1998 | 第一個務實的CNN | 讀取銀行支票上的號碼 |
| 亞歷克斯網路 | 2012 | GPU 訓練、ReLU、Dropout | 贏得 ImageNet → 深度學習爆炸 |
| VGG | 2014年 | 很深(16-19層),只用3×3 | 證明「更深=更好」 |
| ResNet | 2015 | 2015跳過連接,152 類別 | 解決非常深的網路中的梯度消失問題 |
| 高效網 | 2019 | 2019智慧秤 | 最佳化速度/準確度 |
💡練習 1: 1.手動計算:如果輸入是32×32影像,使用filter 5×5,stride=1,無padding → 特徵圖尺寸是多少?公式:
output_size = (input_size - kernel_size) / stride + 12.如果我們加入padding=2會怎麼樣? 3.為什麼MaxPool2d(2)會將影像尺寸縮小1/2?
2. 序列資料問題—“序列很重要”
CNN 非常適合圖像,但是序列資料(文字、語音、時間序列)呢?
2.1 為什麼需要不同的架構?
範例 1 — 意義更改順序:
"Tôi KHÔNG thích pizza"  ≠  "Tôi thích pizza"
→ Từ "không" ở giữa thay đổi nghĩa TOÀN CÂU
範例 2 — 遠端上下文:
"Người phụ nữ mặc áo đỏ, đeo kính, cầm ô,
 đứng cạnh cây cổ thụ trong công viên,
 đang ____ với con chó."
→ Cần nhớ "người phụ nữ" từ đầu câu để điền đúng!
範例 3 — 可變長度:
Input 1: "Xin chào" (2 từ)
Input 2: "Hôm nay trời đẹp quá, chúng ta đi dạo nhé!" (9 từ)
→ MLP cần input cố định → không xử lý được!
CNN 可以處理短文本(TextCNN),但很難捕捉長句子開頭和結尾的單字之間的遠距離關係。
💡練習 2: 再想 2 個越南語範例,其中詞序完全改變了意義。建議:否定句、被動句...
3. 循環神經網路 (RNN) — “閱讀每個單字,將其記在腦海中”
3.1 主要思想
日常生活範例: 你讀一本小說。你一頁一頁地閱讀,每讀完一頁,你記住你讀過的內容(隱藏狀態)。新的一頁+舊的記憶→新的理解。
RNN 的工作原理完全相同:讀取每個單字,維護每一步都會更新的隱藏狀態(短期記憶):
     x₁ ("Con")    x₂ ("mèo")    x₃ ("đang")    x₄ ("ngủ")
       ↓              ↓              ↓               ↓
h₀ → [RNN] → h₁ → [RNN] → h₂ → [RNN] → h₃ → [RNN] → h₄
 ↑            ↑             ↑             ↑            ↑
(ban đầu    (nhớ          (nhớ          (nhớ         (nhớ toàn
 trống)     "Con")        "Con mèo")    "Con mèo     câu)
                                         đang")
h_t = tanh(W_hh × h_{t-1} + W_xh × x_t + b)
       ↑           ↑              ↑
   activation   ký ức cũ       từ mới
class SimpleRNN(nn.Module):
    def __init__(self, input_size, hidden_size, output_size):
        super().__init__()
        self.hidden_size = hidden_size
        self.rnn = nn.RNN(input_size, hidden_size, batch_first=True)
        self.fc = nn.Linear(hidden_size, output_size)

    def forward(self, x):
        # x: (batch, seq_len, input_size) — batch câu, mỗi câu là chuỗi
        out, hidden = self.rnn(x)
        # Dùng hidden state cuối (chứa ký ức toàn câu) để dự đoán
        return self.fc(hidden.squeeze(0))

# Ví dụ: phân loại câu positive/negative
rnn = SimpleRNN(input_size=128, hidden_size=256, output_size=2)
x = torch.randn(8, 20, 128)  # 8 câu, mỗi câu 20 từ, mỗi từ embedding 128
output = rnn(x)
print(f"Input: {x.shape} → Output: {output.shape}")  # [8, 2]
3.2 梯度消失-致命弱點
日常生活中的例子: 你玩「電話遊戲」-20個人排隊,第一個人低聲說一句話,傳遞給每個人。到了最後一個人,訊息就被完全扭曲了,因為經過了太多的步驟。
RNN 也是如此!當在多個時間步上反向傳播時,梯度連續乘以相同的矩陣 W:
∂L/∂h₀ = ∂L/∂h_T × (W)^T lần
| 案例 | 後果 | 數值範例 |
|---|---|---|
| |W| < 1 | 梯度 → 0 (消失) | 0.9^20 = 0.12 → 差點就輸了! |
| |W| > 1 | 梯度→ 無窮大(爆炸) | 1.1^20 = 6.7 → 繁榮! |
**實際後果:**基本 RNN 只記住 ~10-20 個最近的單字。對於一個 100 個單字長的句子,RNN 完全「忘記」了句子的開頭。
# Demo: gradient vanishing qua nhiều bước nhân
w = 0.9  # < 1
gradients = [w**t for t in range(20)]
print("Gradient từ t=0 đến t=19:")
print([f"{g:.4f}" for g in gradients])
# [1.0, 0.9, 0.81, 0.729, ..., 0.1351] → giảm 87%!

print(f"\nSau 20 bước: gradient chỉ còn {gradients[-1]:.1%} ban đầu")
print(f"Sau 50 bước: {0.9**50:.6f} → gần như = 0!")
💡練習 3:
- 如果 W = 1.1 而不是 0.9,20 步後的梯度是多少? 100步之後?
- 為什麼梯度裁切(將梯度限制在[-max, max]之間)有助於解決爆炸問題而不是消失問題?
4. 長短期記憶(LSTM)—“選擇性記憶”
4.1 主要思想
現實生活中的例子: 比較 RNN 與 LSTM:
- RNN = 小便利貼上的註解 → 只能在舊的上面寫一點新的文字
- LSTM = 關於 鎖定筆記本 的註解 → 可能:
- 刪除你不需要的舊資訊(忘記門)—“刪除頁面”
- 新增重要的新資訊(輸入門)—“寫入新頁面”
- 閱讀所需資訊(輸出門)—“開啟頁面閱讀”
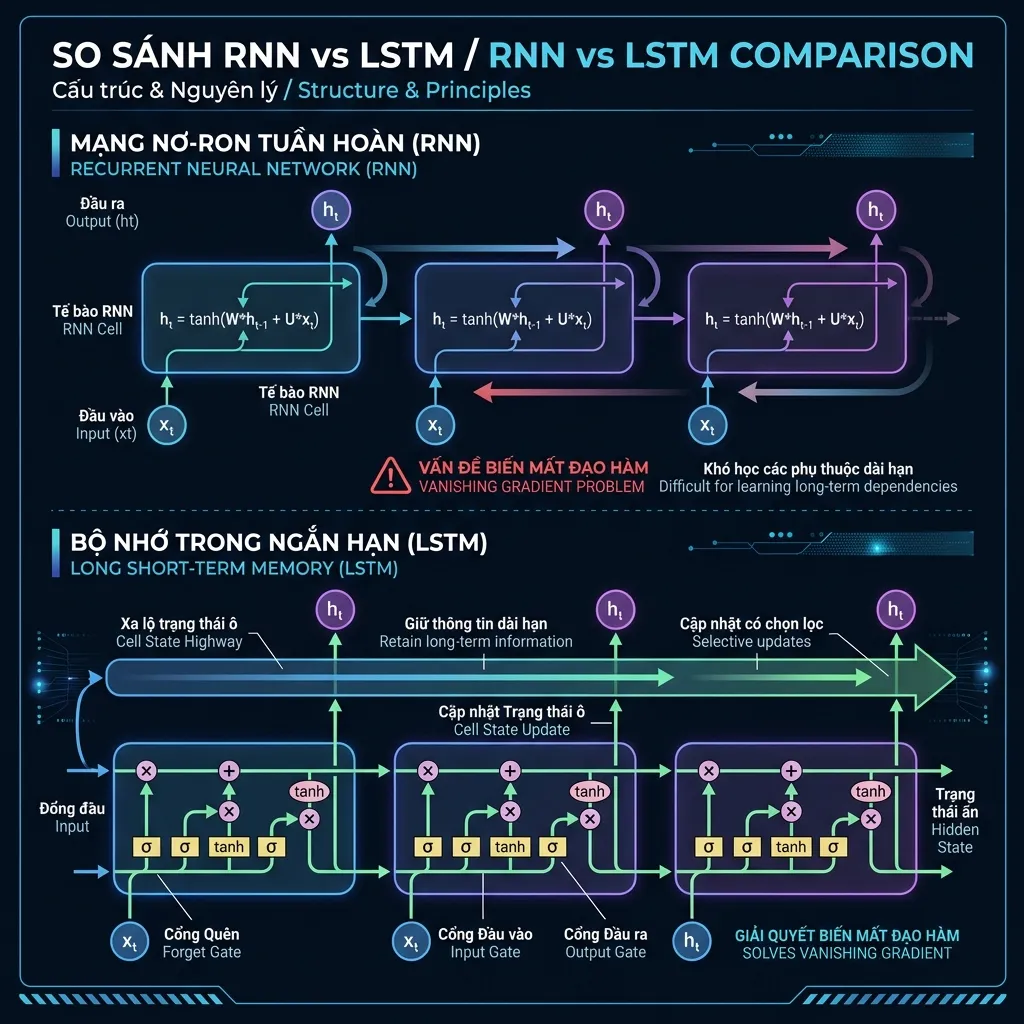
4.2 LSTM 的三個門
LSTM 維護 2 個資訊流:
- 細胞狀態(C) =「筆記本」-長期記憶,像傳送帶一樣貫穿整個鏈條
- 隱藏狀態 (h) = "便利貼" — 短期記憶,用於當前步驟
Forget Gate:  f_t = σ(W_f · [h_{t-1}, x_t] + b_f)    ← "Quên gì?"
Input Gate:   i_t = σ(W_i · [h_{t-1}, x_t] + b_i)    ← "Nhớ gì mới?"
              C̃_t = tanh(W_C · [h_{t-1}, x_t] + b_C)  ← "Thông tin mới"
Cell Update:  C_t = f_t × C_{t-1} + i_t × C̃_t         ← "Cập nhật sổ tay"
Output Gate:  o_t = σ(W_o · [h_{t-1}, x_t] + b_o)     ← "Output gì?"
              h_t = o_t × tanh(C_t)                     ← "Đọc & xuất"
具體範例 — LSTM 讀取句子「我出生於 越南。我在美國大學學習了 4 年。我的母語是 ___」:
| 步驟 | 忘記大門 | 輸入門 | 細胞狀態 |
|---|---|---|---|
| “越南” | 保留一切 | 寫“國籍:越南” | {國籍:越南} |
| 「美國」 | 保留 VN(不要忘記!) | 寫「出國留學:美國」 | {國籍:越南人,留學地:美國} |
| 「4年」 | 保留一切 | 寫「時間:4年」 | {國籍:越南,留學:美國,4年} |
| 「媽媽…」 | 忘記「出國留學」 | 聚焦「國籍」 | → 輸出:「越南語」 ✅ |
4.3 代碼 LSTM — 情緒分類
class SentimentLSTM(nn.Module):
    def __init__(self, vocab_size, embed_dim, hidden_size, n_layers=2):
        super().__init__()
        self.embedding = nn.Embedding(vocab_size, embed_dim, padding_idx=0)
        self.lstm = nn.LSTM(
            embed_dim, hidden_size,
            num_layers=n_layers,     # 2 lớp LSTM xếp chồng
            batch_first=True,
            dropout=0.3,             # Chống overfit
            bidirectional=True       # Đọc cả 2 chiều!
        )
        self.fc = nn.Linear(hidden_size * 2, 1)  # ×2 vì bidirectional
        self.sigmoid = nn.Sigmoid()

    def forward(self, x):
        embedded = self.embedding(x)           # Token IDs → vectors
        lstm_out, (hidden, _) = self.lstm(embedded)
        # Lấy hidden state cuối của cả 2 chiều (forward + backward)
        hidden = torch.cat([hidden[-2], hidden[-1]], dim=1)
        return self.sigmoid(self.fc(hidden))   # 0→1: negative→positive

# Ví dụ sử dụng
model = SentimentLSTM(vocab_size=10000, embed_dim=128, hidden_size=256)
x = torch.randint(0, 10000, (8, 50))  # 8 câu, mỗi câu 50 tokens
output = model(x)
print(f"Sentiment predictions: {output.squeeze()[:3]}")  # 3 câu đầu
雙向 LSTM = 雙向閱讀(左→右和右→左)。為什麼?因為有時候你需要看背後才能理解其中的意思:
"Anh ấy không phải là người ____ nhất, nhưng rất chăm chỉ"
→ Cần đọc "nhưng rất chăm chỉ" (phía sau) để biết ____ = "giỏi" (chứ không phải "tệ")
4.4 比較 RNN、LSTM 和 GRU
| 循環神經網路 | LSTM | 格魯烏 | |
|---|---|---|---|
| 大門 | 0 | 3(忘記、輸入、輸出) | 2(重置、更新) |
| 參數 | 至少 | 大多數 | 平均 |
| 記得遠 | ❌ ~10 字 | ✅ ~200 字 | ✅ ~200 字 |
| 列車速度 | 快 | 慢 | 平均 |
| 何時使用 | 演示/學習 | 長文本,NLP | 文本長,數據少 |
GRU是LSTM的簡化版本:將遺忘+輸入門合併為更新門,去除細胞狀態。性能與 LSTM 相當,但參數較少。
💡練習 4:
- LSTM有幾個權重矩陣?提示:每個閘有 2 個矩陣(W 表示輸入,U 表示隱藏狀態),加上候選單元狀態。
- 如果hidden_size = 256,input_size = 128,則1個LSTM單元的總參數 = ?公式:
4 × (input_size × hidden_size + hidden_size × hidden_size + hidden_size)
5. LSTM 的限制以及為什麼我們需要 Transformer
儘管 LSTM 比 RNN 強大得多,但它仍然存在 2 個基本問題,從而引發了 Transformer 革命:
5.1 ❌ 順序處理 — “一次一個單字”
x₁ → h₁ → x₂ → h₂ → x₃ → h₃ → ... → x_1000 → h_1000
     ↑ phải chờ ↑ phải chờ ↑ phải chờ
LSTM 必須依序處理 — h₃ 取決於 h2,h2 取決於 h₁。這意味著:
| 後果 | 說明 | 影響力 |
|---|---|---|
| 未並行化 | GPU 有 10,000 個核心,但只使用 1 個 | 浪費 99.99% GPU |
| 慢速訓練 | 句子 1000 個字 = 1000 個連續步驟 | 日 → 週 → 月 |
| 無法擴充 | 2x 長 = 2x 慢(線性) | 無法處理長書/文件 |
範例: 在 100 萬個句子 × 100 個字 = 1 億個連續步驟上訓練 LSTM。 Transformer 可以並行 = 快 100 倍!
5.2 ❌資訊瓶頸—“資訊瓶頸”
雖然細胞狀態有助於進一步記憶,但句子的所有含義必須「通過」固定大小的向量 h_T(例如 256 個數字):
"The cat that ate the mouse that lived in the house that Jack built sat on the mat"
                                                                      ↓
                                                              h_T = [0.2, -0.3, ...]
                                                              (nén 15 từ → 256 số!)
對於 1000 個單字的句子,256 位元向量不足以記住所有內容→訊息丟失。
5.3 ✅ 解決方案:Transformer (2017)
Transformer 透過 注意力機制 解決了 這兩個問題:
| LSTM 問題 | 變壓器解決方案 |
|---|---|
| 順序處理 | 並行化 — 一次處理所有單字 |
| 資訊瓶頸 | 注意 — 每個單字「直接看」其他每個單字 |
LSTM: x₁ → x₂ → x₃ → x₄ → x₅  (tuần tự, chậm)

Transformer:
x₁ ←→ x₂
x₁ ←→ x₃     Tất cả từ "nhìn" nhau
x₁ ←→ x₄     cùng lúc, song song!
x₂ ←→ x₃
...
這是**《Attention Is All You Need》** (2017) 文章的突破-用注意力機製完全取代 RNN/LSTM。我們將在下一篇文章中深入探討。
💡練習 5:
- LSTM 用 100 個步驟處理一個 100 個單字的句子。 Transformer 需要多少步? (提示:Transformer 並行處理所有單字)
- Transformer 為什麼會出現「二次注意力成本」問題?提示:如果有 N 個單詞,每個單字必須「看到」多少個其他單字?
6. 什麼時候我還應該使用 CNN/RNN/LSTM?
儘管 Transformer 在 NLP 中佔據主導地位,但 CNN 和 LSTM 在許多問題中仍然佔有一席之地:
CNN 仍用於:
- 電腦視覺:ResNet、EfficientNet 仍然很流行(儘管 Vision Transformer 正在取代)
- 音訊處理:用於音訊分類的一維卷積
- 簡單文字分類:TextCNN 快速、輕量級且對於小問題高度準確
- 邊緣設備:可在手機上運行的輕量級 CNN (MobileNet)
LSTM/GRU 仍用於:
- 小型裝置上的時間序列:預測物聯網上的感測器數據
- 串流資料:資料連續到達(不是批次)
- 小資料集:Transformer 資料少很容易過擬合,LSTM 更好
- 即時推理:LSTM處理每一步,反應快
規則:如果有大量資料+強大的GPU → Transformer。如果小數據+小裝置 → CNN/LSTM。
💡練習 6: 給定 3 個問題,你會選擇哪一種架構?說明:
- 將垃圾郵件/普通郵件分類(1000 封郵件,每封郵件約 50 個字)
- 聊天機器人回答問題(100萬次對話) 3.安全攝影機上的臉部辨識(即時)
總結
| 建築 | 強 | 弱 | 用於 | 黃金時代 |
|---|---|---|---|---|
| 美國有線電視新聞網 | 本地模式,快速 | 遠程、序列 | 圖片、短文 | 2012 年至今 |
| RNN | 順序處理 | 梯度消失 | 簡單的序列 | 2013–2017 |
| LSTM | 長程記憶 | 順序、緩慢 | 中等序列 | 2015–2018 |
| 變壓器 | 並行、遠端 | 成本 O(N²) | NLP、法學碩士、願景 | 2017 年–至今 |
進化時間表
1998: LeNet (CNN cho chữ số)
  ↓
2012: AlexNet (CNN thắng ImageNet → Deep Learning bùng nổ)
  ↓
2014: Sequence-to-Sequence (LSTM cho dịch thuật)
  ↓
2015: Attention + LSTM (cải thiện dịch thuật)
  ↓
2017: "Attention Is All You Need" → TRANSFORMER 💥
  ↓
2018: BERT, GPT-1 (Transformer thống trị NLP)
  ↓
2020+: GPT-3, ChatGPT → LLM thời đại mới
一般練習
- ✅ 完成每個部分的所有小練習(1,2,3,4,5,6)
- 使用 PyTorch,實現 1.3 節中的 SimpleCNN 並在 MNIST 資料集上進行訓練。準確率達 >98%。
- 實現 4.3 節中的 SentimentLSTM 並在電影評論資料集 (IMDB) 上進行訓練。準確率達 >85%。
- 實驗比較: 使用(a) MLP、(b) CNN (TextCNN)、(c) LSTM 訓練相同的文字分類問題。比較準確性、訓練時間和參數數量。
- 閱讀文章「Attention Is All You Need」的摘要 — 列出了作者給出的 3 個以 Transformer 取代 RNN 的理由。
下一篇文章: 我們將了解 注意力 機制 - Transformer 和所有現代法學碩士非凡力量的關鍵。