Giới thiệu
Ở bài trước, chúng ta đã xây dựng MLP — neural network tổng quát. Nhưng MLP có vấn đề: nó không hiểu cấu trúc của dữ liệu. Với ảnh, MLP "nhìn" mọi pixel như nhau — không biết pixel nào cạnh pixel nào. Với văn bản, MLP không biết thứ tự từ nào trước từ nào sau.
Bài này giới thiệu 3 kiến trúc chuyên biệt — mỗi kiến trúc sinh ra để giải quyết một loại dữ liệu cụ thể:
| Kiến trúc | Sinh ra cho | Ý tưởng chính | Ví dụ thực tế |
|---|---|---|---|
| CNN | Ảnh, video | "Nhìn từng vùng nhỏ" | Google Photos phân loại ảnh |
| RNN | Chuỗi (text, speech) | "Nhớ những gì đã đọc" | Gợi ý từ khi gõ tin nhắn |
| LSTM | Chuỗi dài | "Nhớ có chọn lọc" | Google Translate (trước 2017) |
Spoiler: Cả 3 đều có điểm yếu, và đó là lý do Transformer ra đời năm 2017 — thứ đã thay đổi mọi thứ. Hãy cùng tìm hiểu tại sao.
1. Convolutional Neural Networks (CNN) — "Nhìn từng vùng nhỏ"
1.1 Vấn đề của MLP với ảnh
Hãy tưởng tượng bạn muốn nhận dạng chữ số viết tay (ảnh 28×28 pixel):
-
MLP: "Duỗi" ảnh thành 1 hàng 784 số → mất hoàn toàn thông tin vị trí. Pixel góc trái trên và pixel giữa ảnh đều được xử lý như nhau. Hơn nữa, MLP cần 784 × hidden_size tham số cho lớp đầu — rất nhiều!
-
CNN: "Nhìn" ảnh theo từng vùng nhỏ (3×3 hoặc 5×5 pixels), tìm các đặc trưng cục bộ (cạnh, góc, đường cong). Ít tham số hơn và hiểu vị trí tốt hơn.
1.2 Convolution — "Bộ lọc trượt"
Ví dụ đời thường: Bạn soi kính lúp trên bức ảnh. Kính lúp nhỏ (3×3 cm), bạn trượt kính từ góc trái trên xuống góc phải dưới. Tại mỗi vị trí, bạn ghi lại một con số tóm tắt vùng đó (sáng/tối, có cạnh không, có góc không...). Kết quả → một "bản đồ đặc trưng" (feature map).
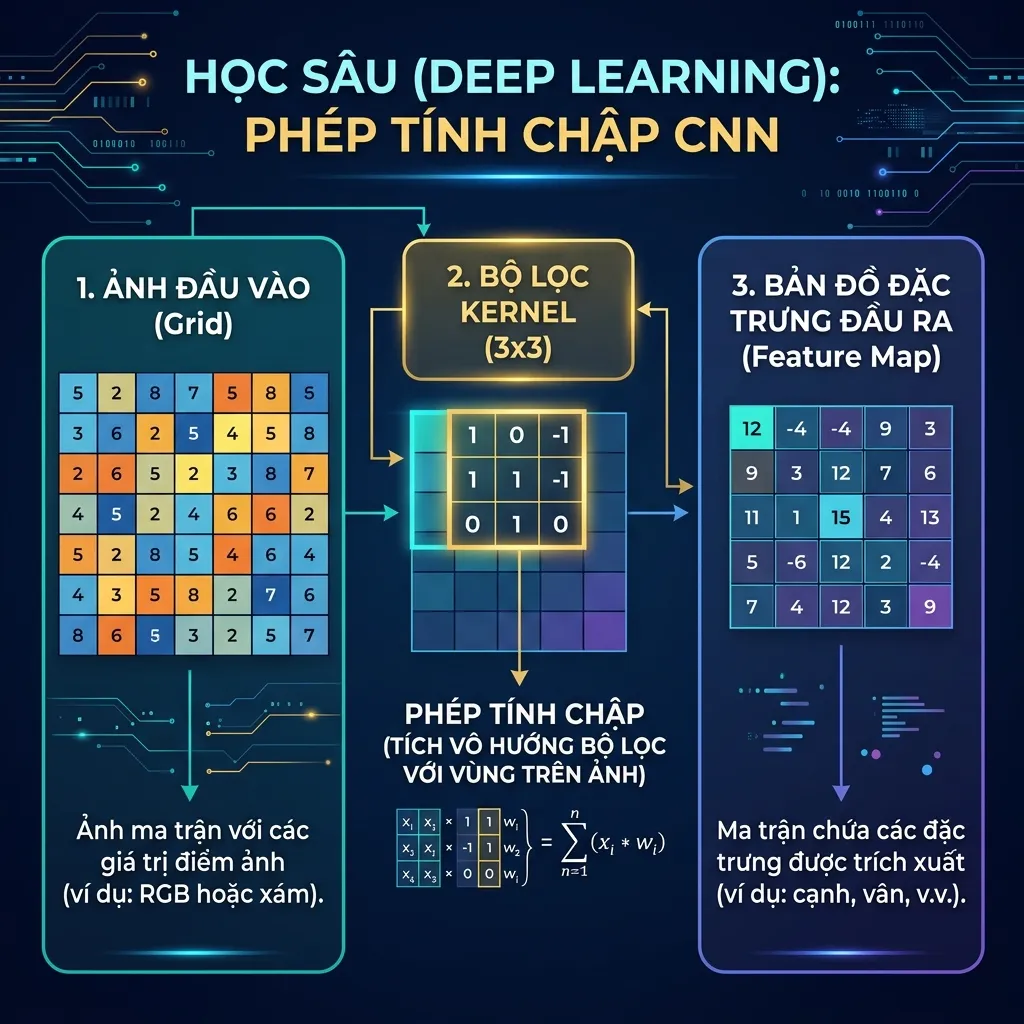
Input image (6×6):     Filter (3×3):     Feature map (4×4):
┌─────────────────┐    ┌─────────┐       ┌─────────────┐
│ 1 1 1 │ 0 0 0  │    │ 1  0  1 │       │ 4  3  2  1  │
│ 1 1 1 │ 0 0 0  │  × │ 0  1  0 │   =   │ ...         │
│ 1 1 1 │ 0 0 0  │    │ 1  0  1 │       │ ...         │
│ 0 0 0 │ 1 1 1  │    └─────────┘       │ 1  2  3  4  │
│ 0 0 0 │ 1 1 1  │      ↑ Trượt          └─────────────┘
│ 0 0 0 │ 1 1 1  │      qua ảnh
└─────────────────┘
Tại mỗi vị trí: nhân tương ứng rồi cộng (giống dot product!) → 1 số.
3 ưu điểm lớn của CNN:
| Ưu điểm | Giải thích | Ví dụ |
|---|---|---|
| Parameter sharing | Cùng 1 filter dùng cho toàn ảnh | 1 filter 3×3 = chỉ 9 params (thay vì hàng nghìn) |
| Local connectivity | Mỗi neuron chỉ nhìn vùng nhỏ | Phát hiện cạnh, góc, texture |
| Translation invariance | Nhận ra vật dù ở vị trí nào | Nhận ra mèo dù mèo ở góc nào |
1.3 Kiến trúc CNN — Từ pixel đến quyết định
CNN xếp nhiều lớp, từ đặc trưng đơn giản → đặc trưng phức tạp:
Lớp 1: Phát hiện cạnh (edges) ─── Filter đơn giản
    ↓
Lớp 2: Phát hiện góc, texture ─── Kết hợp cạnh
    ↓
Lớp 3: Phát hiện bộ phận (mắt, mũi, tai) ─── Kết hợp góc + texture
    ↓
Lớp 4: Nhận ra đối tượng (mèo, chó) ─── Kết hợp bộ phận
Ví dụ: Nhận dạng mèo: pixel → cạnh → tam giác (tai) + hình tròn (mắt) → "mèo"!
import torch
import torch.nn as nn

class SimpleCNN(nn.Module):
    def __init__(self, num_classes=10):
        super().__init__()
        self.features = nn.Sequential(
            # === Lớp 1: Phát hiện đặc trưng cơ bản ===
            nn.Conv2d(1, 32, kernel_size=3, padding=1),  # 28×28 → 28×28, 32 filters
            nn.ReLU(),
            nn.MaxPool2d(2),                              # 28×28 → 14×14 (thu nhỏ)

            # === Lớp 2: Phát hiện đặc trưng phức tạp hơn ===
            nn.Conv2d(32, 64, kernel_size=3, padding=1), # 14×14 → 14×14, 64 filters
            nn.ReLU(),
            nn.MaxPool2d(2),                              # 14×14 → 7×7
        )
        self.classifier = nn.Sequential(
            nn.Flatten(),                # 64 × 7 × 7 = 3136 số
            nn.Linear(64 * 7 * 7, 128), # Dense layer
            nn.ReLU(),
            nn.Linear(128, num_classes)  # Output: 10 lớp (0-9)
        )

    def forward(self, x):
        features = self.features(x)      # Trích xuất đặc trưng
        return self.classifier(features)  # Phân loại

# Test
model = SimpleCNN(num_classes=10)
x = torch.randn(8, 1, 28, 28)  # 8 ảnh, 1 kênh (grayscale), 28×28
output = model(x)
print(f"Input: {x.shape} → Output: {output.shape}")  # [8, 10]
print(f"Tổng parameters: {sum(p.numel() for p in model.parameters()):,}")
1.4 Các CNN nổi tiếng — Cột mốc lịch sử
| Model | Năm | Đặc điểm | Tại sao quan trọng |
|---|---|---|---|
| LeNet-5 | 1998 | CNN đầu tiên thực dụng | Đọc số trên séc ngân hàng |
| AlexNet | 2012 | GPU training, ReLU, Dropout | Thắng ImageNet → Deep Learning bùng nổ |
| VGG | 2014 | Rất sâu (16-19 lớp), chỉ dùng 3×3 | Chứng minh "sâu hơn = tốt hơn" |
| ResNet | 2015 | Skip connections, 152 lớp | Giải quyết vanishing gradient ở mạng rất sâu |
| EfficientNet | 2019 | Scale thông minh | Tối ưu tốc độ/accuracy |
💡 Bài tập 1:
- Tính bằng tay: nếu input là ảnh 32×32, dùng filter 5×5, stride=1, no padding → feature map có kích thước bao nhiêu? Công thức:
output_size = (input_size - kernel_size) / stride + 1- Nếu thêm padding=2 thì sao?
- Tại sao MaxPool2d(2) giảm kích thước ảnh xuống 1/2?
2. Vấn đề Sequence Data — "Thứ tự quan trọng"
CNN rất tốt cho ảnh, nhưng với dữ liệu tuần tự (text, speech, time series) thì sao?
2.1 Tại sao cần kiến trúc khác?
Ví dụ 1 — Thứ tự thay đổi ý nghĩa:
"Tôi KHÔNG thích pizza"  ≠  "Tôi thích pizza"
→ Từ "không" ở giữa thay đổi nghĩa TOÀN CÂU
Ví dụ 2 — Ngữ cảnh xa:
"Người phụ nữ mặc áo đỏ, đeo kính, cầm ô,
 đứng cạnh cây cổ thụ trong công viên,
 đang ____ với con chó."
→ Cần nhớ "người phụ nữ" từ đầu câu để điền đúng!
Ví dụ 3 — Độ dài thay đổi:
Input 1: "Xin chào" (2 từ)
Input 2: "Hôm nay trời đẹp quá, chúng ta đi dạo nhé!" (9 từ)
→ MLP cần input cố định → không xử lý được!
CNN có thể xử lý text ngắn (TextCNN), nhưng khó nắm bắt mối quan hệ xa giữa từ ở đầu và cuối câu dài.
💡 Bài tập 2: Nghĩ thêm 2 ví dụ tiếng Việt mà thứ tự từ thay đổi nghĩa hoàn toàn. Gợi ý: phủ định, câu bị động...
3. Recurrent Neural Networks (RNN) — "Đọc từng từ, nhớ trong đầu"
3.1 Ý tưởng chính
Ví dụ đời thường: Bạn đọc một cuốn tiểu thuyết. Bạn đọc từng trang, và sau mỗi trang, bạn nhớ những gì đã đọc (hidden state). Trang mới + ký ức cũ → hiểu biết mới.
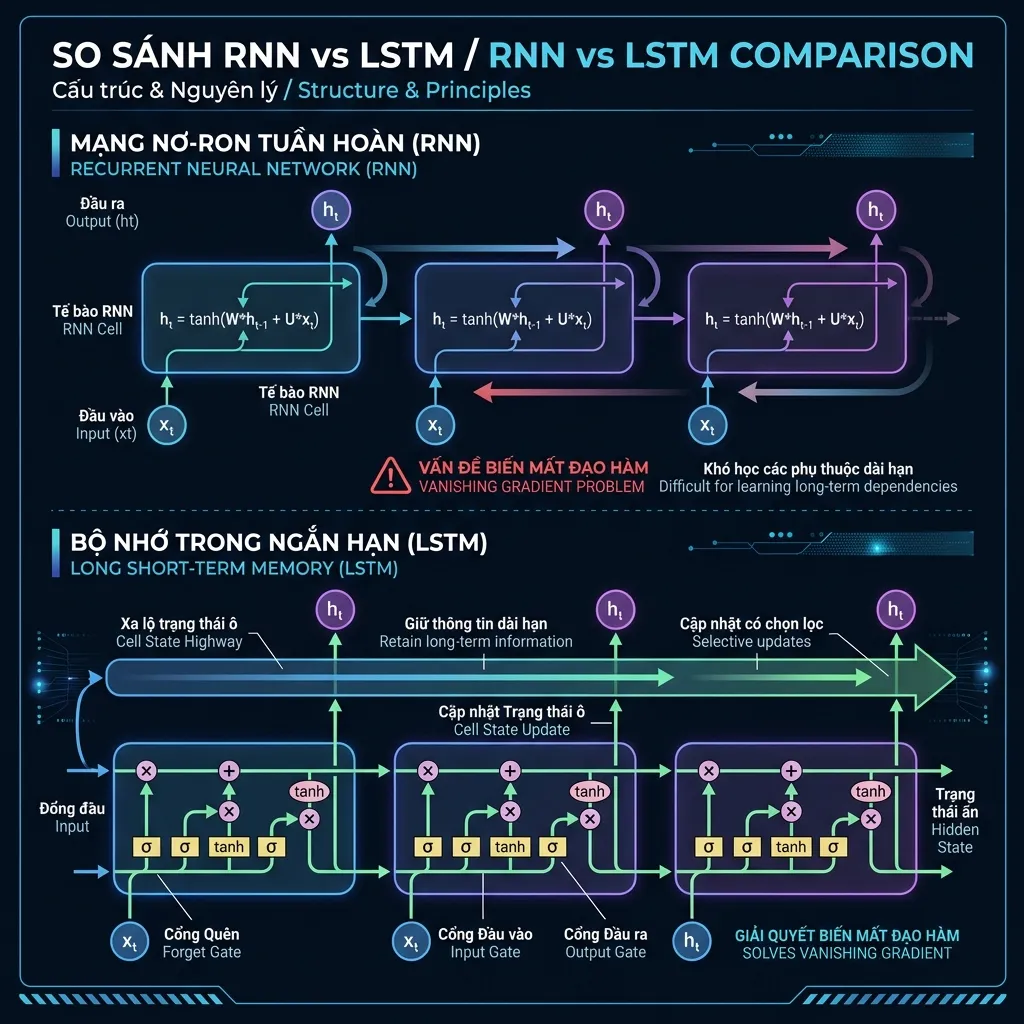
RNN hoạt động y hệt: đọc từng từ, duy trì hidden state (bộ nhớ ngắn hạn) được cập nhật qua mỗi bước:
     x₁ ("Con")    x₂ ("mèo")    x₃ ("đang")    x₄ ("ngủ")
       ↓              ↓              ↓               ↓
h₀ → [RNN] → h₁ → [RNN] → h₂ → [RNN] → h₃ → [RNN] → h₄
 ↑            ↑             ↑             ↑            ↑
(ban đầu    (nhớ          (nhớ          (nhớ         (nhớ toàn
 trống)     "Con")        "Con mèo")    "Con mèo     câu)
                                         đang")
h_t = tanh(W_hh × h_{t-1} + W_xh × x_t + b)
       ↑           ↑              ↑
   activation   ký ức cũ       từ mới
class SimpleRNN(nn.Module):
    def __init__(self, input_size, hidden_size, output_size):
        super().__init__()
        self.hidden_size = hidden_size
        self.rnn = nn.RNN(input_size, hidden_size, batch_first=True)
        self.fc = nn.Linear(hidden_size, output_size)

    def forward(self, x):
        # x: (batch, seq_len, input_size) — batch câu, mỗi câu là chuỗi
        out, hidden = self.rnn(x)
        # Dùng hidden state cuối (chứa ký ức toàn câu) để dự đoán
        return self.fc(hidden.squeeze(0))

# Ví dụ: phân loại câu positive/negative
rnn = SimpleRNN(input_size=128, hidden_size=256, output_size=2)
x = torch.randn(8, 20, 128)  # 8 câu, mỗi câu 20 từ, mỗi từ embedding 128
output = rnn(x)
print(f"Input: {x.shape} → Output: {output.shape}")  # [8, 2]
3.2 Vanishing Gradient — Điểm yếu chết người
Ví dụ đời thường: Bạn chơi trò "Truyền tin" (telephone game) — 20 người xếp hàng, người đầu thì thầm một câu, truyền qua từng người. Đến người cuối cùng, thông tin đã biến dạng hoàn toàn vì qua quá nhiều bước.
RNN cũng vậy! Khi backpropagation qua nhiều bước thời gian, gradient bị nhân liên tiếp với cùng ma trận W:
∂L/∂h₀ = ∂L/∂h_T × (W)^T lần
| Trường hợp | Hệ quả | Ví dụ số |
|---|---|---|
| |W| < 1 | gradient → 0 (vanishing) | 0.9^20 = 0.12 → gần mất! |
| |W| > 1 | gradient → ∞ (exploding) | 1.1^20 = 6.7 → bùng nổ! |
Hệ quả thực tế: RNN cơ bản chỉ nhớ được ~10-20 từ gần nhất. Với câu dài 100 từ, RNN đã "quên" hoàn toàn đầu câu.
# Demo: gradient vanishing qua nhiều bước nhân
w = 0.9  # < 1
gradients = [w**t for t in range(20)]
print("Gradient từ t=0 đến t=19:")
print([f"{g:.4f}" for g in gradients])
# [1.0, 0.9, 0.81, 0.729, ..., 0.1351] → giảm 87%!

print(f"\nSau 20 bước: gradient chỉ còn {gradients[-1]:.1%} ban đầu")
print(f"Sau 50 bước: {0.9**50:.6f} → gần như = 0!")
💡 Bài tập 3:
- Nếu W = 1.1 thay vì 0.9, gradient sau 20 bước = bao nhiêu? Sau 100 bước?
- Tại sao gradient clipping (giới hạn gradient trong khoảng [-max, max]) giúp giải quyết exploding nhưng KHÔNG giải quyết vanishing?
4. Long Short-Term Memory (LSTM) — "Nhớ có chọn lọc"
4.1 Ý tưởng chính
Ví dụ đời thường: So sánh RNN vs LSTM:
- RNN = ghi chú trên Post-it nhỏ → chỉ ghi được ít, viết mới đè lên cũ
- LSTM = ghi chú trên sổ tay có khóa → có thể:
- Xóa thông tin cũ không cần (forget gate) — "xóa trang"
- Thêm thông tin mới quan trọng (input gate) — "viết trang mới"
- Đọc thông tin cần dùng (output gate) — "mở trang cần đọc"
4.2 Ba cánh cổng (gates) của LSTM
LSTM duy trì 2 luồng thông tin:
- Cell state (C) = "sổ tay" — bộ nhớ dài hạn, chạy suốt chuỗi như băng chuyền
- Hidden state (h) = "Post-it" — bộ nhớ ngắn hạn, dùng cho bước hiện tại
Forget Gate:  f_t = σ(W_f · [h_{t-1}, x_t] + b_f)    ← "Quên gì?"
Input Gate:   i_t = σ(W_i · [h_{t-1}, x_t] + b_i)    ← "Nhớ gì mới?"
              C̃_t = tanh(W_C · [h_{t-1}, x_t] + b_C)  ← "Thông tin mới"
Cell Update:  C_t = f_t × C_{t-1} + i_t × C̃_t         ← "Cập nhật sổ tay"
Output Gate:  o_t = σ(W_o · [h_{t-1}, x_t] + b_o)     ← "Output gì?"
              h_t = o_t × tanh(C_t)                     ← "Đọc & xuất"
Ví dụ cụ thể — LSTM đọc câu "Tôi sinh ra ở Việt Nam. Tôi học đại học ở Mỹ 4 năm. Ngôn ngữ mẹ đẻ của tôi là ___":
| Bước | Forget gate | Input gate | Cell state |
|---|---|---|---|
| "Việt Nam" | Giữ hết | Ghi "quốc tịch: VN" | {quốc tịch: VN} |
| "Mỹ" | Giữ VN (không quên!) | Ghi "du học: Mỹ" | {quốc tịch: VN, du học: Mỹ} |
| "4 năm" | Giữ hết | Ghi "thời gian: 4 năm" | {quốc tịch: VN, du học: Mỹ, 4 năm} |
| "mẹ đẻ..." | Quên "du học" | Tập trung "quốc tịch" | → Output: "Tiếng Việt" ✅ |
4.3 Code LSTM — Phân loại cảm xúc
class SentimentLSTM(nn.Module):
    def __init__(self, vocab_size, embed_dim, hidden_size, n_layers=2):
        super().__init__()
        self.embedding = nn.Embedding(vocab_size, embed_dim, padding_idx=0)
        self.lstm = nn.LSTM(
            embed_dim, hidden_size,
            num_layers=n_layers,     # 2 lớp LSTM xếp chồng
            batch_first=True,
            dropout=0.3,             # Chống overfit
            bidirectional=True       # Đọc cả 2 chiều!
        )
        self.fc = nn.Linear(hidden_size * 2, 1)  # ×2 vì bidirectional
        self.sigmoid = nn.Sigmoid()

    def forward(self, x):
        embedded = self.embedding(x)           # Token IDs → vectors
        lstm_out, (hidden, _) = self.lstm(embedded)
        # Lấy hidden state cuối của cả 2 chiều (forward + backward)
        hidden = torch.cat([hidden[-2], hidden[-1]], dim=1)
        return self.sigmoid(self.fc(hidden))   # 0→1: negative→positive

# Ví dụ sử dụng
model = SentimentLSTM(vocab_size=10000, embed_dim=128, hidden_size=256)
x = torch.randint(0, 10000, (8, 50))  # 8 câu, mỗi câu 50 tokens
output = model(x)
print(f"Sentiment predictions: {output.squeeze()[:3]}")  # 3 câu đầu
Bidirectional LSTM = đọc 2 chiều (trái→phải VÀ phải→trái). Tại sao? Vì đôi khi cần nhìn cả phía sau để hiểu ý nghĩa:
"Anh ấy không phải là người ____ nhất, nhưng rất chăm chỉ"
→ Cần đọc "nhưng rất chăm chỉ" (phía sau) để biết ____ = "giỏi" (chứ không phải "tệ")
4.4 So sánh RNN vs LSTM vs GRU
| RNN | LSTM | GRU | |
|---|---|---|---|
| Gates | 0 | 3 (forget, input, output) | 2 (reset, update) |
| Parameters | Ít nhất | Nhiều nhất | Trung bình |
| Nhớ xa | ❌ ~10 từ | ✅ ~200 từ | ✅ ~200 từ |
| Tốc độ train | Nhanh | Chậm | Trung bình |
| Khi nào dùng | Demo/ học tập | Text dài, NLP | Text dài, ít data |
GRU là phiên bản đơn giản hóa của LSTM: gộp forget + input gate thành update gate, bỏ cell state. Hiệu năng tương đương LSTM nhưng ít parameter hơn.
💡 Bài tập 4:
- LSTM có bao nhiêu bộ trọng số (weight matrices)? Gợi ý: mỗi gate có 2 matrices (W cho input, U cho hidden state), plus cell state candidate.
- Nếu hidden_size = 256, input_size = 128, tổng parameters của 1 LSTM cell = ? Công thức:
4 × (input_size × hidden_size + hidden_size × hidden_size + hidden_size)
5. Giới hạn của LSTM và tại sao cần Transformer
Dù LSTM mạnh hơn RNN rất nhiều, nó vẫn có 2 vấn đề cơ bản đã tạo nên cuộc cách mạng Transformer:
5.1 ❌ Sequential Processing — "Một lúc một từ"
x₁ → h₁ → x₂ → h₂ → x₃ → h₃ → ... → x_1000 → h_1000
     ↑ phải chờ ↑ phải chờ ↑ phải chờ
LSTM phải xử lý tuần tự — h₃ phụ thuộc h₂, h₂ phụ thuộc h₁. Điều này có nghĩa:
| Hệ quả | Giải thích | Ảnh hưởng |
|---|---|---|
| Không song song hóa | GPU có 10,000 core nhưng chỉ dùng 1 | Lãng phí 99.99% GPU |
| Training chậm | Câu 1000 từ = 1000 bước tuần tự | Ngày → tuần → tháng |
| Không scale được | 2x dài = 2x chậm (linear) | Không thể xử lý sách/tài liệu dài |
Ví dụ: Huấn luyện LSTM trên 1 triệu câu × 100 từ = 100 triệu bước tuần tự. Transformer có thể xử lý song song = nhanh hơn 100×!
5.2 ❌ Information Bottleneck — "Cổ chai thông tin"
Dù cell state giúp nhớ xa hơn, tất cả ý nghĩa của một câu phải "chui qua" một vector h_T có kích thước cố định (ví dụ: 256 số):
"The cat that ate the mouse that lived in the house that Jack built sat on the mat"
                                                                      ↓
                                                              h_T = [0.2, -0.3, ...]
                                                              (nén 15 từ → 256 số!)
Với câu 1000 từ, vector 256 số không đủ để nhớ mọi thứ → thông tin bị mất.
5.3 ✅ Giải pháp: Transformer (2017)
Transformer giải quyết cả hai vấn đề bằng Attention Mechanism:
| Vấn đề LSTM | Giải pháp Transformer |
|---|---|
| Xử lý tuần tự | Song song hóa — xử lý tất cả từ cùng lúc |
| Information bottleneck | Attention — mỗi từ "nhìn thẳng" vào mọi từ khác |
LSTM: x₁ → x₂ → x₃ → x₄ → x₅  (tuần tự, chậm)

Transformer:
x₁ ←→ x₂
x₁ ←→ x₃     Tất cả từ "nhìn" nhau
x₁ ←→ x₄     cùng lúc, song song!
x₂ ←→ x₃
...
Đây chính là đột phá của bài báo "Attention Is All You Need" (2017) — thay thế hoàn toàn RNN/LSTM bằng cơ chế attention. Chúng ta sẽ đi sâu vào bài tiếp theo.
💡 Bài tập 5:
- LSTM xử lý câu 100 từ cần 100 bước. Transformer cần bao nhiêu bước? (Gợi ý: Transformer xử lý song song tất cả từ cùng lúc)
- Tại sao Transformer lại có vấn đề "quadratic attention cost"? Gợi ý: nếu có N từ, mỗi từ phải "nhìn" bao nhiêu từ khác?
6. Khi nào vẫn dùng CNN/RNN/LSTM?
Dù Transformer thống trị NLP, CNN và LSTM vẫn có chỗ đứng trong nhiều bài toán:
CNN vẫn dùng cho:
- Computer Vision: ResNet, EfficientNet vẫn phổ biến (dù Vision Transformer đang thay thế)
- Audio processing: 1D convolution cho phân loại âm thanh
- Text classification đơn giản: TextCNN nhanh, nhẹ, chính xác cao cho bài toán nhỏ
- Edge devices: CNN nhẹ chạy được trên điện thoại (MobileNet)
LSTM/GRU vẫn dùng cho:
- Time series trên thiết bị nhỏ: dự đoán sensor data trên IoT
- Streaming data: dữ liệu đến liên tục (chứ không phải batch)
- Dataset nhỏ: Transformer dễ overfit với ít dữ liệu, LSTM ổn hơn
- Real-time inference: LSTM xử lý từng bước, response nhanh
Quy tắc: Nếu có nhiều dữ liệu + GPU mạnh → Transformer. Nếu ít dữ liệu + thiết bị nhỏ → CNN/LSTM.
💡 Bài tập 6: Cho 3 bài toán, bạn sẽ chọn kiến trúc nào? Giải thích:
- Phân loại email spam/ham (1000 emails, mỗi email ~50 từ)
- Chatbot trả lời câu hỏi (1 triệu conversations)
- Nhận dạng khuôn mặt trên camera an ninh (real-time)
Tổng kết
| Kiến trúc | Mạnh | Yếu | Dùng cho | Thời kỳ hoàng kim |
|---|---|---|---|---|
| CNN | Local patterns, nhanh | Long-range, sequence | Image, short text | 2012–nay |
| RNN | Sequential processing | Vanishing gradient | Simple sequences | 2013–2017 |
| LSTM | Long-range memory | Sequential, chậm | Medium sequences | 2015–2018 |
| Transformer | Parallel, long-range | Chi phí O(N²) | NLP, LLM, Vision | 2017–nay |
Dòng thời gian tiến hóa
1998: LeNet (CNN cho chữ số)
  ↓
2012: AlexNet (CNN thắng ImageNet → Deep Learning bùng nổ)
  ↓
2014: Sequence-to-Sequence (LSTM cho dịch thuật)
  ↓
2015: Attention + LSTM (cải thiện dịch thuật)
  ↓
2017: "Attention Is All You Need" → TRANSFORMER 💥
  ↓
2018: BERT, GPT-1 (Transformer thống trị NLP)
  ↓
2020+: GPT-3, ChatGPT → LLM thời đại mới
Bài tập tổng hợp
- ✅ Hoàn thành tất cả bài tập nhỏ trong từng phần (1, 2, 3, 4, 5, 6)
- Dùng PyTorch, implement SimpleCNN ở phần 1.3 và train trên MNIST dataset. Đạt >98% accuracy.
- Implement SentimentLSTM ở phần 4.3 và train trên dataset phim reviews (IMDB). Đạt >85% accuracy.
- So sánh thực nghiệm: Train cùng bài toán text classification với (a) MLP, (b) CNN (TextCNN), (c) LSTM. So sánh accuracy, training time, và số parameters.
- Đọc abstract bài báo "Attention Is All You Need" — liệt kê 3 lý do tác giả nêu ra cho việc thay thế RNN bằng Transformer.
Bài tiếp theo: Chúng ta sẽ tìm hiểu cơ chế Attention — chìa khóa làm nên sức mạnh phi thường của Transformer và mọi LLM hiện đại.