はじめに
ツールをインストールする前に、チームでアーキテクチャを合意する必要があります。アーキテクチャがないと、ローカルAIスタックはすぐにバラバラなスクリプトの寄せ集めになります — 全員がバラバラに実行し、出力が一貫せず、エラーが発生しても原因がわかりません。
このレッスンでは、基礎から実践まで、すぐに適用できるアプローチで解説します:
- ローカルAIに最初からアーキテクチャが必要な理由
- 開発チーム向けの4層モデル
- フロントエンド・バックエンド・データチームが独立して作業できるAPIコントラクトの設計
- タスクタイプ別のモデルルーティング
- ローカルAIプロジェクトを早期に失敗させるアンチパターン
- 30日間のデプロイチェックリスト
このレッスンの後、推測せずにデプロイを開始できる明確なブループリントが得られます。
1. アーキテクチャの目標
優れたローカルAIスタックは以下を同時に達成する必要があります:
- プライバシーファースト:データがマシンまたは内部ネットワークの外に出ない
- 予測可能なレイテンシ:SLOに従った安定したレスポンス
- 交換可能なコンポーネント:アプリを壊さずにモデルやベクトルDBを交換できる
- テスト可能な動作:Evalスイートとリグレッションテスト付き
簡単な説明:
- プライバシーファースト:内部チケット、運用文書、ログなどの機密データが外部サービスに送信されない。
- 予測可能なレイテンシ:プロダクトチームには一貫した体験が必要で、ランダムに速かったり遅かったりしない。
- 交換可能なコンポーネント:今日はGemma 4を使い、明日はモデルを変更してもAPIは同じまま。
- テスト可能な動作:プロンプトやモデルを変更するたびに、データで品質が上がったか下がったかを知る必要がある。
2. ローカルAIに投資する価値がある場合
すべてのプロジェクトがすぐにローカルAIを必要とするわけではありません。投資すべきサイン:
- 機密性の高い内部データを扱い、クラウドに送りたくない。
- チームがプロンプト、モデル、ポリシーを完全にコントロールしたい。
- ユースケースが高度に反復的(コードレビュー、チケットトリアージ、ランブックサマリー)。
- APIプロバイダーへの依存を減らすために運用コストをトレードオフする意思がある。
これらのニーズがまだない場合は、まずクラウドAPIでスピードを出し、段階的にローカルに移行しましょう。
2. 必要な4つの層
クライアント層(Web/VS Code/CLI)
アプリケーション層(APIゲートウェイ、ポリシー、トレーシング)
モデル層(Ollama + Gemma 4)
ナレッジ層(ドキュメント、エンベディング、ベクトルDB)
各層には明確なコントラクトがあり、プロダクトチームとAIプラットフォームチーム間の結合度を下げます。
各層の詳細な役割:
2.1 クライアント層
ユーザーがインタラクションする場所:
- 内部Webチャット
- VS Code拡張機能
- 運用エンジニア向けCLI
原則:クライアントはモデルの詳細を知るべきではない。クライアントは統一APIコントラクトのみを呼び出す。
2.2 アプリケーション層
LLMを「プロダクション化」するための最も重要な層:
- APIゲートウェイ
- 認証とレート制限
- モデルルーティング
- プロンプトテンプレート管理
- ロギングとトレーシング
この層がないと、クライアント数が増えるにつれて品質管理が非常に困難になります。
2.3 モデル層
実際の推論が実行される場所:
- Ollamaランタイム
- Gemma 4とフォールバックモデル
この層は一つのことをうまく行うことに集中すべき:標準化されたプロンプトを受け取り、高速かつ確実に出力を返す。
2.4 ナレッジ層
RAGのためのデータ層:
- ソースドキュメント
- エンベディングインデックス
- ベクトルデータベース
- データのメタデータとバージョニング
ナレッジ層は、アドホックなドキュメントフォルダではなく、データプロダクトとして管理すべきです。
3. 層間の境界原則
これが長期的なスケーラビリティを決定します:
- クライアントはモデルランタイムを直接呼び出さない。
- モデル層はユーザーUI/セッションに直接アクセスしない。
- 検索はポリシーとロギングを維持するためにアプリケーション層のみを通る。
- プロンプトテンプレートはサービスに分散せず、一元的にバージョン管理される。
この考え方により、ドミノ効果を発生させずに個々のコンポーネントを変更できます。
3. 標準タスクフロー
- チャットフロー:ユーザープロンプト -> APIゲートウェイ -> LLM -> レスポンス
- RAGフロー:プロンプト -> リトリーバー -> コンテキストビルダー -> LLM -> 引用付き回答
- バッチフロー:ドキュメント取り込み -> チャンク -> エンベッド -> インデックスupsert
ヒント:常にrequest_idを付けて、すべてのフローをトレースできるようにする。
実際のユースケースで拡張:
3.1 チャットフロー
ユースケース:PMがタスク内の30件のコメントを要約したい。
- クライアントがゲートウェイにプロンプトを送信。
- ゲートウェイが「要約」プロンプトコントラクトを適用。
- ゲートウェイがレイテンシ最適化のために軽量モデルを選択。
- LLMが応答。
- ゲートウェイがレイテンシとrequest_id付きでレスポンスを返す。
3.2 RAGフロー
ユースケース:開発者が「内部PostgreSQLのPITRはどう設定する?」と質問。
- ゲートウェイが質問を受信。
- リトリーバーがナレッジ層から関連チャンクを取得。
- コンテキストビルダーが最適なセグメントを結合。
- LLMが引用付きの回答を生成。
- ゲートウェイがレスポンス+ソースリストを返す。
3.3 バッチフロー
ユースケース:ドキュメントチームが20件の新しいドキュメントを更新。
- インジェストジョブがスケジュール実行。
- 変更されたドキュメントのチャンキング+エンベディング。
- ステージングインデックスにupsert。
- アクティブインデックスにプロモーションする前にクイックEvalを実行。
良好なバッチフローは、「RAGが古いドキュメントから回答する」リスクを大幅に削減します。
4. APIコントラクト設計
最低限、3つのエンドポイントが必要です:
POST /chat:ドキュメント検索なしの会話タスクPOST /rag:ナレッジベースに対するQ&AタスクPOST /eval/run:ベンチマークまたはリグレッションセットの実行
レスポンスに含めるべき項目:
answermodellatency_mscitations(RAGの場合)request_id
推奨レスポンス例:
{
  "request_id": "req_20260403_001",
  "model": "gemma4",
  "answer": "PITRを設定する前にWALアーカイブを有効にする必要があります...",
  "citations": [
    {"doc_id": "pg-backup-v2", "section": "3. PITR"}
  ],
  "latency_ms": 1820,
  "degraded_mode": false
}
良いAPIは結果だけでなく、運用とデバッグのためのデータも返します。
5. プロンプトコントラクトルール
各ユースケースには、汎用プロンプト1つではなく、それぞれ専用のプロンプトコントラクトが必要です:
- コーディングアシスタントコントラクト
- 要約コントラクト
- 抽出コントラクト
- 引用付きQnAコントラクト
各コントラクトで指定すべき事項:
- 出力目標
- 出力フォーマット
- データ不足時のフォールバック条件
- 禁止事項(コンテキストを超えた推論の禁止)
コントラクトが明確に分離されていれば、テストとロールバックがはるかに容易になります。
5. モデルルーティングルール
すべてに1つのモデルを使うべきではありません。
- ライト:短い要約、分類
- ミディアム:コーディング支援、プランニング
- ヘビー:長い分析、マルチドキュメント統合
クライアントにモデルをハードコードしないよう、API層でルーターを設計します。
追加の実践的な戦略:
- プロンプトが短くRAGが不要な場合:軽量モデルにルーティング
- プロンプトに引用が必要な場合:RAGパイプライン+ミディアムモデルにルーティング
- プロンプトが長いまたはマルチステップの場合:より高いタイムアウトでヘビーモデルにルーティング
重要なのは、ルーティングが各開発者の判断ではなく、ポリシーベースであること。
6. 最低限のロギングとオブザーバビリティ
本番まで待たずに、最初から最低限ログに記録すべき項目:
- request_id
- endpoint
- selected_model
- latency_ms
- token_estimate
- retrieval_hit_count(RAGの場合)
- fallback_triggered
エラーが発生した時、モデル、検索、またはプロンプトのどれが原因かがわかります。
7. 内部ローカルAIの基本セキュリティ
ローカルで実行していても、セキュリティ原則は適用されます:
- モデルエンドポイントをネットワーク全体に公開しない。
- ゲートウェイにAPIキーまたは内部認証を設置する。
- 機密データを含む生のプロンプトをログに記録しない。
- チャット履歴の保持ポリシーを設ける。
ローカルだからといって自動的に安全というわけではありません。
6. 避けるべきアンチパターン
- クライアントがゲートウェイをバイパスしてOllamaを直接呼び出す。
- 検索ロジックをUIに混在させる。
- プロンプト/テンプレートのバージョン管理をしない。
- モデルとレイテンシに関するメタデータを保存しない。
- リグレッションテストなしでプロンプトを変更する。
さらに2つの一般的なアンチパターン:
- 標準化されたパイプラインなしで手動でドキュメントを取り込む。
- すべての環境(dev/staging/prod)に単一のインデックスを使用する。
これら2つのミスは、データと動作が混在するため、検出が困難なインシデントを引き起こすことがよくあります。
7. 即座に実行すべきチェックリスト
- 各層にオーナーが付いた4層ダイアグラムがある
- チーム全体で共有されたAPIコントラクトがある
- モデルルーティングポリシーがある
- 統一されたロギングスキーマがある
- 初期のEvalロードマップがある
最初の30日間の上級チェックリスト:
- 主要3ユースケースのプロンプトコントラクトがある
- リグレッション用のゴールデンセット(最低20テストケース)がある
- p50/p95のレイテンシダッシュボードがある
- タイムアウト時のフォールバックモデル手順がある
- ゼロダウンタイムインデックス更新プロセスがある
8. 30日間のデプロイロードマップ
第1週
- 4層アーキテクチャを確定
- APIゲートウェイと基本チャットエンドポイントを構築
- ロギングスキーマを標準化
第2週
- 最初のRAGパイプラインをデプロイ
- メタデータとチャンキングポリシーを標準化
- Eval質問セットの構築を開始
第3週
- モデルルーティングとフォールバックを追加
- ユースケース別のレイテンシ最適化
- 品質モニタリングダッシュボードを追加
第4週
- 定期的なリグレッションテストを実施
- 内部セキュリティをレビュー
- インシデント対応ランブックを作成
このロードマップは、初日にすべてを行おうとするよりも現実的です。
9. ハンズオン演習
- チームの現在のローカルAIアーキテクチャを4層モデルで再描画する。
- chatとragの2つのエンドポイントのAPIコントラクトを定義する。
- 主要3ユースケースをリストアップし、それぞれのモデルルーティングポリシーを選択する。
- 最低7フィールドのロギングスキーマを設計する。
- 最も重要なユースケースの最初の10個のゴールデンテストを書く。
デモコード
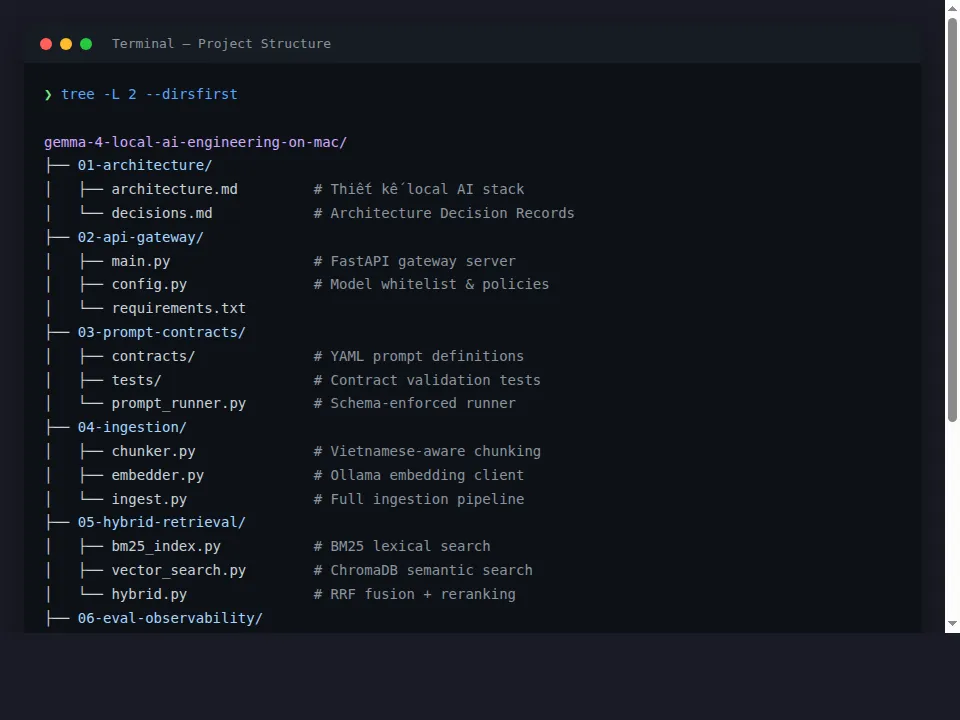
このシリーズの全デモソースコードはGitHubリポジトリにまとめられています:
レッスン別に整理されたプロジェクト構成:
まとめ
最初から設計を正しく行うことで、ローカルAIスタックが長期的に生き残り、効果的にスケールし、後からミスを修正するコストを大幅に削減できます。層を明確に分離し、APIコントラクトを標準化し、プロンプトをコードとして管理し、データで品質を測定すれば、ローカルAIはデモではなく、チームの本物のエンジニアリング能力になります。