Giới thiệu
Trước khi cài công cụ, team nên thống nhất kiến trúc. Nếu không, local AI stack sẽ rất nhanh biến thành tập hợp script rời rạc, mỗi người chạy một kiểu, kết quả trả về không nhất quán, và khi lỗi xảy ra thì không biết sửa ở đâu trước.
Bài này đi từ nền tảng đến thực chiến theo hướng dễ áp dụng:
- Vì sao local AI cần kiến trúc ngay từ đầu
- Mô hình 4 lớp nên dùng cho team dev
- Thiết kế API contract để frontend, backend, data team làm việc độc lập
- Cách định tuyến model theo loại tác vụ
- Các anti-pattern khiến dự án local AI chết sớm
- Checklist triển khai 30 ngày đầu
Sau bài này, bạn sẽ có bản vẽ đủ rõ để bắt đầu triển khai mà không phải đoán.
1. Mục tiêu kiến trúc
Một local AI stack tốt cần đạt đồng thời:
- Privacy-first: dữ liệu không rời khỏi máy hoặc mạng nội bộ
- Predictable latency: phản hồi ổn định theo SLO
- Replaceable components: đổi model hoặc vector DB mà không phá app
- Testable behavior: có bộ eval và regression test
Giải thích ngắn gọn:
- Privacy-first: dữ liệu nhạy cảm như ticket nội bộ, tài liệu vận hành, logs không bị gửi ra dịch vụ bên ngoài.
- Predictable latency: team sản phẩm cần trải nghiệm ổn định, không phải lúc nhanh lúc chậm vô lý.
- Replaceable components: hôm nay dùng Gemma 4, mai có thể chuyển model khác nhưng API vẫn giữ nguyên.
- Testable behavior: mỗi lần đổi prompt hoặc model phải biết chất lượng tăng hay giảm bằng số liệu.
2. Khi nào local AI đáng đầu tư?
Không phải dự án nào cũng cần local AI ngay. Dấu hiệu nên đầu tư:
- Bạn xử lý dữ liệu nội bộ nhạy cảm và không muốn gửi lên cloud.
- Team muốn kiểm soát đầy đủ prompt, model, policy.
- Use case lặp lại nhiều (code review, triage ticket, tóm tắt runbook).
- Bạn chấp nhận đổi lấy công vận hành để giảm phụ thuộc nhà cung cấp API.
Nếu chưa có nhu cầu trên, có thể bắt đầu từ API cloud cho nhanh rồi mới chuyển dần sang local.
2. Bốn lớp bắt buộc
Client Layer (Web/VS Code/CLI)
Application Layer (API gateway, policy, tracing)
Model Layer (Ollama + Gemma 4)
Knowledge Layer (docs, embeddings, vector DB)
Mỗi lớp có hợp đồng rõ ràng giúp giảm coupling giữa đội sản phẩm và đội AI platform.
Chi tiết vai trò từng lớp:
2.1 Client Layer
Đây là nơi user tương tác:
- Web chat nội bộ
- VS Code extension
- CLI cho kỹ sư vận hành
Nguyên tắc: client không nên biết chi tiết model. Client chỉ gọi API hợp đồng chung.
2.2 Application Layer
Lớp quan trọng nhất để "sản phẩm hóa" LLM:
- API gateway
- Auth và rate limit
- Model routing
- Prompt template management
- Logging và tracing
Nếu không có lớp này, hệ thống rất khó kiểm soát chất lượng khi số lượng client tăng.
2.3 Model Layer
Nơi chạy inference thực tế:
- Ollama runtime
- Gemma 4 và các model fallback
Lớp này chỉ nên tập trung làm tốt một việc: nhận prompt đã chuẩn hóa và trả output nhanh, ổn định.
2.4 Knowledge Layer
Lớp dữ liệu cho RAG:
- Tài liệu nguồn
- Embedding index
- Vector database
- Metadata và phiên bản dữ liệu
Lớp tri thức nên được quản lý như data product, không phải thư mục tài liệu tự phát.
3. Nguyên tắc ranh giới giữa các lớp
Đây là phần quyết định khả năng mở rộng dài hạn:
- Client không gọi thẳng model runtime.
- Model layer không truy cập trực tiếp UI/session của người dùng.
- Retrieval chỉ đi qua application layer để bảo toàn policy và logging.
- Prompt templates được version hóa tập trung, không copy rải rác mỗi service.
Tư duy này giúp thay đổi từng thành phần mà không tạo hiệu ứng domino.
3. Luồng tác vụ tiêu chuẩn
- Chat flow: user prompt -> API gateway -> LLM -> response
- RAG flow: prompt -> retriever -> context builder -> LLM -> cited answer
- Batch flow: ingest docs -> chunk -> embed -> upsert index
Gợi ý: luôn gắn request_id để trace xuyên suốt các flow.
Mở rộng theo ví dụ thực tế:
3.1 Chat flow
Use case: PM muốn tóm tắt 30 comment trong task.
- Client gửi prompt lên gateway.
- Gateway áp prompt contract cho "summarization".
- Gateway chọn model nhẹ để tối ưu latency.
- LLM trả lời.
- Gateway trả response kèm latency và request_id.
3.2 RAG flow
Use case: Dev hỏi "PITR cho PostgreSQL nội bộ đang cấu hình ra sao?"
- Gateway nhận câu hỏi.
- Retriever lấy các chunk liên quan trong knowledge layer.
- Context builder hợp nhất các đoạn tốt nhất.
- LLM sinh câu trả lời có citation.
- Gateway trả response + danh sách nguồn.
3.3 Batch flow
Use case: Team docs cập nhật 20 tài liệu mới.
- Job ingestion chạy theo lịch.
- Chunking + embedding cho tài liệu thay đổi.
- Upsert vào index staging.
- Chạy eval nhanh trước khi promote sang active index.
Flow batch tốt sẽ giảm mạnh rủi ro "RAG trả theo tài liệu cũ".
4. Thiết kế API contract
Tối thiểu nên có 3 endpoint:
POST /chat: tác vụ hội thoại không cần truy hồi tài liệuPOST /rag: tác vụ hỏi đáp trên knowledge basePOST /eval/run: chạy benchmark hoặc regression set
Response cần có:
answermodellatency_mscitations(nếu RAG)request_id
Ví dụ response gợi ý:
{
  "request_id": "req_20260403_001",
  "model": "gemma4",
  "answer": "Bạn cần bật WAL archiving trước khi cấu hình PITR...",
  "citations": [
    {"doc_id": "pg-backup-v2", "section": "3. PITR"}
  ],
  "latency_ms": 1820,
  "degraded_mode": false
}
Một API tốt không chỉ trả kết quả, mà còn trả dữ liệu để vận hành và debug.
5. Quy tắc đặt prompt contracts
Mỗi use case nên có prompt contract riêng thay vì một prompt chung cho tất cả:
- Coding assistant contract
- Summarization contract
- Extraction contract
- QnA with citation contract
Mỗi contract cần chỉ rõ:
- Mục tiêu đầu ra
- Định dạng đầu ra
- Điều kiện fallback khi thiếu dữ liệu
- Điều cấm (không suy diễn ngoài context)
Khi tách contract rõ, bạn sẽ dễ test và rollback hơn nhiều.
5. Quy tắc model routing
Không nên dùng một model cho mọi việc.
- Nhẹ: tóm tắt ngắn, classification
- Trung bình: coding assistance, planning
- Nặng: phân tích dài, tổng hợp đa tài liệu
Thiết kế router ở API layer để tránh hard-code model trong client.
Thêm một chiến lược practical:
- Nếu prompt dưới ngưỡng độ dài và không cần RAG: route model nhẹ
- Nếu prompt cần citation: route pipeline RAG + model trung bình
- Nếu prompt dài hoặc đa bước: route model nặng, timeout cao hơn
Điều quan trọng là routing dựa trên chính sách, không dựa vào cảm tính từng dev.
6. Logging và observability tối thiểu
Đừng đợi đến production mới thêm log. Ngay từ đầu, log tối thiểu:
- request_id
- endpoint
- selected_model
- latency_ms
- token_estimate
- retrieval_hit_count (nếu RAG)
- fallback_triggered
Khi có lỗi, bạn sẽ biết lỗi do model, do retrieval hay do prompt.
7. Bảo mật cơ bản cho local AI nội bộ
Ngay cả khi chạy local, vẫn cần nguyên tắc bảo mật:
- Không để endpoint model mở cho toàn mạng.
- Có API key hoặc auth nội bộ ở gateway.
- Không log nguyên văn prompt chứa dữ liệu nhạy cảm.
- Có quy tắc retention cho chat history.
Local không có nghĩa là tự động an toàn.
6. Các anti-pattern cần tránh
- Client gọi thẳng Ollama, bỏ qua gateway.
- Trộn logic retrieval vào UI.
- Không version prompt/template.
- Không lưu metadata về model và latency.
- Đổi prompt không có regression test.
Thêm hai anti-pattern phổ biến khác:
- Ingest tài liệu thủ công, không có pipeline chuẩn.
- Dùng một index duy nhất cho mọi môi trường (dev/staging/prod).
Hai lỗi này thường gây incident khó phát hiện vì dữ liệu và hành vi trộn lẫn.
7. Checklist áp dụng ngay
- Có sơ đồ 4 lớp và owner cho từng lớp
- Có API contract chung cho cả team
- Có model routing policy
- Có logging schema thống nhất
- Có roadmap cho eval từ sớm
Checklist nâng cao cho 30 ngày đầu:
- Có prompt contract cho ít nhất 3 use case chính
- Có golden set tối thiểu 20 câu để regression test
- Có dashboard latency p50/p95
- Có quy trình fallback model khi timeout
- Có quy trình update index không downtime
8. Lộ trình triển khai 30 ngày
Tuần 1
- Chốt kiến trúc 4 lớp
- Dựng API gateway và endpoint chat cơ bản
- Chuẩn hóa logging schema
Tuần 2
- Triển khai RAG pipeline đầu tiên
- Chuẩn hóa metadata và chunking policy
- Bắt đầu bộ câu hỏi eval
Tuần 3
- Thêm model routing và fallback
- Tối ưu latency theo use case
- Thêm dashboard theo dõi chất lượng
Tuần 4
- Chạy regression định kỳ
- Kiểm tra bảo mật nội bộ
- Viết runbook xử lý incident
Lộ trình này thực tế hơn việc cố làm mọi thứ ngay ngày đầu.
9. Bài tập thực hành
- Vẽ lại kiến trúc local AI hiện tại của team theo mô hình 4 lớp.
- Định nghĩa API contract cho 2 endpoint: chat và rag.
- Liệt kê 3 use case chính và chọn chính sách model routing tương ứng.
- Thiết kế logging schema với tối thiểu 7 trường.
- Viết 10 câu golden tests đầu tiên cho use case quan trọng nhất.
Demo code
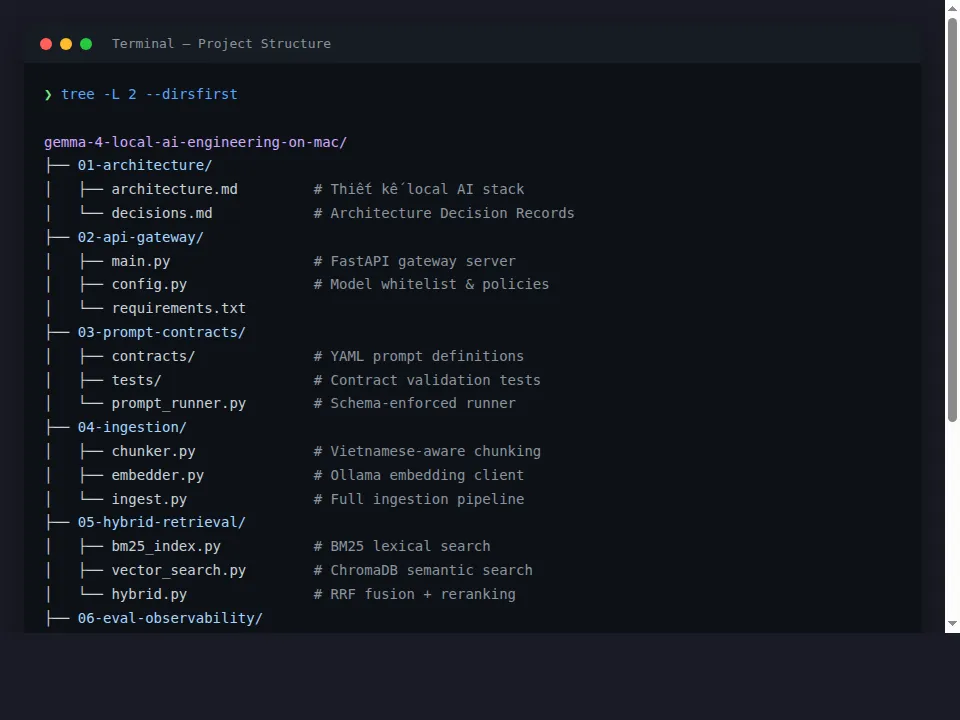
Toàn bộ source code demo cho series này được tổ chức trong repo GitHub:
Cấu trúc project theo từng bài học:
Tóm tắt
Thiết kế đúng từ đầu giúp local AI stack sống được lâu, mở rộng được, và giảm rất nhiều chi phí sửa sai về sau. Khi bạn tách lớp rõ, chuẩn hóa API contract, quản lý prompt như code, và đo chất lượng bằng số liệu, local AI không còn là demo mà trở thành năng lực kỹ thuật thật sự của team.
Bài tiếp theo chúng ta sẽ đi vào phần triển khai runtime chi tiết trên Mac với Gemma 4, Ollama và Open WebUI, kèm cấu hình theo từng mức RAM để chạy mượt ngay từ lần đầu.