前言
在安裝任何工具之前,團隊需要先達成架構共識。沒有架構的本地 AI 技術棧很快就會變成一堆零散腳本——每個人各自執行、輸出不一致、出錯時也找不到原因。
本課程從基礎到實踐,以可立即應用的方式解說:
- 為什麼本地 AI 從一開始就需要架構
- 開發團隊的四層模型
- 讓前端、後端、資料團隊獨立作業的 API Contract 設計
- 按任務類型進行模型路由
- 讓本地 AI 專案過早失敗的反模式
- 30 天部署檢查清單
完成本課程後,您將獲得一份清晰的藍圖,無需猜測即可開始部署。
1. 架構目標
優秀的本地 AI 技術棧需要同時達成以下目標:
- 隱私優先:資料不離開機器或內部網路
- 可預測延遲:符合 SLO 的穩定回應
- 可替換組件:更換模型或向量資料庫時不影響應用程式
- 可測試行為:配備 eval 套件與回歸測試
簡單說明:
- 隱私優先:內部工單、營運文件、日誌等機密資料不會傳送到外部服務。
- 可預測延遲:產品團隊需要一致的體驗,不能時快時慢。
- 可替換組件:今天用 Gemma 4,明天換模型但 API 保持不變。
- 可測試行為:每次更改 prompt 或模型時,都要能以資料驗證品質是上升還是下降。
2. 何時值得投資本地 AI
並非所有專案都立即需要本地 AI。投資的訊號:
- 處理高機密性的內部資料,不想傳送到雲端。
- 團隊想要完全掌控 prompt、模型和策略。
- 使用情境高度重複(程式碼審查、工單分類、runbook 摘要)。
- 願意以營運成本換取減少對 API 供應商的依賴。
若尚無這些需求,先用雲端 API 快速起步,再逐步遷移到本地。
2. 必要的四個層次
客戶端層(Web/VS Code/CLI)
應用層(API 閘道、策略、追蹤)
模型層(Ollama + Gemma 4)
知識層(文件、embedding、向量資料庫)
每一層都有明確的 contract,降低產品團隊與 AI 平台團隊之間的耦合度。
各層的詳細角色:
2.1 客戶端層
使用者互動的介面:
- 內部 Web 聊天
- VS Code 擴充套件
- 營運工程師的 CLI
原則:客戶端不應知道模型的細節。客戶端只呼叫統一的 API contract。
2.2 應用層
讓 LLM「生產化」的最重要層次:
- API 閘道
- 認證與速率限制
- 模型路由
- Prompt 模板管理
- 日誌與追蹤
沒有這一層,隨著客戶端數量增加,品質管控將變得極為困難。
2.3 模型層
實際推論執行的所在:
- Ollama 執行環境
- Gemma 4 與備援模型
這一層應專注於做好一件事:接收標準化的 prompt,快速且可靠地返回輸出。
2.4 知識層
RAG 的資料層:
- 來源文件
- Embedding 索引
- 向量資料庫
- 資料中繼資料與版本控制
知識層應作為資料產品管理,而非隨意的文件資料夾。
3. 層間邊界原則
這決定了長期的可擴展性:
- 客戶端不直接呼叫模型執行環境。
- 模型層不直接存取使用者 UI/session。
- 查詢只透過應用層,以維持策略與日誌。
- Prompt 模板集中版本控制,不分散在各服務中。
這種思維讓您可以更改個別組件而不產生連鎖效應。
3. 標準任務流程
- 聊天流程:使用者 prompt -> API 閘道 -> LLM -> 回應
- RAG 流程:prompt -> retriever -> context builder -> LLM -> 帶引用回答
- 批次流程:文件匯入 -> chunk -> embed -> 索引 upsert
提示:始終附帶 request_id,確保所有流程可追蹤。
以實際使用案例展開:
3.1 聊天流程
使用案例:PM 想摘要一個任務中的 30 條留言。
- 客戶端向閘道發送 prompt。
- 閘道套用「摘要」prompt contract。
- 閘道選擇輕量模型以優化延遲。
- LLM 回應。
- 閘道返回帶延遲與 request_id 的回應。
3.2 RAG 流程
使用案例:開發者問「內部 PostgreSQL 的 PITR 如何設定?」
- 閘道接收問題。
- Retriever 從知識層取得相關 chunk。
- Context builder 組合最佳片段。
- LLM 生成帶引用的回答。
- 閘道返回回應 + 來源清單。
3.3 批次流程
使用案例:文件團隊更新了 20 份新文件。
- 排程執行 ingestion job。
- 對變更的文件進行 chunking + embedding。
- Upsert 到 staging 索引。
- 在提升至 active 索引前執行快速 eval。
良好的批次流程大幅降低「RAG 從過時文件回答」的風險。
4. API Contract 設計
最少需要 3 個端點:
POST /chat:不需文件檢索的對話任務POST /rag:對知識庫的問答任務POST /eval/run:執行基準測試或回歸測試集
回應中應包含:
answermodellatency_mscitations(RAG 時)request_id
建議回應範例:
{
  "request_id": "req_20260403_001",
  "model": "gemma4",
  "answer": "設定 PITR 前需先啟用 WAL archive...",
  "citations": [
    {"doc_id": "pg-backup-v2", "section": "3. PITR"}
  ],
  "latency_ms": 1820,
  "degraded_mode": false
}
好的 API 不只返回結果,也返回營運與除錯所需的資料。
5. Prompt Contract 規則
每個使用情境應有各自的 prompt contract,而非一個萬用 prompt:
- 程式撰寫助手 contract
- 摘要 contract
- 擷取 contract
- 帶引用 QnA contract
每份 contract 應指定:
- 輸出目標
- 輸出格式
- 資料不足時的降級條件
- 禁止事項(禁止超出上下文的推論)
Contract 明確分離後,測試與回滾將容易得多。
5. 模型路由規則
不應所有任務使用同一個模型。
- 輕量:短摘要、分類
- 中量:程式撰寫輔助、規劃
- 重量:長篇分析、多文件綜合
在 API 層設計路由器,不要在客戶端硬編碼模型。
額外的實務策略:
- prompt 短且不需 RAG:路由到輕量模型
- prompt 需要引用:路由到 RAG 管線 + 中量模型
- prompt 長或多步驟:路由到重量模型並設定較長逾時
重點是路由應基於策略,而非各開發者的判斷。
6. 最低限度的日誌與可觀測性
不要等到上線才做,從一開始就至少記錄:
- request_id
- endpoint
- selected_model
- latency_ms
- token_estimate
- retrieval_hit_count(RAG 時)
- fallback_triggered
發生錯誤時,您能判斷是模型、檢索還是 prompt 造成的問題。
7. 內部本地 AI 的基本安全
即使在本地執行,安全原則依然適用:
- 不要將模型端點暴露給整個網路。
- 在閘道設置 API key 或內部認證。
- 不要記錄含機密資料的原始 prompt。
- 設定聊天記錄的保留政策。
本地不代表自動安全。
6. 應避免的反模式
- 客戶端繞過閘道直接呼叫 Ollama。
- 將檢索邏輯混入 UI。
- 不對 prompt/template 做版本控制。
- 不儲存模型與延遲的中繼資料。
- 未做回歸測試就更改 prompt。
還有兩個常見反模式:
- 沒有標準化管線就手動匯入文件。
- 所有環境(dev/staging/prod)使用單一索引。
這兩個錯誤常導致難以偵測的事件,因為資料與行為混在一起。
7. 立即執行的檢查清單
- 有四層圖表,每層都有負責人
- 有團隊共享的 API contract
- 有模型路由策略
- 有統一的日誌 schema
- 有初步的 eval 路線圖
前 30 天進階檢查清單:
- 有 3 個主要使用案例的 prompt contract
- 有回歸用 golden set(至少 20 個測試案例)
- 有 p50/p95 延遲儀表板
- 有逾時時的備援模型程序
- 有零停機索引更新流程
8. 30 天部署路線圖
第一週
- 確定四層架構
- 建構 API 閘道與基本聊天端點
- 標準化日誌 schema
第二週
- 部署第一個 RAG 管線
- 標準化中繼資料與 chunking 策略
- 開始建構 eval 問題集
第三週
- 加入模型路由與備援
- 按使用案例最佳化延遲
- 加入品質監控儀表板
第四週
- 執行定期回歸測試
- 審查內部安全性
- 建立事件回應 runbook
這份路線圖比試圖在第一天完成所有事情更務實。
9. 實作練習
- 用四層模型重新繪製團隊目前的本地 AI 架構。
- 定義 chat 與 rag 兩個端點的 API contract。
- 列出 3 個主要使用案例,為每個選擇模型路由策略。
- 設計至少 7 個欄位的日誌 schema。
- 為最重要的使用案例撰寫前 10 個 golden test。
Demo 程式碼
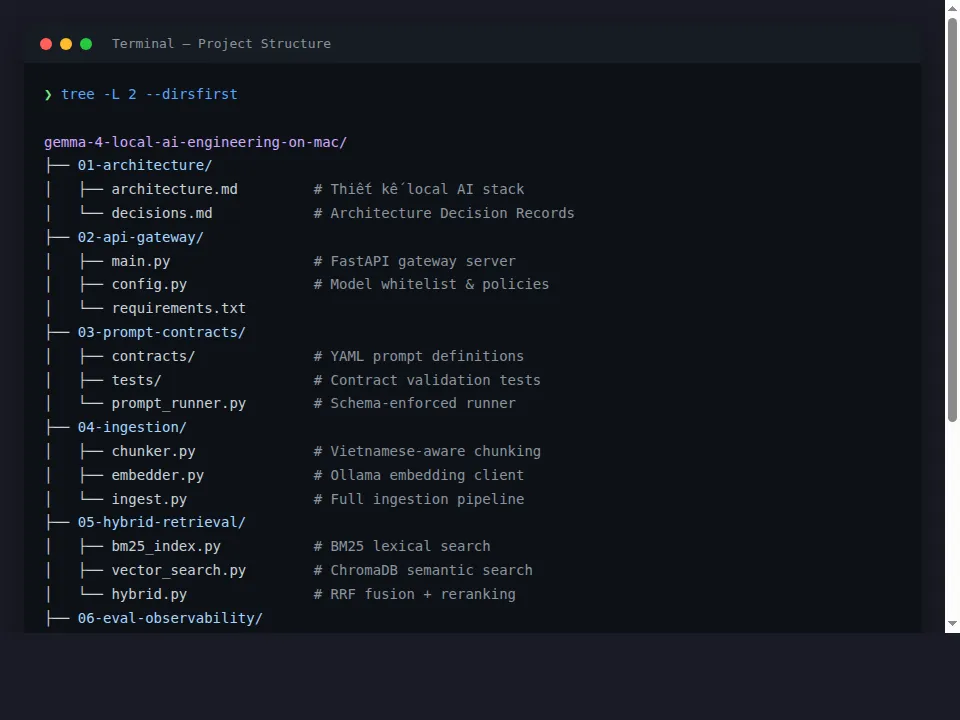
本系列所有 demo 原始碼整理於 GitHub 儲存庫:
按課程組織的專案結構:
總結
從一開始就正確設計,能讓本地 AI 技術棧長期存活、有效擴展,並大幅降低事後修正錯誤的成本。清晰分離各層、標準化 API contract、將 prompt 作為程式碼管理、以資料衡量品質——本地 AI 就不只是 demo,而是團隊真正的工程能力。