オブザーバビリティ スタック 2026 — PLG + OpenTelemetry
現代の分散システムの世界では、システムが外部に出力する内容に基づいてシステムの内部状態を理解することが、__HTMLTAG_3___Observability の中核となる定義です。 「システムは機能しているか?」という質問のみを行う従来の監視とは異なります。 — 可観測性により、「なぜシステムがそのように動作するのか?」を尋ねることができます。予期せぬ状況でも。
このレッスンでは、3 つの可観測性の柱、OpenTelemetry 標準、PLG スタックと EFK スタックの対比、統合コレクターとしての Grafana Alloy の役割を含む、2026 年に推奨される可観測性スタックの包括的な紹介を提供します。
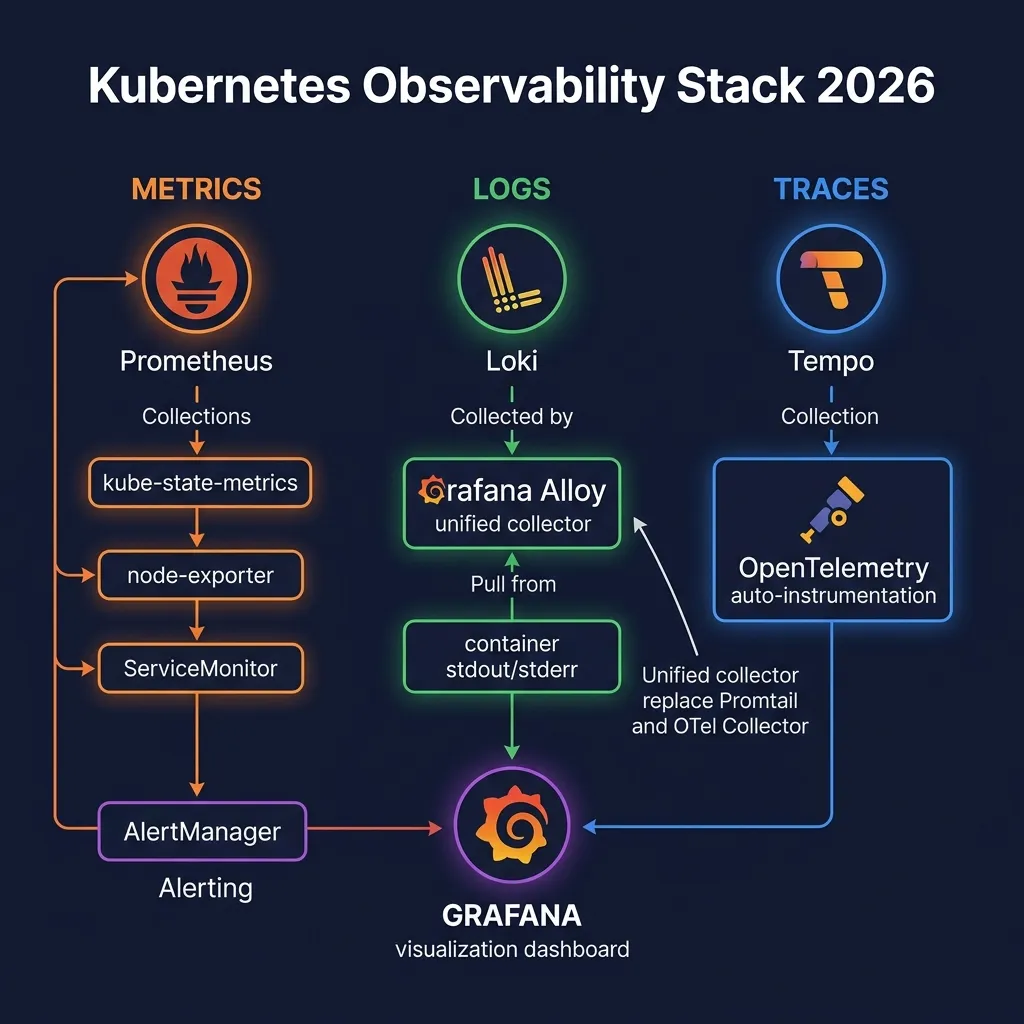
可観測性の 3 つの柱__HTMLTAG_10___
すべての可観測性システムは、3 つの基本的なタイプの信号を中心に展開します。それぞれのタイプとそれらがどのように相互に補完するかを理解することは、効果的な観察システムを構築するための基礎となります。
メトリクス — 経時的な数値データ
メトリクスは、時間をかけて測定および収集される数値です。これらにより、傾向の観察、アラートしきい値の設定、異常の検出が可能になります。例: 1 秒あたりのリクエスト数、CPU 使用率、平均レイテンシー、エラー率。
メトリクスの利点は、ストレージ コストが低いこと、クエリが高速であること、そしてアラートに非常に適していることです。ただし、指標では__HTMLTAG_18___なぜ 値が異常であるかを判断することはできません。さらに調査するにはログとトレースが必要です。
ログ — イベント ログ
ログは、アプリケーションおよびシステムによって生成されるイベント ログです。これらは、特定の時間に何が起こったのかについての最も詳細なコンテキストを提供します。通常、各ログ エントリには、タイムスタンプ、重大度レベル、メッセージ、メタデータ フィールドが含まれます。
ログは、(メトリクス アラートから) 期間と問題のあるコンポーネントを特定し、さらに詳細を理解する必要がある場合に非常に強力です。ログに関する課題は、データ量が膨大であり、ストレージ/クエリのコストが非常に高くなる可能性があることです。
トレース — トレースのリクエスト
分散トレースは、複数のサービスとコンポーネントにわたるリクエストを追跡します。各トレースは、複数の__HTMLTAG_30___spans、つまり開始および終了のタイムスタンプ、操作名、およびメタデータを含む作業単位で構成されます。トレースは、サービス間の依存関係を理解し、ボトルネックを特定し、遅延関連のエラーをデバッグするのに役立ちます。
3 つすべてが必要な理由
一般的な調査プロセスで連携する 3 つの柱:
- メトリクス アラート は、午前 2 時 30 分にエラー率が増加していることを警告します
- __HTMLTAG_43___Grafana ダッシュボードを開いて指標を表示し、サービスの支払いに問題があることに気づきました
- その間にサービスの支払いのために_Lokiログにジャンプすると、「接続が拒否されました」エラー が表示されます。
- ログ行のトレース ID をクリックし、__HTMLTAG_51___テンポ トレース にジャンプすると、リクエストがデータベース呼び出し時にタイムアウトしていることがわかります
- 結論: データベース接続プールが枯渇しました
3 つの柱のどれも単独では十分な情報を提供できません。力はそれらの組み合わせと相互関係にあります。
OpenTelemetry — 独自の標準 2026
OpenTelemetry が登場する前は、各ベンダー (Datadog、New Relic、Jaeger、Zipkin...) が独自の SDK とエージェントを持っていました。ベンダーを変更するということは、インスツルメンテーション コードを書き直すことを意味します。 OpenTelemetry (OTel) は、このベンダー ロックイン問題を解決するために生まれました。
_OpenTelemetry とは何ですか?
OpenTelemetry は CNCF 段階的プロジェクトであり、テレメトリ データ (メトリクス、ログ、トレース) を収集およびエクスポートするための業界標準です。 2019 年に OpenCensus と OpenTracing が合併して形成された OTel は、2026 年までにクラウドネイティブ エコシステムの誰もが認める標準になりました。
ベンダーに依存しないアーキテクチャ
OTel アーキテクチャでは、インストルメンテーション (データの収集方法) とエクスポート (データの送信先) が明確に分離されています。一度インストルメントを行うと、エクスポーターの設定を変更するだけで、Prometheus、Jaeger、Datadog、New Relic、またはその他のバックエンドにデータを送信できるようになります。
自動インストルメンテーション — コードを変更する必要はありません
_OTel の最も強力な機能の 1 つは、自動計測機能です。 Java、Python、Node.js、.NET などの一般的な言語を使用すると、OTel は開発者がコード行を変更することなく、自動的にインストルメンテーションを挿入できます。これは特に次の場合に役立ちます:
- インストルメンテーションのないレガシー アプリケーション__HTMLTAG_77___
- ソース コードが管理されていないサードパーティ ライブラリ
- フリート全体への迅速な展開__HTMLTAG_81___
OTLP プロトコル — 統合トランスポート
OpenTelemetry Line Protocol (OTLP) は、メトリクス、ログ、トレースを転送するための統一プロトコルです。 OTLP は、gRPC (ポート 4317) と HTTP (ポート 4318) の両方をサポートします。 3 つの信号タイプすべてに単一のプロトコルを使用することで、ネットワーク構成、ファイアウォール ルール、負荷分散が大幅に簡素化されます。
Kubernetes 用 OpenTelemetry オペレーター
OpenTelemetry Operator は、OTel Collector と自動インストルメンテーションのデプロイメントと構成を管理する Kubernetes Operator です。 2 つの主要な CRD が提供されます:
- OpenTelemetryCollector: OTel Collector インスタンスのデプロイと構成
- インストルメンテーション: ワークロードの自動インストルメンテーションを構成
コードブロック_0
インストルメンテーション CRD を適用した後、ポッドにアノテーションを追加して自動インストルメンテーションを有効にするだけです:
コードブロック_1
PLG スタックと EFK スタック
Kubernetes のログ集約と可観測性のための 2 つの最も人気のあるスタックは、PLG (Prometheus + Loki + Grafana) と EFK (Elasticsearch + Fluentd/Fluent Bit + Kibana) です。どちらを選択するかは、特定の使用例によって異なります。
PLG スタック — 軽量、安価、ラベルベース
PLG スタックは、「コンテンツではなくラベルをインデックスする」という哲学を持つクラウドネイティブ環境向けに設計されています:
- Prometheus: 時系列でメトリクスを収集および保存
- _Loki: ラベルベースのインデックス作成によるログ集計 (Prometheus に似ていますが、ログ用)
- Grafana: すべてのデータ ソースの統合視覚化
Loki はログ コンテンツにインデックスを付けない (ラベルのみ) ため、ストレージと運用のコストが Elasticsearch よりも大幅に低くなります。トレードオフとして、全文検索の機能は低下します。ただし、ほとんどのユースケース (サービス、名前空間、時間範囲、パターン マッチングによるクエリ) では、Loki が完全に適切です。
EFK スタック — 全文検索、より重い
全文検索と複雑な分析用に最適化されたEFKスタック:
- Elasticsearch: 全文インデックス付きログ ストレージ、検索に非常に強い
- Fluentd/Fluent Bit: ログ コレクターおよびプロセッサ
- Kibana: Elasticsearch の視覚化および検索 UI
Elasticsearch はログ コンテンツ全体にインデックスを付け、非常に強力な全文検索を可能にします。ただし、これにはコストがかかります。Elasticsearch は RAM と CPU を大幅に消費し、HA を確保するには最低 3 ノードのクラスタが必要で、運用コストがはるかに高くなります。
EFK を使用するのはどのような場合ですか?
_次の場合に EFK を選択します:
- ログ コンテンツの全文検索が必要です (たとえば、オプションでエラー メッセージによる検索)
- ログ データの複雑な集計と分析が必要
- チームには Elasticsearch の経験がある
- 予算は問題ではないが、Elastic のエンタープライズ機能が必要
ほとんどのチームにとって、2026 年の Kubernetes オブザーバビリティを実現するには、PLG スタックがより良い選択です。運用コストが低くなり、Prometheus エコシステムとの統合が向上し、オブジェクト ストレージのスケーラビリティが向上します。
Grafana 合金 — 統合コレクター
Grafana Alloy (2024 年から一般提供開始、Grafana Agent に代わる) は、以前のツールの多くを継承およびマージする統合テレメトリ コレクターです:
- __HTMLTAG_169___Promtail (Loki のログ コレクター) を置き換えます
- 置換 Prometheus リモート書き込みエージェント___HTMLTAG_174__HTMLTAG_175___
- 多くの使用例で__HTMLTAG_177___OTel Collectorを置き換えます
- __HTMLTAG_181___Grafana エージェント (前任者) を置き換えます
リバー DSL 構成__HTMLTAG_186___
_Alloy は、HCL (Terraform) に基づいた Grafana 独自の構成言語である River DSL を使用します。 River には、相互接続されたコンポーネントを含むパイプラインを宣言する機能があります:
コードブロック_2
エージェントからメトリクス、ログ、トレースを収集
3 ~ 4 つの個別の DaemonSet (Promtail、node-exporter、OTel Collector...) を実行する代わりに、Alloy を使用すると、それらすべてを処理する単一の DaemonSet を実行できます。これにより、
が最小限に抑えられます。- 各ノードで実行されているポッドの数
- コンテナ ランタイムのオーバーヘッド__HTMLTAG_197___
- 構成管理の複雑さ__HTMLTAG_199___
- バックエンドへのネットワーク接続
推奨スタック 2026
運用の現実とコミュニティの傾向に基づいて、2026 年に推奨される Kubernetes の可観測性スタックは次のとおりです:
メインコンポーネント
- メトリクス: Prometheus + kube-state-metrics + node-exporter
- ログ: Loki (実稼働用のオブジェクト ストレージ バックエンドを使用)
- トレース: グラファナ テンポ
- 視覚化: Grafana
- コレクター: Grafana Alloy (ノードごとの DaemonSet)
- 計測標準: OpenTelemetry
アーキテクチャ フロー_
このスタックのデータ フローは次のとおりです:
コードブロック_3
_このアーキテクチャの強みは、すべてのビジュアライゼーションが 1 つのドア、つまり Grafana を通過することです。 Grafana UI を離れることなく、メトリクス→ログ→トレースとドリルダウンでき、トレース ID または時間範囲によってデータを関連付けることができます。
kube-prometheus-stack Helm チャート
各コンポーネントを 1 つずつインストールする代わりに、__HTMLTAG_244___kube-prometheus-stack は統合されたオールインワン Helm チャートです:
- プロメテウス オペレーター
- Prometheus インスタンス
- アラートマネージャー
- グラファナ
- kube-state-metrics__HTMLTAG_257___
- ノードエクスポーター
- Kubernetes のデフォルトのダッシュボードとアラート ルール__HTMLTAG_261___
コードブロック_4
開始するための基本的なvalues.yamlファイル:
コードブロック_5
kube-prometheus-stack をインストールすると、Kubernetes クラスターの完全なメトリクスとアラートが得られます。次のステップでは、Loki (ログ) と Tempo (トレース) を追加して、可観測性スタックを完成させます。
概要
可観測性は後から追加できる機能ではありません。最初から設計する必要があります。 2026 年には、OpenTelemetry が誰もが認める標準となり、ほとんどの Kubernetes チームにとって、Grafana Alloy を使用した PLG スタックが最も現実的な選択肢となっています。
次のレッスンでは、各コンポーネントについて詳しく説明します:
- レッスン 29: Prometheus Operator、ServiceMonitor、PromQL、AlertManager
- _レッスン 30: ロキ、テンポ、相関可観測性
- レッスン 31: Kubernetes のデバッグとトラブルシューティング
- _実践 7: スタック全体をデプロイし、エンドツーエンドで実践