Observability Stack 2026 — PLG + OpenTelemetry
Trong thế giới hệ thống phân tán hiện đại, việc hiểu được trạng thái bên trong của một hệ thống dựa trên những gì nó xuất ra bên ngoài chính là định nghĩa cốt lõi của Observability. Khác với monitoring truyền thống — chỉ đặt câu hỏi "hệ thống có đang hoạt động không?" — observability cho phép bạn hỏi "tại sao hệ thống lại hoạt động như vậy?" ngay cả với những tình huống bạn chưa từng lường trước.
Bài học này sẽ giới thiệu toàn diện về Observability Stack được khuyến nghị cho năm 2026, bao gồm ba trụ cột quan sát, tiêu chuẩn OpenTelemetry, sự đối lập giữa PLG và EFK stack, và vai trò của Grafana Alloy như một unified collector.
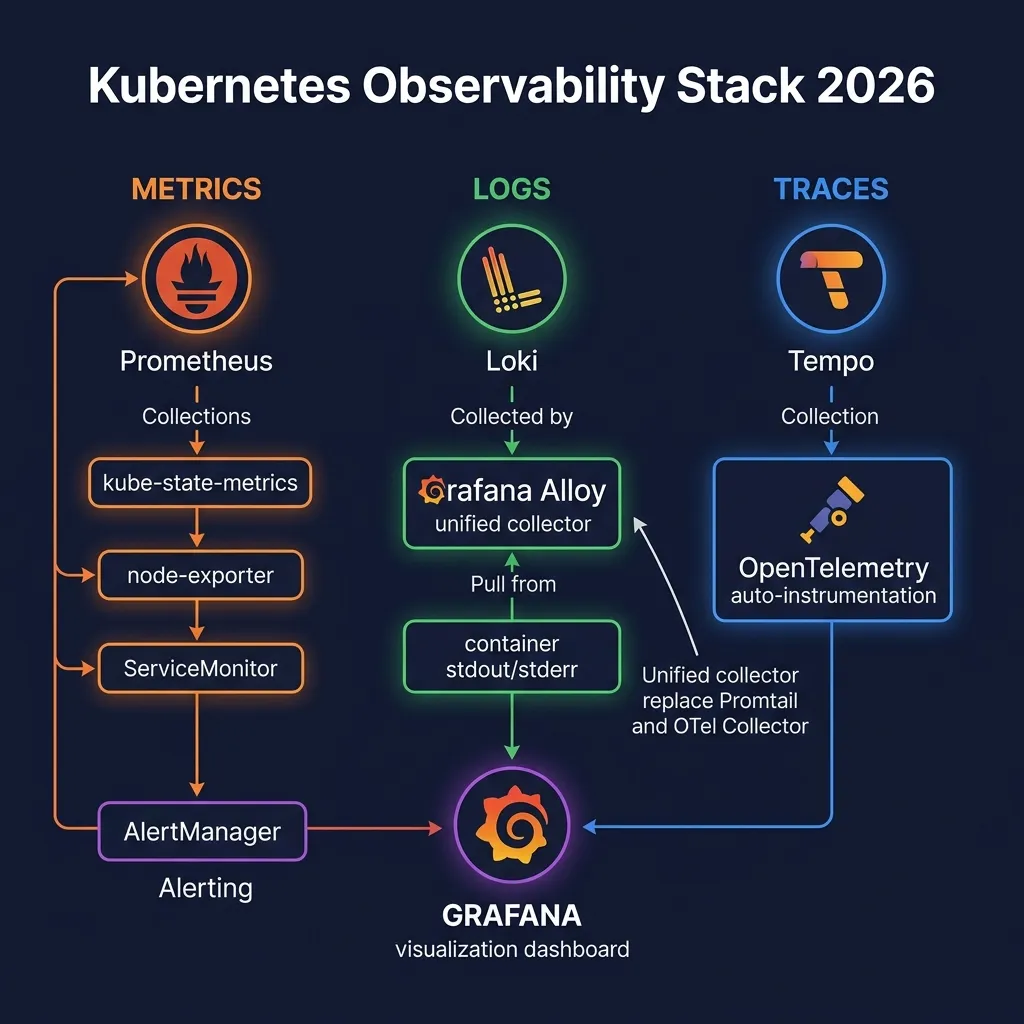
Ba Trụ Cột Của Observability
Mọi hệ thống observability đều xoay quanh ba loại tín hiệu cơ bản. Hiểu rõ từng loại và cách chúng bổ trợ cho nhau là nền tảng để xây dựng một hệ thống quan sát hiệu quả.
Metrics — Dữ Liệu Số Theo Thời Gian
Metrics là các giá trị số được đo lường và thu thập theo thời gian. Chúng cho phép bạn quan sát xu hướng, đặt ngưỡng cảnh báo, và phát hiện anomaly. Ví dụ: số lượng request mỗi giây, mức sử dụng CPU, latency trung bình, tỉ lệ lỗi.
Ưu điểm của metrics là chi phí lưu trữ thấp, query nhanh, và rất phù hợp với alerting. Tuy nhiên, metrics không thể nói cho bạn biết tại sao một giá trị lại bất thường — bạn cần logs và traces để điều tra sâu hơn.
Logs — Bản Ghi Sự Kiện
Logs là các bản ghi sự kiện được sinh ra bởi ứng dụng và hệ thống. Chúng cung cấp ngữ cảnh chi tiết nhất về những gì đã xảy ra tại một thời điểm cụ thể. Mỗi log entry thường bao gồm timestamp, severity level, message, và các trường metadata.
Logs rất mạnh khi bạn đã xác định được khoảng thời gian và component có vấn đề (từ metrics alert), và cần hiểu chi tiết hơn. Thách thức với logs là khối lượng dữ liệu khổng lồ và chi phí lưu trữ/query có thể rất cao.
Traces — Vết Đường Đi Của Request
Distributed traces theo dõi một request xuyên suốt nhiều service và component. Mỗi trace bao gồm nhiều spans — các đơn vị công việc có timestamp bắt đầu, kết thúc, tên operation, và metadata. Traces giúp bạn hiểu dependency giữa các service, xác định bottleneck, và debug các lỗi liên quan đến latency.
Tại Sao Cần Cả Ba?
Ba trụ cột hoạt động cùng nhau trong một quy trình điều tra điển hình:
- Metrics alert cảnh báo rằng error rate đang tăng cao vào lúc 2:30 AM
- Bạn mở Grafana dashboard để xem metrics và nhận ra service payment đang có vấn đề
- Bạn jump sang Loki logs cho service payment trong khoảng thời gian đó và thấy "connection refused" errors
- Bạn click vào một trace ID trong log line và nhảy sang Tempo traces để thấy rằng request đang bị timeout ở database call
- Kết luận: database connection pool bị cạn kiệt
Không có một pillar nào trong ba pillar đó có thể cung cấp đủ thông tin một mình. Sức mạnh nằm ở sự kết hợp và tương quan giữa chúng.
OpenTelemetry — Chuẩn Duy Nhất 2026
Trước OpenTelemetry, mỗi vendor (Datadog, New Relic, Jaeger, Zipkin...) đều có SDK và agent riêng. Việc thay đổi vendor đồng nghĩa với việc viết lại code instrumentation. OpenTelemetry (OTel) ra đời để giải quyết vấn đề vendor lock-in này.
OpenTelemetry Là Gì?
OpenTelemetry là một CNCF Graduated Project — tiêu chuẩn công nghiệp cho việc thu thập và xuất telemetry data (metrics, logs, traces). Được hình thành từ sự hợp nhất của OpenCensus và OpenTracing vào năm 2019, đến 2026 OTel đã trở thành tiêu chuẩn không thể bàn cãi trong cloud-native ecosystem.
Vendor-Agnostic Architecture
Kiến trúc OTel tách biệt rõ ràng giữa instrumentation (cách thu thập data) và export (gửi data đi đâu). Bạn instrumentation một lần, sau đó có thể gửi data đến Prometheus, Jaeger, Datadog, New Relic hay bất kỳ backend nào chỉ bằng cách thay đổi cấu hình exporter.
Auto-Instrumentation — Không Cần Thay Đổi Code
Một trong những tính năng mạnh mẽ nhất của OTel là khả năng auto-instrumentation. Với các ngôn ngữ phổ biến như Java, Python, Node.js, và .NET, OTel có thể tự động inject instrumentation mà không cần developer thay đổi bất kỳ dòng code nào. Điều này đặc biệt hữu ích cho:
- Legacy applications không có instrumentation
- Third-party libraries mà bạn không kiểm soát source code
- Rapid rollout instrumentation cho toàn bộ fleet
OTLP Protocol — Unified Transport
OpenTelemetry Line Protocol (OTLP) là giao thức thống nhất cho việc truyền tải metrics, logs, và traces. OTLP hỗ trợ cả gRPC (port 4317) và HTTP (port 4318). Việc có một protocol duy nhất cho tất cả ba loại signal giúp đơn giản hóa đáng kể việc cấu hình network, firewall rules, và load balancing.
OpenTelemetry Operator cho Kubernetes
OpenTelemetry Operator là một Kubernetes Operator quản lý việc deploy và cấu hình OTel Collectors và auto-instrumentation. Nó cung cấp hai CRDs chính:
- OpenTelemetryCollector: deploy và configure OTel Collector instances
- Instrumentation: configure auto-instrumentation cho các workloads
apiVersion: opentelemetry.io/v1alpha1
kind: Instrumentation
metadata:
  name: my-instrumentation
spec:
  exporter:
    endpoint: http://otel-collector:4317
  propagators:
    - tracecontext
    - baggage
  sampler:
    type: parentbased_traceidratio
    argument: "0.1"
  java:
    image: ghcr.io/open-telemetry/opentelemetry-operator/autoinstrumentation-java:latest
  nodejs:
    image: ghcr.io/open-telemetry/opentelemetry-operator/autoinstrumentation-nodejs:latest
  python:
    image: ghcr.io/open-telemetry/opentelemetry-operator/autoinstrumentation-python:latest
Sau khi apply Instrumentation CRD, bạn chỉ cần thêm annotation vào Pod để kích hoạt auto-instrumentation:
annotations:
  instrumentation.opentelemetry.io/inject-java: "true"
PLG Stack vs EFK Stack
Hai stack phổ biến nhất cho log aggregation và observability trong Kubernetes là PLG (Prometheus + Loki + Grafana) và EFK (Elasticsearch + Fluentd/Fluent Bit + Kibana). Lựa chọn giữa chúng phụ thuộc vào use case cụ thể.
PLG Stack — Nhẹ, Cheap, Label-Based
PLG stack được thiết kế cho cloud-native environments với triết lý "index labels, not content":
- Prometheus: thu thập và lưu trữ metrics dạng time series
- Loki: log aggregation với label-based indexing (giống Prometheus nhưng cho logs)
- Grafana: unified visualization cho tất cả data sources
Loki không index nội dung log (chỉ index labels), điều này giúp chi phí lưu trữ và vận hành thấp hơn đáng kể so với Elasticsearch. Tradeoff là full-text search kém mạnh hơn. Nhưng với hầu hết use cases — query theo service, namespace, time range, pattern matching — Loki hoàn toàn đủ dùng.
EFK Stack — Full-Text Search, Nặng Hơn
EFK stack được tối ưu cho full-text search và analytics phức tạp:
- Elasticsearch: full-text indexed log storage, rất mạnh về search
- Fluentd/Fluent Bit: log collector và processor
- Kibana: visualization và search UI cho Elasticsearch
Elasticsearch index toàn bộ nội dung log, cho phép full-text search cực kỳ mạnh mẽ. Tuy nhiên, điều này đi kèm với chi phí: Elasticsearch tiêu thụ nhiều RAM và CPU hơn đáng kể, yêu cầu cluster minimum 3 nodes để đảm bảo HA, và chi phí vận hành cao hơn nhiều.
Khi Nào Dùng EFK?
Chọn EFK khi:
- Cần full-text search trong log content (ví dụ: search theo error message tùy ý)
- Cần complex aggregations và analytics trên log data
- Team đã có kinh nghiệm với Elasticsearch
- Budget không phải vấn đề và cần enterprise features của Elastic
Với phần lớn các team, PLG stack là lựa chọn tốt hơn cho Kubernetes observability vào 2026. Chi phí vận hành thấp hơn, tích hợp tốt hơn với Prometheus ecosystem, và khả năng scale tốt hơn trên object storage.
Grafana Alloy — Unified Collector
Grafana Alloy (GA từ 2024, thay thế Grafana Agent) là unified telemetry collector kế thừa và hợp nhất nhiều tools trước đó:
- Thay thế Promtail (log collector cho Loki)
- Thay thế Prometheus remote_write agent
- Thay thế OTel Collector cho nhiều use cases
- Thay thế Grafana Agent (predecessor)
River DSL Configuration
Alloy sử dụng River DSL — một configuration language riêng của Grafana, dựa trên HCL (Terraform). River có khả năng khai báo pipelines với components kết nối với nhau:
// Collect logs từ Kubernetes pods
loki.source.kubernetes "pods" {
  targets    = discovery.kubernetes.pods.targets
  forward_to = [loki.write.local.receiver]
}

// Discover Kubernetes pods
discovery.kubernetes "pods" {
  role = "pod"
}

// Write logs to Loki
loki.write "local" {
  endpoint {
    url = "http://loki:3100/loki/api/v1/push"
  }
}

// Collect metrics via Prometheus scrape
prometheus.scrape "default" {
  targets    = prometheus.operator.servicemonitors.targets
  forward_to = [prometheus.remote_write.mimir.receiver]
}

// Forward metrics to Prometheus/Mimir
prometheus.remote_write "mimir" {
  endpoint {
    url = "http://mimir:9009/api/v1/push"
  }
}
Thu Thập Metrics, Logs, Traces Từ Một Agent
Thay vì chạy 3-4 DaemonSets riêng biệt (Promtail, node-exporter, OTel Collector...), Alloy cho phép chạy một DaemonSet duy nhất đảm nhiệm tất cả. Điều này giảm thiểu:
- Số lượng Pods chạy trên mỗi node
- Overhead của container runtime
- Complexity của configuration management
- Network connections đến backends
Stack Khuyến Nghị 2026
Dựa trên thực tế vận hành và xu hướng cộng đồng, đây là observability stack khuyến nghị cho Kubernetes vào năm 2026:
Components Chính
- Metrics: Prometheus + kube-state-metrics + node-exporter
- Logs: Loki (với object storage backend cho production)
- Traces: Grafana Tempo
- Visualization: Grafana
- Collector: Grafana Alloy (DaemonSet trên mỗi node)
- Instrumentation Standard: OpenTelemetry
Architecture Flow
Luồng dữ liệu trong stack này như sau:
# Layer 1: Data Sources
[Application Pods]  →  OTel SDK / auto-instrumentation
[Kubernetes API]    →  kube-state-metrics
[Node OS]          →  node-exporter

# Layer 2: Collection
[Grafana Alloy DaemonSet] ← scrape metrics, collect logs, receive traces via OTLP

# Layer 3: Storage Backends
[Alloy] → [Prometheus]   (metrics, 15 days retention)
[Alloy] → [Loki]         (logs, with S3 backend)
[Alloy] → [Tempo]        (traces, with S3 backend)

# Layer 4: Visualization
[Prometheus] → [Grafana]
[Loki]       → [Grafana]
[Tempo]      → [Grafana]
Điểm mạnh của kiến trúc này là tất cả visualization đều qua một cửa: Grafana. Bạn có thể drill down từ metrics → logs → traces mà không cần rời khỏi Grafana UI, và có thể correlate data theo trace ID hoặc time range.
kube-prometheus-stack Helm Chart
Thay vì cài từng component một, kube-prometheus-stack là Helm chart all-in-one tích hợp:
- Prometheus Operator
- Prometheus instances
- AlertManager
- Grafana
- kube-state-metrics
- node-exporter
- Default dashboards và alert rules cho Kubernetes
# Add Helm repository
helm repo add prometheus-community https://prometheus-community.github.io/helm-charts
helm repo update

# Install kube-prometheus-stack
helm install kube-prometheus-stack prometheus-community/kube-prometheus-stack \
  --namespace monitoring \
  --create-namespace \
  --values values.yaml
File values.yaml cơ bản để bắt đầu:
grafana:
  adminPassword: "your-secure-password"
  persistence:
    enabled: true
    size: 10Gi
  ingress:
    enabled: true
    hosts:
      - grafana.example.com

prometheus:
  prometheusSpec:
    retention: 15d
    storageSpec:
      volumeClaimTemplate:
        spec:
          storageClassName: standard
          accessModes: ["ReadWriteOnce"]
          resources:
            requests:
              storage: 50Gi

alertmanager:
  alertmanagerSpec:
    storage:
      volumeClaimTemplate:
        spec:
          storageClassName: standard
          resources:
            requests:
              storage: 5Gi
Sau khi cài kube-prometheus-stack, bạn đã có đầy đủ metrics và alerting cho Kubernetes cluster. Bước tiếp theo là thêm Loki (logs) và Tempo (traces) để hoàn thiện observability stack.
Tổng Kết
Observability không phải là một tính năng có thể thêm vào sau — nó cần được thiết kế từ đầu. Năm 2026, OpenTelemetry đã trở thành chuẩn không thể bàn cãi, và PLG stack với Grafana Alloy là lựa chọn thực tế nhất cho hầu hết các team Kubernetes.
Trong các bài học tiếp theo, chúng ta sẽ đi sâu vào từng component:
- Bài 29: Prometheus Operator, ServiceMonitor, PromQL, AlertManager
- Bài 30: Loki, Tempo, và correlated observability
- Bài 31: Debugging và troubleshooting Kubernetes
- Thực hành 7: Deploy toàn bộ stack và thực hành end-to-end