可觀測性堆疊 2026 — PLG + OpenTelemetry
在分散式系統的現代世界中,根據系統輸出到外部的內容來了解系統的內部狀態是 可觀察性 的核心定義。與傳統監控不同,傳統監控僅詢問「系統是否正常運作?」的問題。 ——可觀察性讓你可以問「為什麼系統會這樣做?」即使是在您從未預料到的情況下。
本課程將全面介紹 2026 年推薦的可觀測性堆疊,包括三大可觀測性支柱、OpenTelemetry 標準、PLG 和 EFK 堆疊之間的對比以及 Grafana Alloy 作為統一收集器的角色。
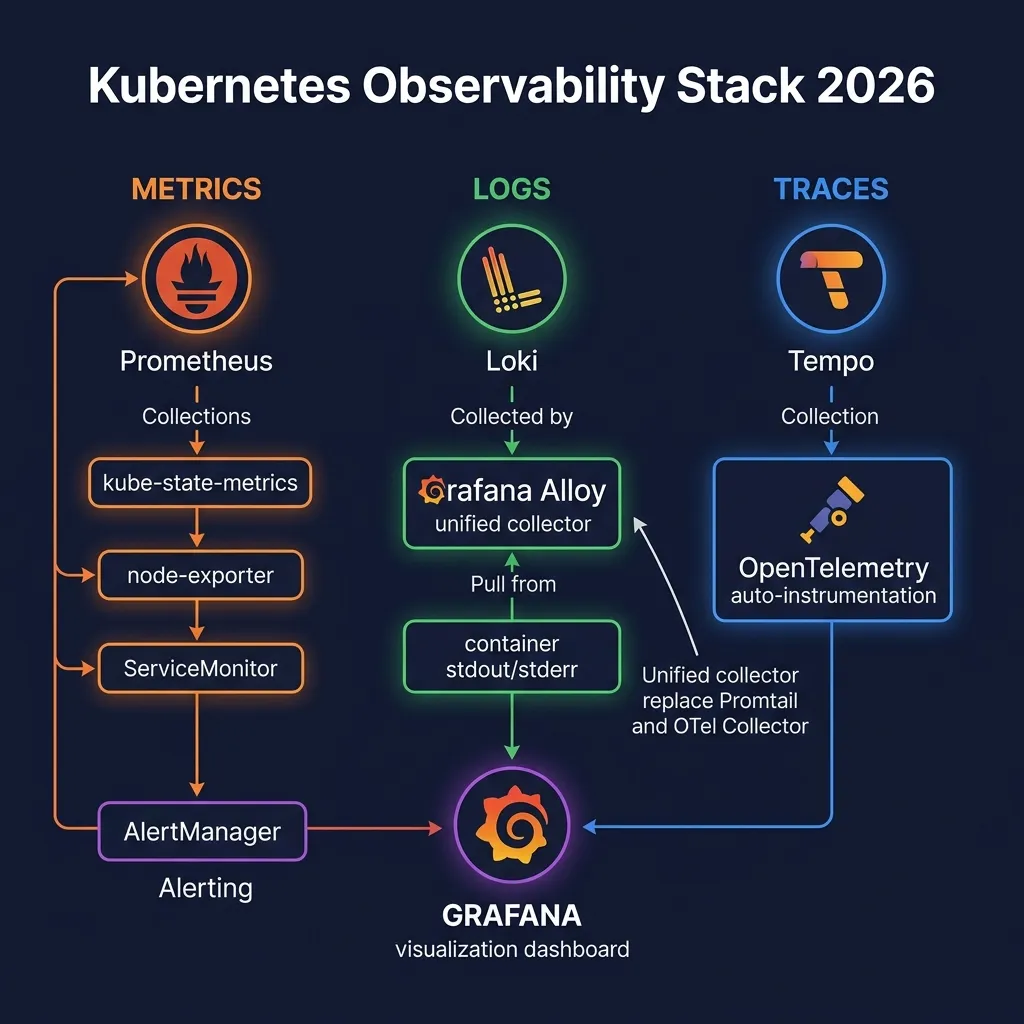
可觀察性的三大支柱__HTMLTAG_10___
每個可觀測系統都圍繞著三種基本類型的訊號。了解每種類型以及它們如何相互補充是建立有效觀察系統的基礎。
指標 — 一段時間內的數值資料
指標是隨著時間的推移測量和收集的數值。它們可讓您觀察趨勢、設定警報閾值並檢測異常。例如:每秒請求數、CPU 使用率、平均延遲、錯誤率。
metric 的優點是儲存成本低、查詢快、非常適合用於警報。但是,指標無法告訴您 為什麼 某個值不正常 — 您需要日誌和追蹤來進一步調查。
日誌 — 事件日誌
日誌是應用程式和系統產生的事件日誌。它們提供了有關特定時間發生的事情的最詳細的背景資訊。每個日誌條目通常包括時間戳記、嚴重性等級、訊息和元資料欄位。
當您確定了時間段和有問題的組件(來自指標警報)並且需要了解更多詳細資訊時,日誌非常強大。日誌面臨的挑戰是資料量龐大,儲存/查詢成本可能非常高。
追蹤 — 請求追蹤
分散式追蹤跨多個服務和元件追蹤請求。每個追蹤由多個 spans 組成 - 具有開始和結束時間戳、操作名稱和元資料的工作單元。追蹤可協助您了解服務之間的依賴關係、識別瓶頸以及偵錯與延遲相關的錯誤。
為什麼需要全部三個?
在典型調查過程中協同工作的三大支柱:
-
___HTMLTAG_38__HTMLTAG_39___指標警報警告錯誤率在凌晨 2:30 增加
- 您開啟 Grafana 儀表板檢視指標並意識到服務支付有問題
- 您在此期間跳轉至 Loki 日誌 進行服務付款,並看到「連線被拒絕」錯誤
- 您按一下日誌行中的追蹤 ID 並跳到 Tempo 追蹤 以查看請求在資料庫呼叫處逾時
- 結論:資料庫連線池已耗盡
三個支柱都無法單獨提供足夠的資訊。力量在於它們之間的組合和相關性。
OpenTelemetry — 獨特標準 2026
在 OpenTelemetry 之前,每個供應商(Datadog、New Relic、Jaeger、Zipkin...)都有自己的 SDK 和代理商。改變供應商意味著重寫檢測程式碼。 OpenTelemetry (OTel) 的誕生就是為了解決這個供應商鎖定問題。
什麼是 OpenTelemetry?
OpenTelemetry 是 CNCF 畢業專案 — 收集和匯出遙測資料(指標、日誌、追蹤)的業界標準。 OTel 由 2019 年 OpenCensus 和 OpenTracing 合併而成,到 2026 年,OTel 已成為雲端原生生態系統中無可爭議的標準。
與供應商無關的架構
OTel 架構明確區分了偵測(如何收集資料)和匯出(將資料傳送到何處)。您檢測一次,然後只需更改匯出器配置即可將資料傳送至 Prometheus、Jaeger、Datadog、New Relic 或任何後端。
自動偵測 — 無需更改程式碼
OTel 最強大的功能之一是其自動偵測功能。借助 Java、Python、Node.js 和 .NET 等流行語言,OTel 可以自動注入檢測,無需開發人員更改任何程式碼行。這對於:
特別有用- 沒有偵測的舊版應用程式__HTMLTAG_77___
- 您無法控制其原始程式碼的第三方程式庫
- 為整個車隊快速部署儀器__HTMLTAG_81___
OTLP 協定 — 統一傳輸
OpenTelemetry Line Protocol (OTLP) 是用於傳輸指標、日誌和追蹤的統一協定。 OTLP 支援 gRPC(連接埠 4317)和 HTTP(連接埠 4318)。對所有三種訊號類型使用單一協定可以大幅簡化網路配置、防火牆規則和負載平衡。
Kubernetes 的 OpenTelemetry 運算子
OpenTelemetry Operator 是一個 Kubernetes Operator,用於管理 OTel 收集器和自動檢測的部署和配置。它提供了兩個主要的 CRD:
-
___HTMLTAG_92__HTMLTAG_93___OpenTelemetryCollector:部署與設定 OTel Collector 實例
___HTMLTAG_96__HTMLTAG_97___偵測:為工作負載設定自動偵測
程式碼區塊_0
應用Instrumentation CRD後,只需在Pod中加入註解即可啟動自動偵測:
程式碼區塊_1
PLG 堆疊與 EFK 堆疊
Kubernetes 中用於日誌聚合和可觀察性的兩個最受歡迎的堆疊是 PLG (Prometheus + Loki + Grafana) 和 EFK (Elasticsearch + Fluentd/Fluent Bit + Kibana)。在它們之間進行選擇取決於特定的用例。
PLG 堆疊 — 輕量級、廉價、基於標籤
PLG 堆疊專為雲端原生環境而設計,其理念是「索引標籤,而不是內容」:
-
___HTMLTAG_112__HTMLTAG_113___Prometheus:依時間序列收集與儲存指標
___HTMLTAG_116__HTMLTAG_117___Loki:使用基於標籤的索引進行日誌聚合(類似於 Prometheus,但用於日誌)
___HTMLTAG_120__HTMLTAG_121___Grafana:所有資料來源的統一視覺化
Loki 不索引日誌內容(僅標籤),這使得儲存和營運成本顯著低於 Elasticsearch。權衡是全文搜尋功能不太強大。但對於大多數用例(按服務、命名空間、時間範圍、模式匹配進行查詢),Loki 完全足夠了。
EFK 堆疊 — 全文搜索,較重
EFK 堆疊針對全文搜尋和複雜分析進行了最佳化:
-
___HTMLTAG_132__HTMLTAG_133___Elasticsearch:全文索引日誌存儲,搜尋能力很強
___HTMLTAG_136__HTMLTAG_137___Fluentd/Fluent Bit:日誌收集器與處理器
___HTMLTAG_140__HTMLTAG_141___Kibana:Elasticsearch 的可視化與搜尋 UI
Elasticsearch 對整個日誌內容建立索引,從而實現極其強大的全文搜尋。然而,這是有代價的:Elasticsearch 消耗更多的 RAM 和 CPU,需要至少 3 個節點的叢集來確保 HA,並且營運成本要高得多。
何時使用 EFK?
在下列情況下選擇 EFK:
- 需要在日誌內容中進行全文搜尋(例如,可選地按錯誤訊息搜尋)
- 需要對日誌資料進行複雜的聚合和分析
- 團隊擁有 Elasticsearch 經驗
- 預算不是問題,需要 Elastic 的企業功能
對於大多數團隊來說,PLG 堆疊是 2026 年 Kubernetes 可觀測性的更好選擇。更低的營運成本、與 Prometheus 生態系統更好的整合以及物件儲存上更好的可擴展性。
Grafana 合金 — 統一收集器
Grafana Alloy(2024 年正式發布,取代 Grafana Agent)是一個統一的遙測收集器,繼承並合併了許多以前的工具:
- 取代 Promtail(Loki 日誌收集器)
- 取代 Prometheus 遠端寫入代理程式___HTMLTAG_174__HTMLTAG_175___
- 在許多用例中取代 OTel Collector
- 替換 Grafana 代理(前身)
River DSL 設定__HTMLTAG_186___
Alloy 使用 River DSL — Grafana 自己的設定語言,基於 HCL (Terraform)。 River 能夠聲明具有互連組件的管道:
程式碼區塊_2
從代理程式收集指標、日誌、追蹤
Alloy 允許運行單個 DaemonSet 來處理所有這些,而不是運行 3-4 個單獨的 DaemonSet(Promtail、節點導出器、OTel Collector...)。這最大限度地減少了:
- 每個節點上運行的 Pod 數量
- 容器運行時的開銷__HTMLTAG_197___
- 設定管理的複雜性__HTMLTAG_199___
- 到後端的網路連線
推薦堆疊 2026
基於營運現實和社群趨勢,以下是 2026 年 Kubernetes 的建議可觀測性堆疊:
主要组件
-
___HTMLTAG_210__HTMLTAG_211___指標:Prometheus + kube-state-metrics + 節點導出器
___HTMLTAG_214__HTMLTAG_215___日誌:Loki(帶有用於生產的物件儲存後端)
___HTMLTAG_218__HTMLTAG_219___痕跡:Grafana 節奏
___HTMLTAG_222__HTMLTAG_223___可視化:Grafana
___HTMLTAG_226__HTMLTAG_227___收集器:Grafana Alloy(每個節點的守護程序集)
___HTMLTAG_230__HTMLTAG_231___儀器標準:OpenTelemetry
架構流程
此堆疊中的資料流如下:
程式碼區塊_3
該架構的優點在於所有視覺化都通過一扇門:Grafana。您可以在不離開 Grafana UI 的情況下從指標 → 日誌 → 追蹤進行深入分析,並且可以透過追蹤 ID 或時間範圍關聯資料。
kube-prometheus-stack Helm 圖表
不是一一安裝每個元件,kube-prometheus-stack 是一個整合的一體化 Helm 圖表:
- 普羅米修斯運算子
- Prometheus 實例
- AlertManager
- Grafana
- kube-state-metrics__HTMLTAG_257___
- 節點導出器
- Kubernetes 的預設儀表板和警報規則__HTMLTAG_261___
程式碼區塊_4
開始使用的基本values.yaml檔案:
程式碼區塊_5
安裝 kube-prometheus-stack 後,您將擁有 Kubernetes 叢集的完整指標和警報。下一步是新增 Loki(日誌)和 Tempo(追蹤)以完成可觀察性堆疊。
摘要
可觀察性不是一個可以在以後添加的功能 - 它需要從頭開始設計。 2026 年,OpenTelemetry 已成為無可爭議的標準,而採用 Grafana Alloy 的 PLG 堆疊是大多數 Kubernetes 團隊最現實的選擇。
在接下來的課程中,我們將深入了解每個組件:
-
___HTMLTAG_274__HTMLTAG_275___第 29 課:Prometheus Operator、ServiceMonitor、PromQL、AlertManager
___HTMLTAG_278__HTMLTAG_279___第 30 課:Loki、Tempo 與相關可觀察性
___HTMLTAG_282__HTMLTAG_283___第 31 課:Kubernetes 除錯與故障排除
___HTMLTAG_286__HTMLTAG_287___練習 7:部署整個堆疊並練習端對端