1. はじめに:なぜU-NetがDiffusion Modelsの心臓部なのか?
前のレッスンでは、フォワードプロセスが各タイムステップで画像にノイズを加えることを理解しました。ここで問題となるのは、どのモデルがデノイジング(このプロセスを逆転させること)を学習するのかということです。その答えがU-Netです。
U-Netは元々、医療画像における画像セグメンテーションのために設計されました(2015年、Ronneberger et al.)。エンコーダ・デコーダとスキップ接続を持つ特別なアーキテクチャにより、複数の抽象度レベルで特徴を学習しながら空間的な詳細を保持できます。これはまさにDiffusion Modelsが必要とするものです。
試験のヒント: 評価試験では、U-Netをゼロから実装する必要があります。各レイヤーを通るテンソルの次元を理解することが鍵です。NVIDIA DLIでは、理論を理解するだけでなく、動作するコードを書くことが求められます。
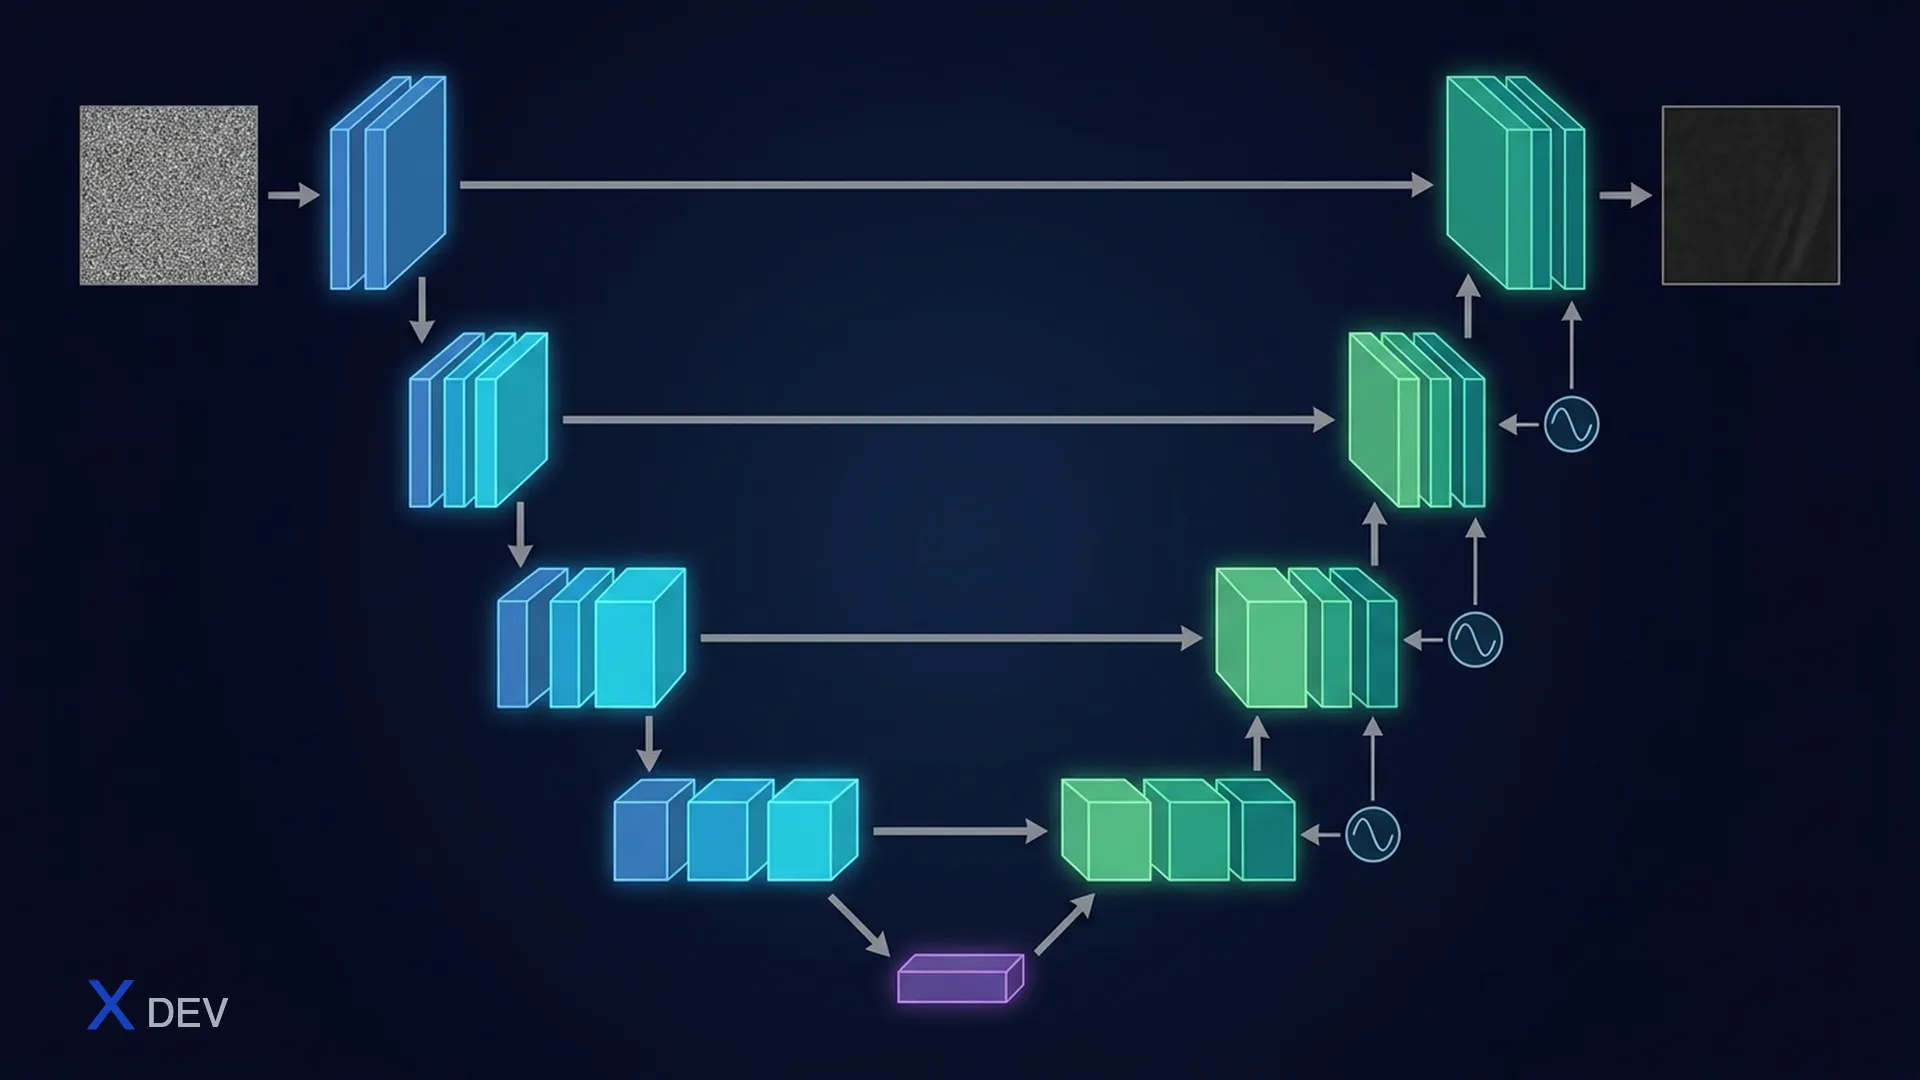
2. U-Netアーキテクチャ:スキップ接続付きエンコーダ・デコーダ
2.1 アーキテクチャの概要
U-Netは「U」字型をしており、3つの主要部分で構成されています:
- エンコーダ(縮小パス):空間解像度を下げ、チャネル数を増やす — 高レベルの抽象的な特徴を学習します
- ボトルネック:最小の空間解像度、最大のチャネル数 — グローバルなコンテキストを捉えます
- デコーダ(拡大パス):空間解像度を上げ、チャネル数を減らす — 詳細を復元します
- スキップ接続:エンコーダの特徴を対応するデコーダに直接接続 — 細かい詳細を保持します
U-Net Architecture for Diffusion (input 64×64×1)
═══════════════════════════════════════════════

          ENCODER                              DECODER
     (Contracting Path)                   (Expanding Path)

  ┌─────────────────┐                 ┌─────────────────┐
  │  64 × 64 × 1    │   Input Image   │  64 × 64 × 1    │  Output (denoised)
  └────────┬────────┘                 └────────▲────────┘
           │                                    │
           ▼                                    │
  ┌─────────────────┐  skip connection  ┌─────────────────┐
  │  64 × 64 × 64   │ ───────────────► │  64 × 64 × 64   │  UpBlock + Concat
  │  Conv→GN→GELU   │   (concatenate)   │  Conv→GN→GELU   │
  └────────┬────────┘                 └────────▲────────┘
           │ Downsample                        │ Upsample
           ▼                                    │
  ┌─────────────────┐  skip connection  ┌─────────────────┐
  │  32 × 32 × 128  │ ───────────────► │  32 × 32 × 128  │  UpBlock + Concat
  │  Conv→GN→GELU   │   (concatenate)   │  Conv→GN→GELU   │
  └────────┬────────┘                 └────────▲────────┘
           │ Downsample                        │ Upsample
           ▼                                    │
  ┌─────────────────┐  skip connection  ┌─────────────────┐
  │  16 × 16 × 256  │ ───────────────► │  16 × 16 × 256  │  UpBlock + Concat
  │  Conv→GN→GELU   │   (concatenate)   │  Conv→GN→GELU   │
  └────────┬────────┘                 └────────▲────────┘
           │ Downsample                        │ Upsample
           ▼                                    │
  ┌──────────────────────────────────────────────┐
  │              8 × 8 × 512                      │
  │           BOTTLENECK                          │
  │     Conv → GN → GELU → Conv → GN             │
  │  (smallest spatial, largest channels)         │
  └───────────────────────────────────────────────┘

  + Timestep Embedding ──► 各ResidualBlockにlinear projectionで注入
2.2 エンコーダパス(縮小)
各エンコーダレベルでは以下の処理を行います:
- 畳み込み:3×3 conv、padding=1(空間サイズを維持)
- Group Normalization:バッチではなくグループ単位で正規化
- GELU活性化:ReLUよりも滑らかな非線形関数
- ダウンサンプル:空間解像度を2倍に縮小(stride=2 convまたはRearrange Poolingを使用)
各レベルでチャネル数は2倍に、空間は半分になります。例えば:
| レベル | 入力形状 | 出力形状 | 操作 |
|---|---|---|---|
| 0 | B × 1 × 64 × 64 | B × 64 × 64 × 64 | 初期Conv |
| 1 | B × 64 × 64 × 64 | B × 128 × 32 × 32 | ResBlock → Down |
| 2 | B × 128 × 32 × 32 | B × 256 × 16 × 16 | ResBlock → Down |
| 3 | B × 256 × 16 × 16 | B × 512 × 8 × 8 | ResBlock → Down |
2.3 デコーダパス(拡大)
エンコーダとは逆に、デコーダは空間を増加させ、チャネルを減少させます:
- アップサンプル:空間解像度を2倍に拡大(通常
nn.Upsampleまたはnn.ConvTranspose2dを使用) - 同じレベルのエンコーダからのスキップ接続と結合
- 畳み込み → GroupNorm → GELU:結合された特徴を処理
試験のヒント: スキップ接続を結合する際、チャネル数は一時的に2倍になります。例えば:アップサンプル出力が256チャネル + スキップが256チャネル = convへの入力は512チャネル。これは実装でよくあるエラーです — concat後のconvの
in_channelsに注意してください!
2.4 スキップ接続 — なぜ重要なのか?
スキップ接続がなければ、デコーダは8×8のボトルネックだけからすべての空間的詳細を「推測」しなければなりません — ほぼ不可能です。スキップ接続は以下を可能にします:
- 勾配の流れ:勾配が損失関数から深いエンコーダ層に直接流れる — 学習が容易になります
- 詳細の保持:高レベルのエンコーダがエッジやテクスチャを保持 — デコーダは再学習する代わりにそれらを再利用します
- マルチスケール特徴:デコーダは高レベル(ボトルネックから)と低レベル(スキップから)の両方の特徴を受け取ります
3. 主要コンポーネント:GroupNorm、GELU、Rearrange Pooling
3.1 Group Normalization
Diffusion Modelsでは、各画像が多くのGPUメモリを消費するため、バッチサイズは通常非常に小さい(4〜8)です。Batch Normalizationは、バッチ全体で計算される統計量(平均、分散)が不安定になるため、小さいバッチでは性能が低下します。
Group Normalizationは、チャネルをグループに分割し、各グループ内で、各サンプルを独立に正規化することでこの問題を解決します — バッチサイズに依存しません。
Group Normalization vs Batch Normalization
══════════════════════════════════════════

Batch Normalization:              Group Normalization:
  N(バッチ)全体で正規化            Cのグループ内で正規化

  ┌───┬───┬───┬───┐               ┌───┬───┬───┬───┐
  │ N │   │   │   │               │   │   │   │   │  N (batch)
  ├───┼───┼───┼───┤               ├───┼───┼───┼───┤
  │   │   │   │   │  C            │ G1│ G1│ G2│ G2│  C (channels)
  ├───┼───┼───┼───┤  (channels)   ├───┼───┼───┼───┤  グループに分割
  │   │   │   │   │               │ G1│ G1│ G2│ G2│
  ├───┼───┼───┼───┤               ├───┼───┼───┼───┤
  │   │   │   │   │  H×W          │   │   │   │   │  H×W
  └───┴───┴───┴───┘               └───┴───┴───┴───┘
     ▲                                 ▲
     列を正規化(N全体)               ブロックを正規化(グループ内)
     ⚠ 小バッチ → 不安定               ✓ バッチサイズに依存しない
import torch.nn as nn

# GroupNorm: 64チャネルを8グループに分割(各グループ8チャネル)
norm = nn.GroupNorm(num_groups=8, num_channels=64)

# 入力形状 (B, 64, 32, 32) の場合:
# - 64チャネルを8グループ、各8チャネルに分割
# - 各サンプル、各グループで (8, 32, 32) = 8192要素の平均・分散を計算
# - 各サンプル、各グループで独立に正規化

x = torch.randn(4, 64, 32, 32)
out = norm(x)  # shape: (4, 64, 32, 32) — 形状は変化しない
| 特徴 | BatchNorm | GroupNorm | LayerNorm | InstanceNorm |
|---|---|---|---|---|
| 正規化の対象 | バッチ (N) | チャネルグループ | 全チャネル | 各チャネル |
| バッチサイズ依存 | あり ⚠ | なし ✓ | なし ✓ | なし ✓ |
| 小バッチ性能 | 低い | 良好 | 普通 | 普通 |
| 用途 | 分類 | Diffusion、検出 | Transformer (NLP) | スタイル変換 |
| PyTorch API | nn.BatchNorm2d(C) | nn.GroupNorm(G, C) | nn.LayerNorm(shape) | nn.InstanceNorm2d(C) |
3.2 GELU活性化関数
GELU(Gaussian Error Linear Unit)は、現代のモデル(Transformer、Diffusion Models)における標準的な活性化関数です。「ハードな」ReLU(負の値を0に切り捨て)とは異なり、GELUは滑らかで、負の値の一部が「漏れる」ことを許容します。
数式:GELU(x) = x · Φ(x)、ここでΦ(x)は標準正規分布の累積分布関数です。
活性化関数の比較
═══════════════════════════════

 出力                              出力
   │     ReLU                          │     GELU
   │      ╱                            │      ╱
   │     ╱                             │    ╱
   │    ╱                              │  ╱
───┼───╱────── 入力            ───┼──╱─────── 入力
   │  ╱                              ╱│
   │ ╱                              ╱ │
   │╱  (0でハードカットオフ)       ╱  │  (滑らかな曲線、小さな
   │                             ╱    │   負の値を許容)

 ReLU(x) = max(0, x)           GELU(x) = x · Φ(x)
 ⚠ 死んだニューロン問題          ✓ より滑らかな勾配の流れ
 ⚠ 0で微分不可能                 ✓ 深いネットワークに適している
import torch.nn as nn

# 方法1: モジュールを使用
activation = nn.GELU()
out = activation(x)

# 方法2: functionalを使用
import torch.nn.functional as F
out = F.gelu(x)

# 方法3: 近似版(高速、DLIコースで使用)
activation = nn.GELU(approximate='tanh')
3.3 Rearrange Pooling(空間→チャネル変換)
Rearrange Poolingは、MaxPool/AvgPoolを置き換えるダウンサンプリング手法です。情報を捨てる(MaxPoolは最大値を選択、AvgPoolは平均を取る)代わりに、Rearrangeは空間次元をチャネル次元に「折り畳み」ます — すべての情報を保持します。
Rearrange Pooling: (B, C, 2H, 2W) → (B, 4C, H, W)
════════════════════════════════════════════════════

Input: (B, C, 4, 4)                   Output: (B, 4C, 2, 2)

Channel c:                             4チャネル(各「位置」に対応):
┌───┬───┬───┬───┐                     Channel c_0:    Channel c_1:
│ a │ b │ e │ f │                     ┌───┬───┐       ┌───┬───┐
├───┼───┼───┼───┤                     │ a │ e │       │ b │ f │
│ c │ d │ g │ h │      ────►         ├───┼───┤       ├───┼───┤
├───┼───┼───┼───┤   Rearrange        │ i │ m │       │ j │ n │
│ i │ j │ m │ n │                     └───┴───┘       └───┴───┘
├───┼───┼───┼───┤
│ k │ l │ o │ p │                     Channel c_2:    Channel c_3:
└───┴───┴───┴───┘                     ┌───┬───┐       ┌───┬───┐
                                       │ c │ g │       │ d │ h │
空間: 4×4、チャネル: C                 ├───┼───┤       ├───┼───┤
                                       │ k │ o │       │ l │ p │
                                       └───┴───┘       └───┴───┘

                                       空間: 2×2、チャネル: 4C
                                       ✓ 情報の損失なし!
from einops import rearrange

def rearrange_downsample(x):
    """空間次元をチャネルに再配置してダウンサンプル。
    (B, C, H, W) -> (B, 4C, H/2, W/2)
    """
    return rearrange(x, 'b c (h p1) (w p2) -> b (c p1 p2) h w', p1=2, p2=2)

# 例:
x = torch.randn(2, 64, 32, 32)
out = rearrange_downsample(x)
print(out.shape)  # torch.Size([2, 256, 16, 16])

# einopsなしで、純粋なPyTorchを使用:
def rearrange_downsample_pure(x):
    B, C, H, W = x.shape
    x = x.reshape(B, C, H // 2, 2, W // 2, 2)
    x = x.permute(0, 1, 3, 5, 2, 4)  # (B, C, 2, 2, H/2, W/2)
    x = x.reshape(B, C * 4, H // 2, W // 2)
    return x
| ダウンサンプリング手法 | 情報の損失 | チャネルの変化 | Diffusionでの使用 |
|---|---|---|---|
| MaxPool2d | 高い(最大値のみ保持) | 変化なし | ほとんど使用されない |
| AvgPool2d | 中程度(平均を取る) | 変化なし | ほとんど使用されない |
| Stride-2 Conv | 学習可能(訓練可能) | 設定可能 | 一般的 |
| Rearrange Pooling | なし ✓ | ×4 | NVIDIA DLIコース ✓ |
試験のヒント: NVIDIA DLIではMaxPoolの代わりにRearrange Poolingを使用します。評価試験では、
einops.rearrangeまたは純粋なPyTorch(reshape+permute)でこの関数を実装する必要があるかもしれません。空間が各次元で2倍縮小すると、チャネルは4倍に増加することを覚えておいてください。
4. タイムステップのためのSinusoidal Position Embeddings
4.1 なぜTimestep Embeddingが必要なのか?
U-Netは適切にデノイジングするために、拡散プロセスの中で現在どのタイムステップにいるかを知る必要があります:
- 大きなタイムステップ(tがTに近い):画像はほぼ純粋なノイズ → モデルは全体的な構造を復元する必要があります
- 小さなタイムステップ(tが0に近い):画像はほぼクリーン → モデルは小さな詳細を微調整するだけです
整数のタイムステップtを長さembed_dimの連続的な埋め込みベクトルに変換し、U-Netの各レイヤーに注入します。
4.2 Sinusoidal Embeddingの数式
TransformerのPositional Encodingと同じです(「Attention Is All You Need」):
PE(t, 2i)   = sin(t / 10000^(2i/d))
PE(t, 2i+1) = cos(t / 10000^(2i/d))

ここで:
  t = タイムステップ(整数: 0, 1, 2, ..., T)
  d = 埋め込み次元(例: 128)
  i = 埋め込みベクトル内のインデックス(0, 1, 2, ..., d/2 - 1)

d=8の例:
  PE(t) = [sin(t/1), cos(t/1), sin(t/100), cos(t/100),
           sin(t/10000), cos(t/10000), sin(t/1000000), cos(t/1000000)]

  → 低周波成分(末尾): ゆっくり変化 → 「大まかな」タイムステップをエンコード
  → 高周波成分(先頭): 速く変化 → 細かいタイムステップの違いをエンコード
4.3 TimestepEmbeddingの実装
import torch
import torch.nn as nn
import math

class SinusoidalPositionEmbedding(nn.Module):
    """整数タイムステップをsinusoidal埋め込みベクトルに変換。"""

    def __init__(self, embed_dim):
        super().__init__()
        self.embed_dim = embed_dim

    def forward(self, timesteps):
        """
        Args:
            timesteps: (B,) — 整数タイムステップ
        Returns:
            embeddings: (B, embed_dim) — sinusoidal埋め込み
        """
        device = timesteps.device
        half_dim = self.embed_dim // 2

        # 周波数を計算: 1/10000^(2i/d)、i = 0, 1, ..., d/2-1
        exponent = torch.arange(half_dim, device=device).float() / half_dim
        freqs = torch.exp(-math.log(10000.0) * exponent)  # shape: (d/2,)

        # タイムステップと周波数を乗算: (B, 1) * (1, d/2) = (B, d/2)
        args = timesteps[:, None].float() * freqs[None, :]

        # sinとcosを結合: (B, d/2) cat (B, d/2) = (B, d)
        embeddings = torch.cat([torch.sin(args), torch.cos(args)], dim=-1)

        return embeddings  # shape: (B, embed_dim)


class TimestepMLPEmbedding(nn.Module):
    """Sinusoidal埋め込み + MLP射影(DLIコースで使用)。"""

    def __init__(self, embed_dim, hidden_dim=None):
        super().__init__()
        if hidden_dim is None:
            hidden_dim = embed_dim * 4

        self.sinusoidal = SinusoidalPositionEmbedding(embed_dim)
        self.mlp = nn.Sequential(
            nn.Linear(embed_dim, hidden_dim),
            nn.GELU(),
            nn.Linear(hidden_dim, hidden_dim),
        )

    def forward(self, timesteps):
        """
        Args:
            timesteps: (B,) — 整数タイムステップ
        Returns:
            (B, hidden_dim) — 射影されたタイムステップ埋め込み
        """
        x = self.sinusoidal(timesteps)  # (B, embed_dim)
        x = self.mlp(x)                 # (B, hidden_dim)
        return x
4.4 U-Netへのタイムステップ注入
タイムステップ埋め込みは、以下の方法ですべてのResidualBlockに注入されます:
- タイムステップ埋め込みを特徴マップのチャネル数に合わせて射影(
nn.Linearを使用) - ブロードキャスト用に
(B, C, 1, 1)にリシェイプ - 最初のGroupNormの後に特徴マップに加算
タイムステップ注入の流れ
═══════════════════════

timestep t ──► SinusoidalEmbed ──► MLP ──► t_emb (B, hidden_dim)
                                              │
                                    Linear(hidden_dim, C)
                                              │
                                         (B, C, 1, 1)   ← ブロードキャスト用にリシェイプ
                                              │
Feature Map: ─── Conv ─── GroupNorm ────── (+) ────── GELU ─── Conv ─── ...
                                          ここで加算
試験のヒント: タイムステップ埋め込みは特徴マップに加算されます。結合(concatenate)ではありません。注入は各ResidualBlockのGroupNormの後、GELUの前に行われます。これはDLIコースにおける固定パターンです。
5. U-Netをゼロから構築 — ステップバイステップ
5.1 ResidualBlock
これが最も基本的な構成要素です。各ResidualBlockは2つのconvレイヤー + GroupNorm + GELUで構成され、残差接続とタイムステップ注入が含まれます。
class ResidualBlock(nn.Module):
    """タイムステップ埋め込み注入付き残差ブロック。

    流れ: x → Conv1 → GN1 → (+t_emb) → GELU → Conv2 → GN2 → GELU → (+residual) → out
    """

    def __init__(self, in_channels, out_channels, time_emb_dim):
        super().__init__()

        # 第1畳み込みレイヤー
        self.conv1 = nn.Conv2d(in_channels, out_channels, kernel_size=3, padding=1)
        self.norm1 = nn.GroupNorm(num_groups=8, num_channels=out_channels)

        # 第2畳み込みレイヤー
        self.conv2 = nn.Conv2d(out_channels, out_channels, kernel_size=3, padding=1)
        self.norm2 = nn.GroupNorm(num_groups=8, num_channels=out_channels)

        # 活性化関数
        self.act = nn.GELU()

        # タイムステップ埋め込み射影: out_channelsに射影
        self.time_mlp = nn.Sequential(
            nn.GELU(),
            nn.Linear(time_emb_dim, out_channels),
        )

        # 残差接続: in_channels != out_channelsの場合、1x1 convが必要
        if in_channels != out_channels:
            self.residual_conv = nn.Conv2d(in_channels, out_channels, kernel_size=1)
        else:
            self.residual_conv = nn.Identity()

    def forward(self, x, t_emb):
        """
        Args:
            x: (B, in_channels, H, W) — 入力特徴マップ
            t_emb: (B, time_emb_dim) — タイムステップ埋め込み
        Returns:
            (B, out_channels, H, W)
        """
        residual = self.residual_conv(x)   # (B, out_channels, H, W)

        # 第1レイヤー
        h = self.conv1(x)                   # (B, out_channels, H, W)
        h = self.norm1(h)                   # 正規化

        # タイムステップ埋め込みを注入
        t = self.time_mlp(t_emb)            # (B, out_channels)
        t = t[:, :, None, None]             # (B, out_channels, 1, 1) ブロードキャスト
        h = h + t                           # タイムステップ情報を加算

        h = self.act(h)                     # GELU活性化

        # 第2レイヤー
        h = self.conv2(h)                   # (B, out_channels, H, W)
        h = self.norm2(h)                   # 正規化
        h = self.act(h)                     # GELU活性化

        return h + residual                  # 残差接続
5.2 DownBlock(エンコーダレベル)
class DownBlock(nn.Module):
    """エンコーダブロック: ResidualBlock + Rearrangeダウンサンプル。"""

    def __init__(self, in_channels, out_channels, time_emb_dim):
        super().__init__()
        self.res_block = ResidualBlock(in_channels, out_channels, time_emb_dim)

    def downsample(self, x):
        """Rearrange pooling: (B, C, H, W) -> (B, 4C, H/2, W/2)"""
        B, C, H, W = x.shape
        x = x.reshape(B, C, H // 2, 2, W // 2, 2)
        x = x.permute(0, 1, 3, 5, 2, 4).reshape(B, C * 4, H // 2, W // 2)
        return x

    def forward(self, x, t_emb):
        """
        Args:
            x: (B, in_channels, H, W)
            t_emb: (B, time_emb_dim)
        Returns:
            skip: (B, out_channels, H, W) — スキップ接続用
            down: (B, out_channels*4, H/2, W/2) — 次のレベルへのダウンサンプル
        """
        skip = self.res_block(x, t_emb)    # (B, out_channels, H, W)
        down = self.downsample(skip)         # (B, out_channels*4, H/2, W/2)
        return skip, down
5.3 UpBlock(デコーダレベル)
class UpBlock(nn.Module):
    """デコーダブロック: アップサンプル + スキップ結合 + ResidualBlock。"""

    def __init__(self, in_channels, skip_channels, out_channels, time_emb_dim):
        super().__init__()
        # in_channels = アップサンプル後の下位レベルからのチャネル数
        # スキップと結合後: in_channels + skip_channels
        self.res_block = ResidualBlock(
            in_channels + skip_channels, out_channels, time_emb_dim
        )
        self.upsample = nn.Upsample(scale_factor=2, mode='nearest')

    def forward(self, x, skip, t_emb):
        """
        Args:
            x: (B, in_channels, H, W) — 下位レベルから
            skip: (B, skip_channels, 2H, 2W) — エンコーダからのスキップ接続
            t_emb: (B, time_emb_dim)
        Returns:
            (B, out_channels, 2H, 2W)
        """
        x = self.upsample(x)               # (B, in_channels, 2H, 2W)
        x = torch.cat([x, skip], dim=1)     # (B, in_channels+skip_channels, 2H, 2W)
        x = self.res_block(x, t_emb)        # (B, out_channels, 2H, 2W)
        return x
5.4 完全なU-Netの組み立て
class UNet(nn.Module):
    """Diffusionデノイジングのための完全なU-Net。

    アーキテクチャ: 64×64×1 → エンコーダ(3レベル) → ボトルネック → デコーダ(3レベル) → 64×64×1
    チャネル推移: 1 → 64 → 128 → 256 → 512 (ボトルネック) → 256 → 128 → 64 → 1
    """

    def __init__(self, in_channels=1, base_channels=64, time_emb_dim=128):
        super().__init__()

        # タイムステップ埋め込み
        self.time_embed = TimestepMLPEmbedding(
            embed_dim=time_emb_dim,
            hidden_dim=time_emb_dim * 4
        )
        t_dim = time_emb_dim * 4  # MLPの出力次元

        # 初期畳み込み: 1 → 64
        self.init_conv = nn.Conv2d(in_channels, base_channels, kernel_size=3, padding=1)

        # エンコーダパス
        # レベル1: 64ch, 64×64 → Rearrange → 256ch, 32×32
        self.down1 = DownBlock(base_channels, base_channels, t_dim)        # 64 → 64 (skip), 256 (down)

        # レベル2: 256ch, 32×32 → Rearrange → 512ch, 16×16
        # Rearrangeで4倍チャネルになるため、先に1x1 convが必要
        self.down1_proj = nn.Conv2d(base_channels * 4, base_channels * 2, kernel_size=1)
        self.down2 = DownBlock(base_channels * 2, base_channels * 2, t_dim) # 128 → 128 (skip), 512 (down)

        # レベル3: 512ch, 16×16 → Rearrange → 1024ch, 8×8
        self.down2_proj = nn.Conv2d(base_channels * 8, base_channels * 4, kernel_size=1)
        self.down3 = DownBlock(base_channels * 4, base_channels * 4, t_dim) # 256 → 256 (skip), 1024 (down)

        # ボトルネック: 1024ch, 8×8 → 512ch, 8×8
        self.down3_proj = nn.Conv2d(base_channels * 16, base_channels * 8, kernel_size=1)
        self.bottleneck = ResidualBlock(base_channels * 8, base_channels * 8, t_dim)  # 512 → 512

        # デコーダパス
        # レベル3: 512を16×16にアップサンプル、skip(256)と結合 → 768 → 256
        self.up3 = UpBlock(base_channels * 8, base_channels * 4, base_channels * 4, t_dim)

        # レベル2: 256を32×32にアップサンプル、skip(128)と結合 → 384 → 128
        self.up2 = UpBlock(base_channels * 4, base_channels * 2, base_channels * 2, t_dim)

        # レベル1: 128を64×64にアップサンプル、skip(64)と結合 → 192 → 64
        self.up1 = UpBlock(base_channels * 2, base_channels, base_channels, t_dim)

        # 最終出力: 64 → 1
        self.final_conv = nn.Sequential(
            nn.GroupNorm(8, base_channels),
            nn.GELU(),
            nn.Conv2d(base_channels, in_channels, kernel_size=1),
        )

    def forward(self, x, timesteps):
        """
        Args:
            x: (B, 1, 64, 64) — ノイズ画像
            timesteps: (B,) — 整数タイムステップ
        Returns:
            (B, 1, 64, 64) — 予測されたクリーン画像(またはノイズ)
        """
        # タイムステップ埋め込み
        t_emb = self.time_embed(timesteps)    # (B, t_dim)

        # 初期conv
        x = self.init_conv(x)                 # (B, 64, 64, 64)

        # エンコーダ
        skip1, x = self.down1(x, t_emb)       # skip1: (B,64,64,64), x: (B,256,32,32)
        x = self.down1_proj(x)                 # (B, 128, 32, 32)

        skip2, x = self.down2(x, t_emb)       # skip2: (B,128,32,32), x: (B,512,16,16)
        x = self.down2_proj(x)                 # (B, 256, 16, 16)

        skip3, x = self.down3(x, t_emb)       # skip3: (B,256,16,16), x: (B,1024,8,8)
        x = self.down3_proj(x)                 # (B, 512, 8, 8)

        # ボトルネック
        x = self.bottleneck(x, t_emb)         # (B, 512, 8, 8)

        # デコーダ
        x = self.up3(x, skip3, t_emb)         # (B, 256, 16, 16)
        x = self.up2(x, skip2, t_emb)         # (B, 128, 32, 32)
        x = self.up1(x, skip1, t_emb)         # (B, 64, 64, 64)

        # 最終出力
        x = self.final_conv(x)                 # (B, 1, 64, 64)
        return x
テンソル形状を確認します:
# 形状を確認
model = UNet(in_channels=1, base_channels=64, time_emb_dim=128)
x = torch.randn(2, 1, 64, 64)
t = torch.randint(0, 1000, (2,))
out = model(x, t)
print(f"Input:  {x.shape}")    # torch.Size([2, 1, 64, 64])
print(f"Output: {out.shape}")  # torch.Size([2, 1, 64, 64])
print(f"Params: {sum(p.numel() for p in model.parameters()):,}")
U-Netを通るテンソル形状の流れ (base_channels=64)
═══════════════════════════════════════════════

レイヤー                   形状                    備考
──────────────────────────────────────────────────────────
Input                    (B, 1, 64, 64)
init_conv                (B, 64, 64, 64)        Conv2d(1, 64)

down1 ResBlock           (B, 64, 64, 64)        skip1 ─────────────────┐
down1 Rearrange          (B, 256, 32, 32)       チャネル4倍             │
down1_proj               (B, 128, 32, 32)       1×1 conv削減           │
                                                                        │
down2 ResBlock           (B, 128, 32, 32)       skip2 ──────────┐      │
down2 Rearrange          (B, 512, 16, 16)       チャネル4倍      │      │
down2_proj               (B, 256, 16, 16)       1×1 conv削減    │      │
                                                                 │      │
down3 ResBlock           (B, 256, 16, 16)       skip3 ───┐      │      │
down3 Rearrange          (B, 1024, 8, 8)        4倍ch    │      │      │
down3_proj               (B, 512, 8, 8)         削減     │      │      │
                                                          │      │      │
bottleneck               (B, 512, 8, 8)                   │      │      │
                                                          │      │      │
up3 Upsample             (B, 512, 16, 16)                │      │      │
up3 Concat skip3         (B, 768, 16, 16) ◄──────────────┘      │      │
up3 ResBlock             (B, 256, 16, 16)                        │      │
                                                                  │      │
up2 Upsample             (B, 256, 32, 32)                        │      │
up2 Concat skip2         (B, 384, 32, 32) ◄─────────────────────┘      │
up2 ResBlock             (B, 128, 32, 32)                               │
                                                                         │
up1 Upsample             (B, 128, 64, 64)                               │
up1 Concat skip1         (B, 192, 64, 64) ◄────────────────────────────┘
up1 ResBlock             (B, 64, 64, 64)

final_conv               (B, 1, 64, 64)         出力 = デノイズ画像
試験のヒント: 評価試験では、テンソル形状を正確に計算する必要があります。覚えるべきルール:Rearrange → チャネル×4、空間÷2。スキップ接続を結合した後のチャネル = アップサンプルのチャネル + スキップのチャネル。コーディング前にメモ用紙にこれらを書き出しましょう!
6. デノイザーモデルの学習
6.1 シンプルなデノイジングタスク
完全な拡散プロセス(複数のタイムステップ)を学ぶ前に、シンプルなタスクから始めます:
画像にガウスノイズを加える → U-Netに元の画像を復元させる
シンプルなデノイジングタスク
═════════════════════

元の画像              ノイズを加える            ノイズ画像          U-Net         デノイズ出力
   ┌──────┐          ┌──────┐                  ┌──────┐         ┌─────┐         ┌──────┐
   │ 🖼️   │    +     │ ░░░░ │  noise_level     │ ░🖼️░ │  ────► │U-Net│  ────►  │ 🖼️   │
   │      │          │ ░░░░ │  * N(0,1)        │ ░░░░ │         │     │         │      │
   └──────┘          └──────┘                  └──────┘         └─────┘         └──────┘
      x₀               ε                      x_noisy          x₀を           x̂₀
                                            = x₀ + σ·ε         予測

Loss = MSE(x̂₀, x₀) = ‖U-Net(x_noisy, t) - x₀‖²
6.2 学習ループ
import torch
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import DataLoader
from torchvision import datasets, transforms

# ハイパーパラメータ
BATCH_SIZE = 32
LEARNING_RATE = 1e-4
EPOCHS = 50
NOISE_LEVEL = 0.5  # σ: ノイズの量を制御
DEVICE = torch.device('cuda' if torch.cuda.is_available() else 'cpu')

# データセット: MNIST(グレースケール 28×28 → 64×64にリサイズ)
transform = transforms.Compose([
    transforms.Resize((64, 64)),
    transforms.ToTensor(),           # [0, 1]
    transforms.Normalize([0.5], [0.5])  # [-1, 1]
])
dataset = datasets.MNIST(root='./data', train=True, transform=transform, download=True)
dataloader = DataLoader(dataset, batch_size=BATCH_SIZE, shuffle=True)

# モデル、オプティマイザ、損失関数
model = UNet(in_channels=1, base_channels=64, time_emb_dim=128).to(DEVICE)
optimizer = optim.Adam(model.parameters(), lr=LEARNING_RATE)
loss_fn = nn.MSELoss()

# 学習ループ
for epoch in range(EPOCHS):
    total_loss = 0
    for batch_idx, (images, _) in enumerate(dataloader):
        images = images.to(DEVICE)                    # (B, 1, 64, 64)

        # ランダムなタイムステップ(各サンプルに異なるタイムステップ)
        timesteps = torch.randint(0, 1000, (images.shape[0],), device=DEVICE)

        # タイムステップに応じてノイズレベルをスケーリング(シンプル:線形スケーリング)
        noise_scales = (timesteps.float() / 1000.0 * NOISE_LEVEL)  # (B,)
        noise_scales = noise_scales[:, None, None, None]             # (B,1,1,1)

        # ノイズを加える
        noise = torch.randn_like(images)                             # (B, 1, 64, 64)
        noisy_images = images + noise_scales * noise                 # (B, 1, 64, 64)

        # フォワードパス: クリーン画像を予測
        predicted_clean = model(noisy_images, timesteps)             # (B, 1, 64, 64)

        # 損失: 予測クリーン画像と実際のクリーン画像のMSE
        loss = loss_fn(predicted_clean, images)

        # バックワードパス
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()

        total_loss += loss.item()

    avg_loss = total_loss / len(dataloader)
    print(f"Epoch [{epoch+1}/{EPOCHS}], Loss: {avg_loss:.6f}")
6.3 結果の可視化
import matplotlib.pyplot as plt

@torch.no_grad()
def visualize_denoising(model, dataloader, noise_level=0.5, num_images=5):
    """表示: 元の画像 → ノイズ画像 → デノイズ画像。"""
    model.eval()
    images, _ = next(iter(dataloader))
    images = images[:num_images].to(DEVICE)

    # ノイズを加える
    timesteps = torch.full((num_images,), 500, device=DEVICE)
    noise = torch.randn_like(images) * noise_level
    noisy = images + noise

    # デノイズ
    denoised = model(noisy, timesteps)

    # プロット
    fig, axes = plt.subplots(3, num_images, figsize=(num_images * 3, 9))
    titles = ['元の画像', 'ノイズ画像', 'デノイズ画像']

    for i in range(num_images):
        for j, (img, title) in enumerate(zip(
            [images[i], noisy[i], denoised[i]], titles
        )):
            ax = axes[j][i]
            # 逆正規化: [-1,1] → [0,1]
            img_np = (img.cpu().squeeze() * 0.5 + 0.5).clamp(0, 1).numpy()
            ax.imshow(img_np, cmap='gray')
            ax.set_title(title if i == 0 else '')
            ax.axis('off')

    plt.tight_layout()
    plt.savefig('denoising_results.png', dpi=150)
    plt.show()

visualize_denoising(model, dataloader)
試験のヒント: 評価試験では、学習ループを完成させる必要があるかもしれません。3つの重要なステップを覚えてください:(1) クリーン画像にノイズを加える、(2) ノイズ画像 + タイムステップでU-Netのフォワードパス、(3) 予測と元の画像のMSE損失を計算。モデルにタイムステップを渡すことを忘れないでください!
7. チートシート — U-Net & デノイジング
| 概念 | 重要な詳細 | コード/数式 |
|---|---|---|
| U-Net構造 | エンコーダ → ボトルネック → デコーダ + スキップ接続 | U字型、skip = concatenate |
| GroupNorm | グループごとに正規化、バッチサイズ非依存 | nn.GroupNorm(8, channels) |
| GELU | 滑らかな活性化、x·Φ(x) | nn.GELU() |
| Rearrange Pooling | (B,C,2H,2W) → (B,4C,H,W)、損失なし | rearrange(x, 'b c (h p1) (w p2) → b (c p1 p2) h w', p1=2, p2=2) |
| Sinusoidal Embed | さまざまな周波数のsin/cos | sin(t/10000^(2i/d))、cos(t/10000^(2i/d)) |
| タイムステップ注入 | GroupNormの後に特徴マップに加算 | h = h + t_emb[:,:,None,None] |
| ResidualBlock | Conv→GN→(+t)→GELU→Conv→GN→GELU + skip | 2つのconvレイヤー + 残差 + タイムステップ |
| デノイジング損失 | 予測クリーンと実際のクリーンのMSE | MSE(model(x_noisy, t), x_clean) |
| スキップ接続の役割 | 空間詳細の保持、勾配の流れの改善 | torch.cat([upsample, skip], dim=1) |
| 結合後のチャネル | アップサンプルのチャネル + スキップのチャネル | 次のconvのin_channelsと一致必須 |
8. 練習問題
以下の問題はNVIDIA DLIコーディング評価をシミュレートしています。解答を確認する前にコーディングしてみてください!
Q1: タイムステップ注入付きResidualBlockの実装
以下のResidualBlockのforwardメソッドを完成させてください。このブロックは2つのconvレイヤーにGroupNormとGELUを適用し、最初の正規化の後にタイムステップ埋め込みを注入し、残差接続を加える必要があります。
class ResidualBlock(nn.Module):
    def __init__(self, in_ch, out_ch, t_dim):
        super().__init__()
        self.conv1 = nn.Conv2d(in_ch, out_ch, 3, padding=1)
        self.norm1 = nn.GroupNorm(8, out_ch)
        self.conv2 = nn.Conv2d(out_ch, out_ch, 3, padding=1)
        self.norm2 = nn.GroupNorm(8, out_ch)
        self.act = nn.GELU()
        self.time_proj = nn.Linear(t_dim, out_ch)
        self.res_conv = nn.Conv2d(in_ch, out_ch, 1) if in_ch != out_ch else nn.Identity()

    def forward(self, x, t_emb):
        # TODO: このメソッドを実装してください
        pass
Q1の解答を表示
def forward(self, x, t_emb):
    residual = self.res_conv(x)

    h = self.conv1(x)
    h = self.norm1(h)

    # タイムステップを注入: t_embをout_chに射影、ブロードキャスト用にリシェイプ、加算
    t = self.time_proj(t_emb)          # (B, out_ch)
    t = t[:, :, None, None]            # (B, out_ch, 1, 1)
    h = h + t

    h = self.act(h)

    h = self.conv2(h)
    h = self.norm2(h)
    h = self.act(h)

    return h + residual
解説:重要なポイント — (1) タイムステップは結合(concatenate)ではなく加算される、(2) (B, C, 1, 1)にリシェイプすることでH×W全体にブロードキャスト可能、(3) 注入はnorm1の後GELUの前に行う、(4) チャネル次元が異なる場合は残差に1×1 convを使用。
Q2: U-Netからスキップ接続を削除するとどうなりますか?
デコーダでスキップ接続を使用しない以下の修正版U-Netを考えてください:
# オリジナル(スキップ接続あり):
x = self.upsample(x)
x = torch.cat([x, skip], dim=1)  # スキップを結合
x = self.res_block(x, t_emb)

# 修正版(スキップ接続なし):
x = self.upsample(x)
# スキップ接続が削除されています!
x = self.res_block(x, t_emb)
デノイズ出力にはどのような影響がありますか?該当するものをすべて選んでください:
- A) 出力がぼやけ、細かい詳細が失われる
- B) 形状の不一致によりモデルがコンパイルに失敗する
- C) 学習損失が大幅に増加する
- D) 入力に関係なくモデルが同一の出力を生成する
Q2の解答を表示
AとCが正解です。
解説:(A) スキップ接続がなければ、デコーダはボトルネック情報(512チャネルの8×8)のみから64×64の詳細を再構築しなければなりません — 細かいテクスチャやエッジが失われ、ぼやけた出力になります。(B) res_blockのin_channelsを適切に調整すれば形状の不一致は起こりません。(C) 正解 — 再構築に使える情報が少なくなるため、予測とクリーン画像間のMSE損失が高くなります。(D) これは情報ボトルネックが極端な場合にのみ起こります。モデルはボトルネック特徴から大まかな構造は捉えられます。
Q3: 各U-Netレベルを通る出力形状を計算
以下のU-Net設定で、欠けているテンソル形状を埋めてください:
# 設定: in_channels=1, base_channels=32, image_size=32×32
# ダウンサンプリングにRearrange Poolingを使用

x = input                  # 形状: (B, 1, 32, 32)
x = init_conv(x)           # 形状: (B, 32, 32, 32)

# エンコーダレベル1
skip1, x = down1(x)        # skip1: (B, 32, 32, 32),  rearrange後のx: ???
x = proj1(x)               # 形状: ???

# エンコーダレベル2
skip2, x = down2(x)        # skip2: ???,  rearrange後のx: ???
x = proj2(x)               # 形状: ???

# ボトルネック
x = bottleneck(x)          # 形状: ???

# デコーダレベル2
x = upsample(x)            # 形状: ???
x = cat(x, skip2)          # 形状: ???
x = res_block(x)           # 形状: ???

# デコーダレベル1
x = upsample(x)            # 形状: ???
x = cat(x, skip1)          # 形状: ???
x = res_block(x)           # 形状: ???

x = final_conv(x)          # 形状: (B, 1, 32, 32)
Q3の解答を表示
x = input                  # (B, 1, 32, 32)
x = init_conv(x)           # (B, 32, 32, 32)

# エンコーダレベル1
skip1 = res1(x)            # skip1: (B, 32, 32, 32)
x = rearrange(skip1)       # (B, 128, 16, 16)      ← 32×4=128, 32/2=16
x = proj1(x)               # (B, 64, 16, 16)       ← 1×1 conv削減

# エンコーダレベル2
skip2 = res2(x)            # skip2: (B, 64, 16, 16)
x = rearrange(skip2)       # (B, 256, 8, 8)         ← 64×4=256, 16/2=8
x = proj2(x)               # (B, 128, 8, 8)         ← 1×1 conv削減

# ボトルネック
x = bottleneck(x)          # (B, 128, 8, 8)

# デコーダレベル2
x = upsample(x)            # (B, 128, 16, 16)       ← 空間×2
x = cat(x, skip2)          # (B, 192, 16, 16)       ← 128+64=192
x = res_block(x)           # (B, 64, 16, 16)        ← チャネルを削減

# デコーダレベル1
x = upsample(x)            # (B, 64, 32, 32)        ← 空間×2
x = cat(x, skip1)          # (B, 96, 32, 32)        ← 64+32=96
x = res_block(x)           # (B, 32, 32, 32)        ← チャネルを削減

x = final_conv(x)          # (B, 1, 32, 32)
解説:重要なパターン — Rearrange Poolingはチャネルを4倍に増やし、空間次元を半分にします。スキップと結合後のチャネル = アップサンプルのチャネル + スキップのチャネル。各レイヤーの正しいin_channelsを設定するために、これらを注意深く追跡してください。