1. はじめに:Diffusion Modelsの数学的基礎
この課は、DLIコース全体の中で最も難しいパートです。Denoising Diffusion Probabilistic Models(DDPM)の数学的基礎について深く学びます。これはHo et al.(2020)による元論文に基づいています。すべての現代的な拡散モデル(Stable Diffusion、DALL·E、Imagen)はこのフレームワークの上に構築されています。
前の課では、バックボーンアーキテクチャであるU-Netの構築を完了しました。ここでは、U-Netが何を学習するのか、どのように学習するのか、そしてなぜ動作するのかを正確に理解します。
試験のヒント: NVIDIA DLIの評価では、順方向拡散、逆方向サンプリング、および訓練ループをゼロから実装することが求められます。各数式とそれがPyTorchコードにどのように対応するかを徹底的に理解することが必須です——サンプルコードを実行するだけでは不十分です。
DDPM Overview — Two Processes
═════════════════════════════

  FORWARD DIFFUSION q(x_t | x_{t-1})         REVERSE DIFFUSION p_θ(x_{t-1} | x_t)
  ──────────────────────────────────         ───────────────────────────────────────

  x_0 ──► x_1 ──► x_2 ──►...──► x_T        x_T ──► x_{T-1} ──►...──► x_1 ──► x_0
  (clean)   +ε      +ε            (noise)   (noise)   U-Net     U-Net    (clean)

  ┌──────┐   ┌──────┐   ┌──────┐   ┌──────┐
  │ ████ │→  │ ▓▓▓▓ │→  │ ░░░░ │→  │ ···· │   Forward: ノイズを追加(固定、学習なし)
  │ ████ │   │ ▓▓▓▓ │   │ ░░░░ │   │ ···· │
  └──────┘   └──────┘   └──────┘   └──────┘
   t = 0      t = 100    t = 500    t = 1000

  ┌──────┐   ┌──────┐   ┌──────┐   ┌──────┐
  │ ···· │→  │ ░░░░ │→  │ ▓▓▓▓ │→  │ ████ │   Reverse: ノイズを除去(U-Netが学習)
  │ ···· │   │ ░░░░ │   │ ▓▓▓▓ │   │ ████ │
  └──────┘   └──────┘   └──────┘   └──────┘
   t = 1000   t = 500    t = 100    t = 0
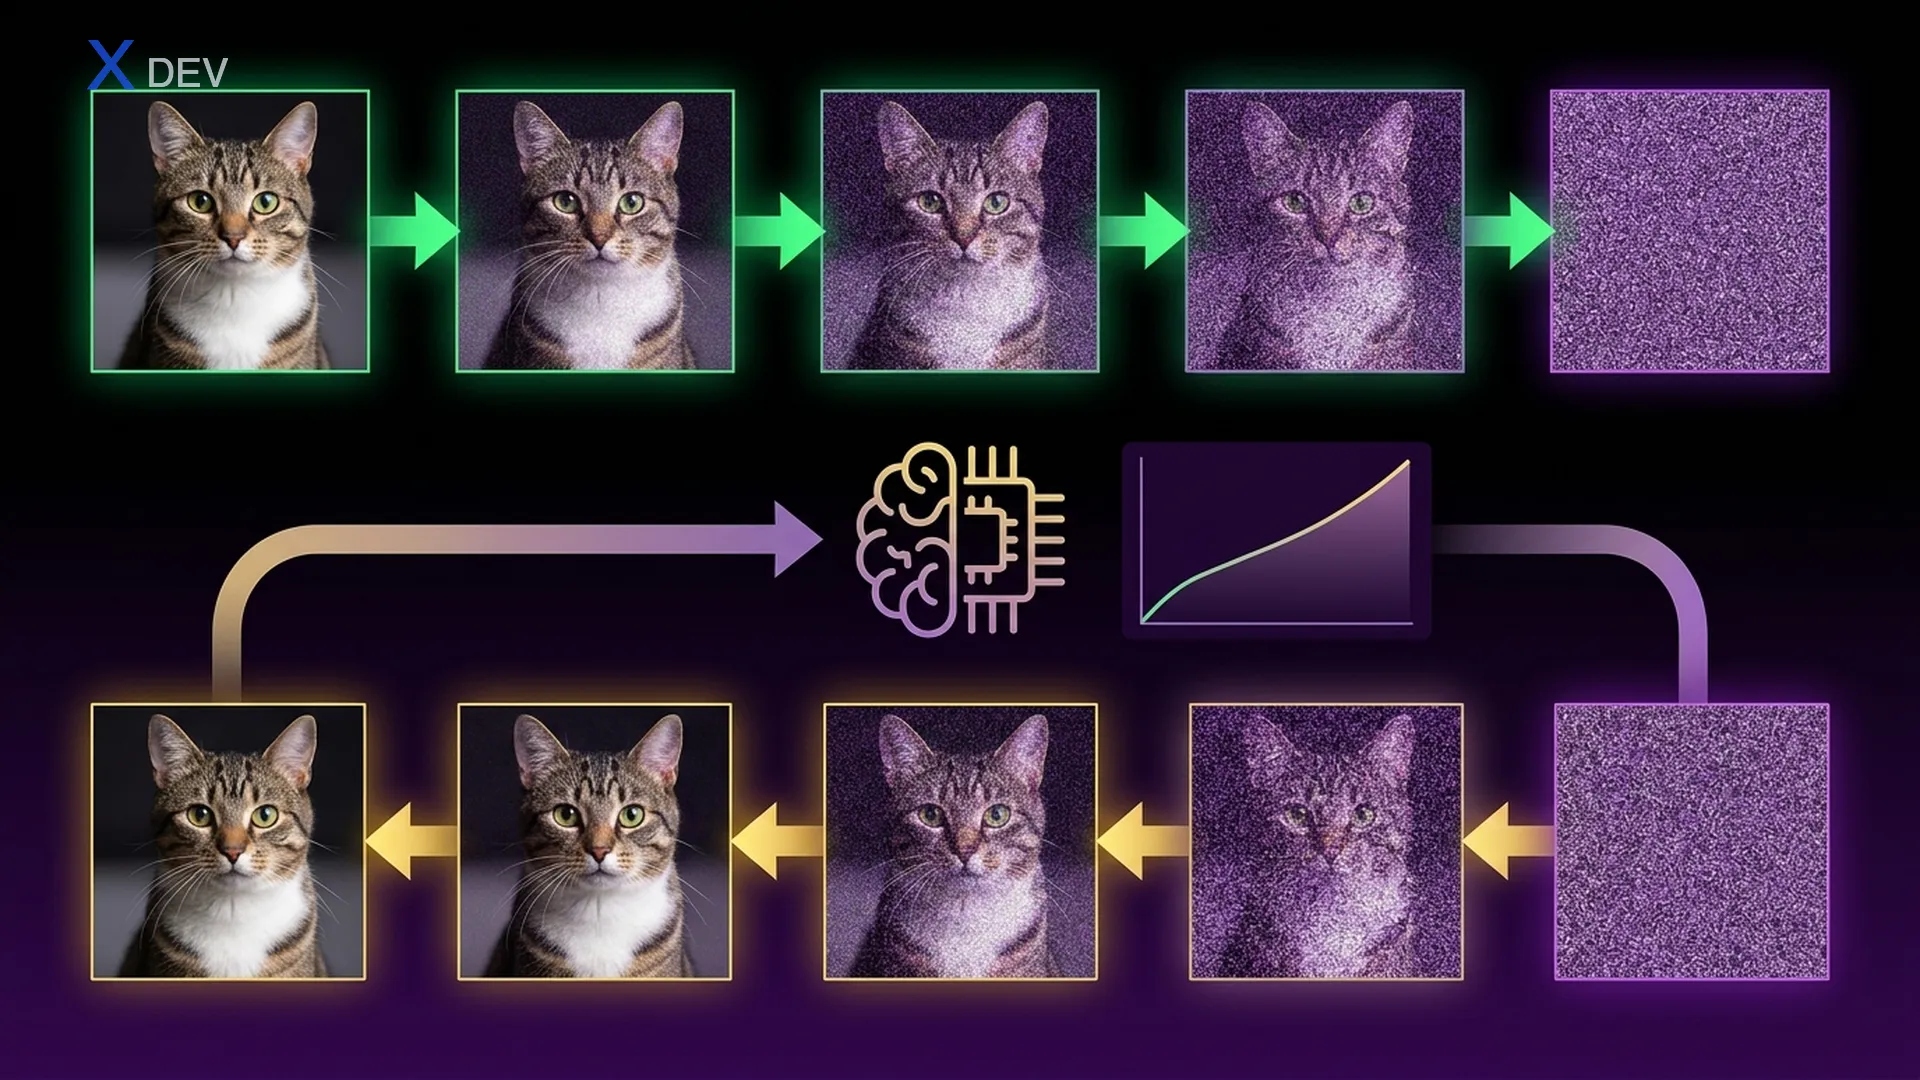
2. 順方向拡散プロセス
2.1 マルコフ連鎖の定式化
順方向拡散は、元の画像x_0にTタイムステップにわたってガウスノイズを徐々に追加するプロセスです。これはマルコフ連鎖であり、各ステップは直前のステップのみに依存します:
q(x_{1:T} | x_0) = ∏_{t=1}^{T} q(x_t | x_{t-1})
各タイムステップtでは、ガウス分布に従ってノイズを追加します:
q(x_t | x_{t-1}) = N(x_t;  √(1 - β_t) · x_{t-1},  β_t · I)
                         ▲ 平均                    ▲ 分散
ここでβ_t(ベータ)は分散スケジュールです。β_1 ≈ 0.0001からβ_T ≈ 0.02まで徐々に増加する小さな値で、各ステップで追加されるノイズの量を制御します。
| 記号 | 意味 | 典型的な値 |
|---|---|---|
| β_t | タイムステップtでの分散 | 0.0001 → 0.02 |
| α_t = 1 - β_t | 信号保持率 | 0.9999 → 0.98 |
| ᾱ_t = ∏_{s=1}^{t} α_s | 累積信号保持率 | ≈1.0 → ≈0.0 |
| T | 総タイムステップ数 | 1000(オリジナルDDPM) |
| ε | 標準ガウスノイズ | ε ~ N(0, I) |
2.2 閉形式:任意のタイムステップに直接ジャンプ
重要な知見:T個の順方向ステップを逐次的に実行する必要はありません。ガウス分布の加法性により、x_0から直接x_tを計算する閉形式の解が存在します:
q(x_t | x_0) = N(x_t;  √(ᾱ_t) · x_0,  (1 - ᾱ_t) · I)

ここで:
  ᾱ_t = α_1 · α_2 · ... · α_t = ∏_{s=1}^{t} (1 - β_s)
これは訓練において非常に重要です——連鎖全体をシミュレートせずに、任意のタイムステップtをサンプリングできます。
2.3 再パラメータ化トリック
上記の分布からx_tをサンプリングし、勾配を逆伝播するために、再パラメータ化トリックを使用します:
x_t = √(ᾱ_t) · x_0  +  √(1 - ᾱ_t) · ε      ここで ε ~ N(0, I)
      ────────────────   ──────────────────
      信号成分            ノイズ成分
この式は次のことを意味します:タイムステップtにおいて、画像x_tは元の画像(√ᾱ_tでスケーリング)と純粋なノイズ(√(1−ᾱ_t)でスケーリング)の線形混合です。tが小さいとき → ᾱ_t ≈ 1 → ほぼすべてが信号。tが大きいとき → ᾱ_t ≈ 0 → ほぼすべてがノイズ。
タイムステップごとの信号 vs ノイズ(T=1000、線形スケジュール)
══════════════════════════════════════════════════════════

  信号: √(ᾱ_t)         ノイズ: √(1-ᾱ_t)
  1.0 ┤████████░░░░░░        0.0 ┤░░░░░░░░████████
      │████████░░░░░░            │░░░░░░░░████████
      │██████░░░░░░░░            │░░░░░░██████████
      │████░░░░░░░░░░            │░░░░████████████
      │██░░░░░░░░░░░░            │░░██████████████
  0.0 ┤░░░░░░░░░░░░░░        1.0 ┤████████████████
      └──────────────            └────────────────
       t=0        t=T             t=0          t=T

  t ≈ T/2のとき:  信号 ≈ ノイズ(画像は半分きれい、半分ノイズ)
  t = Tのとき:    信号 ≈ 0     (純粋なガウスノイズ)
2.4 実装:forward_diffusion()
import torch
import torch.nn as nn
import math

def forward_diffusion(x_0, t, sqrt_alpha_bar, sqrt_one_minus_alpha_bar):
    """
    順方向拡散を適用: x_t = sqrt(alpha_bar_t) * x_0 + sqrt(1 - alpha_bar_t) * eps

    Args:
        x_0: (B, C, H, W) — クリーンな画像
        t: (B,) — タイムステップインデックス(0始まり)
        sqrt_alpha_bar: (T,) — 事前計算された√(ᾱ_t)
        sqrt_one_minus_alpha_bar: (T,) — 事前計算された√(1 - ᾱ_t)
    Returns:
        x_t: (B, C, H, W) — タイムステップtでのノイズ画像
        noise: (B, C, H, W) — 追加されたノイズ(損失計算に必要)
    """
    # ガウスノイズをサンプリング
    noise = torch.randn_like(x_0)

    # バッチ内の各サンプルの係数を取得
    # (B,) -> (B, 1, 1, 1) で (B, C, H, W) とのブロードキャスト用
    s_alpha = sqrt_alpha_bar[t].view(-1, 1, 1, 1)
    s_one_minus = sqrt_one_minus_alpha_bar[t].view(-1, 1, 1, 1)

    # 再パラメータ化: x_t = √(ᾱ_t) * x_0 + √(1-ᾱ_t) * ε
    x_t = s_alpha * x_0 + s_one_minus * noise

    return x_t, noise
試験のヒント:
.view(-1, 1, 1, 1)に注目してください。スカラー係数を取得して4Dテンソルとブロードキャストする際に必須のパターンです。リシェイプを忘れると形状の不一致が発生します。評価ではまさにこのポイントが頻繁にテストされます。
3. ノイズスケジューリング
3.1 線形スケジュール(オリジナルDDPM)
オリジナルのDDPM論文では線形スケジュールを使用しています:βはT = 1000ステップにわたり、β_1 = 0.0001からβ_T = 0.02まで線形に増加します。
def linear_beta_schedule(T, beta_start=1e-4, beta_end=0.02):
    """
    線形分散スケジュール: β_tはbeta_startからbeta_endまで線形に増加。
    オリジナルDDPM(Ho et al. 2020)。
    """
    return torch.linspace(beta_start, beta_end, T)


def precompute_schedule(betas):
    """ベータスケジュールからすべての係数を事前計算。"""
    alphas = 1.0 - betas                          # α_t = 1 - β_t
    alpha_bar = torch.cumprod(alphas, dim=0)       # ᾱ_t = ∏ α_s
    sqrt_alpha_bar = torch.sqrt(alpha_bar)         # √(ᾱ_t)
    sqrt_one_minus_alpha_bar = torch.sqrt(1.0 - alpha_bar)  # √(1 - ᾱ_t)
    sqrt_alpha = torch.sqrt(alphas)                # √(α_t)  — 逆方向ステップ用

    return {
        'betas': betas,
        'alphas': alphas,
        'alpha_bar': alpha_bar,
        'sqrt_alpha_bar': sqrt_alpha_bar,
        'sqrt_one_minus_alpha_bar': sqrt_one_minus_alpha_bar,
        'sqrt_alpha': sqrt_alpha,
    }

# 使用例
T = 1000
schedule = precompute_schedule(linear_beta_schedule(T))
3.2 コサインスケジュール(改良版DDPM)
線形スケジュールの問題点:ᾱ_tが中間で急速に低下 → 画像が早期に破壊され、情報損失が発生します。コサインスケジュール(Nichol & Dhariwal 2021)はᾱ_tをコサイン関数で設計することでこの問題を解決します——より滑らかな減衰で、特に高解像度画像に適しています。
def cosine_beta_schedule(T, s=0.008):
    """
    コサイン分散スケジュール(Nichol & Dhariwal 2021)。
    コサイン関数でalpha_barを直接設計し、betasを導出。
    's'オフセットはt=0付近でbetaが小さくなりすぎるのを防ぐ。
    """
    steps = torch.arange(T + 1, dtype=torch.float32)
    # f(t) = cos( (t/T + s) / (1+s) * π/2 )²
    f_t = torch.cos(((steps / T) + s) / (1 + s) * (math.pi / 2)) ** 2
    alpha_bar = f_t / f_t[0]  # alpha_bar[0] = 1になるよう正規化

    # alpha_barからbetasを導出: β_t = 1 - ᾱ_t / ᾱ_{t-1}
    betas = 1 - (alpha_bar[1:] / alpha_bar[:-1])
    betas = torch.clamp(betas, min=1e-5, max=0.999)  # 数値安定性

    return betas
| 特徴 | 線形スケジュール | コサインスケジュール |
|---|---|---|
| t=T/2でのᾱ_t | ≈ 0.05(ほぼ0) | ≈ 0.50(まだ信号あり) |
| 信号の破壊 | 速い、積極的 | 滑らか、緩やか |
| 高解像度画像 | 悪い(詳細が早期に失われる) | 大幅に改善 |
| 元論文 | DDPM(Ho 2020) | Improved DDPM(Nichol 2021) |
| Stable Diffusionでの使用 | なし | あり(変形版) |
| NVIDIA DLIの重点 | ラボで実装 | 概念を理解し比較 |
ᾱ_t 比較: 線形 vs コサイン(T=1000)
══════════════════════════════════════════

  ᾱ_t
  1.0 ┤C C C C L
      │C C C   L
  0.8 ┤  C C    L
      │    C     L
  0.6 ┤    C      L
      │     C      L
  0.4 ┤      C      L
      │       C      L
  0.2 ┤        C      L
      │         C C    L L
  0.0 ┤            C C C L L L L
      └─────────────────────────
       t=0    t=250   t=500  t=750  t=1000

  L = 線形スケジュール(中間で急速に低下)
  C = コサインスケジュール(滑らかな減衰、信号をより長く保持)

  ポイント: コサインは信号をより長く保持 → 生成品質が向上
試験のヒント: 「なぜコサインスケジュールは線形より優れているのか?」という質問が出ます。答え:コサインは中間のタイムステップで信号をより長く保持し、早期の情報破壊を防ぐためです。線形では、ᾱ_{T/2} ≈ 0.05であり、プロセスの中間地点で信号の95%がすでに失われています。
4. 逆方向拡散プロセス
4.1 目標:逆方向分布を学習する
逆方向拡散は反対のプロセスです——純粋なノイズx_T ~ N(0, I)から始めて、クリーンな画像x_0まで徐々にデノイジングします。これが学習の部分であり、U-Netは以下を学習します:
p_θ(x_{t-1} | x_t)  =  N(x_{t-1};  μ_θ(x_t, t),  σ²_t · I)
                              ▲ 予測された平均      ▲ 固定分散
平均μを直接予測する代わりに、DDPMはよりエレガントなアプローチを取ります:モデルは画像に追加されたノイズεを予測します。予測されたε̂から、平均を導出します:
μ_θ(x_t, t) = ────────── · ( x_t  −  ──────────── · ε_θ(x_t, t) )
                  1                      1 - α_t
               ───────                ──────────────
                √(α_t)                 √(1 - ᾱ_t)

コンパクト形式:
                    1              (1 - α_t)
μ_θ(x_t, t) = ───────── · (x_t − ─────────── · ε_θ(x_t, t))
                √(α_t)           √(1 - ᾱ_t)
4.2 サンプリングアルゴリズム
サンプリングアルゴリズムはx_Tからx_0まで逆方向に進みます:
アルゴリズム: DDPMサンプリング
════════════════════════
入力: 訓練済みモデル ε_θ、ノイズスケジュール {β_t, α_t, ᾱ_t}

1. x_T ~ N(0, I) をサンプリング           ← 純粋なノイズから開始
2. t = T, T-1, ..., 1 に対して:
   a. t > 1 の場合: z ~ N(0, I) をサンプリング
      それ以外:     z = 0                  ← 最終ステップではノイズなし
   b. ε̂ = ε_θ(x_t, t)                    ← U-Netがノイズを予測
   c. μ = (1/√α_t) · (x_t − ((1-α_t)/√(1-ᾱ_t)) · ε̂)
   d. x_{t-1} = μ + σ_t · z              ← 1ステップデノイズ
      ここで σ_t = √(β_t)                ← 簡略化された分散

3. x_0 を返す
逆方向プロセスの可視化
═════════════════════════════

  x_T(純粋なノイズ)               x_0(クリーンな画像)
  ┌──────────┐                  ┌──────────┐
  │ ·:·:·:·: │   U-Net × T     │ ████████ │
  │ :·:·:·:· │  ──────────►    │ ██    ██ │
  │ ·:·:·:·: │   反復的に       │ ██    ██ │
  │ :·:·:·:· │   デノイズ       │ ████████ │
  └──────────┘                  └──────────┘

  ステップごと(T=1000):
  t=1000      t=750       t=500       t=250       t=0
  ┌──────┐   ┌──────┐   ┌──────┐   ┌──────┐   ┌──────┐
  │ ···· │ → │ ░··░ │ → │ ░▓▓░ │ → │ ▓██▓ │ → │ ████ │
  │ ···· │   │ ·░░· │   │ ▓░░▓ │   │ █▓▓█ │   │ █  █ │
  │ ···· │   │ ·░░· │   │ ▓░░▓ │   │ █▓▓█ │   │ █  █ │
  │ ···· │   │ ░··░ │   │ ░▓▓░ │   │ ▓██▓ │   │ ████ │
  └──────┘   └──────┘   └──────┘   └──────┘   └──────┘
  ノイズのみ  構造が       形状が      詳細が     クリーン!
              出現         形成        鮮明化
4.3 実装:逆方向サンプリングループ
@torch.no_grad()
def sample_ddpm(model, shape, schedule, device='cuda'):
    """
    DDPMサンプリング: 純粋なノイズから画像を生成。

    Args:
        model: 訓練済みU-Netノイズ予測器 ε_θ
        shape: (B, C, H, W) — 出力形状
        schedule: 'betas', 'alphas', 'alpha_bar'等を含む辞書
        device: torchデバイス
    Returns:
        x_0: (B, C, H, W) — 生成された画像
    """
    T = len(schedule['betas'])
    betas = schedule['betas'].to(device)
    alphas = schedule['alphas'].to(device)
    alpha_bar = schedule['alpha_bar'].to(device)
    sqrt_alpha = schedule['sqrt_alpha'].to(device)
    sqrt_one_minus_alpha_bar = schedule['sqrt_one_minus_alpha_bar'].to(device)

    # ステップ1: 純粋なガウスノイズから開始
    x_t = torch.randn(shape, device=device)

    # ステップ2: t=T-1からt=0まで反復的にデノイズ
    for t in reversed(range(T)):
        t_batch = torch.full((shape[0],), t, device=device, dtype=torch.long)

        # (a) U-Netでノイズを予測
        eps_pred = model(x_t, t_batch)

        # (b) 予測された平均μ_θを計算
        #     μ = (1/√α_t) * (x_t - (1-α_t)/√(1-ᾱ_t) * ε̂)
        coeff_xt = 1.0 / sqrt_alpha[t]
        coeff_eps = (1.0 - alphas[t]) / sqrt_one_minus_alpha_bar[t]
        mu = coeff_xt * (x_t - coeff_eps * eps_pred)

        # (c) ノイズを追加(t=0を除く)
        if t > 0:
            sigma = torch.sqrt(betas[t])
            z = torch.randn_like(x_t)
            x_t = mu + sigma * z
        else:
            x_t = mu  # 最終ステップ: ノイズ追加なし

    return x_t
試験のヒント: サンプリングループで最もよくある2つのミス:(1)
@torch.no_grad()の付け忘れ → VRAMを3〜4倍消費しOOMクラッシュ。(2) t=0のステップでノイズを追加 → 出力画像がノイズだらけのまま。zを追加する前に必ずif t > 0を確認してください。
5. 訓練目標:簡略化ELBO損失
5.1 ELBOから簡略化損失へ
理論的には、DDPMは対数尤度の変分下界(ELBO)を最適化します。しかし、Ho et al.は実践では簡略化された損失の方がよく機能することを発見しました:
完全ELBO損失(理論的):
L_vlb = L_0 + L_1 + ... + L_{T-1} + L_T
      = ∑_t KL(q(x_{t-1}|x_t,x_0) || p_θ(x_{t-1}|x_t))

簡略化損失(実践的 — DDPM論文):
L_simple = E_{t ~ U{1,T}, x_0, ε} [ || ε − ε_θ(x_t, t) ||² ]

意味:
  - ランダムなタイムステップtをサンプリング
  - 順方向拡散でx_0からx_tを作成
  - U-Netがノイズを予測 ε̂ = ε_θ(x_t, t)
  - 損失 = 実際のノイズ(ε)と予測されたノイズ(ε̂)のMSE
これがまさにforward_diffusion()からnoiseを返す必要がある理由です——これが訓練の正解ラベルとして機能します。
5.2 訓練アルゴリズム
アルゴリズム: DDPM訓練
════════════════════════
収束するまで繰り返す:
  1. x_0 ~ q(x_0) をサンプリング         ← データセットからバッチ
  2. t ~ Uniform({1, ..., T}) をサンプリング ← サンプルごとにランダムなタイムステップ
  3. ε ~ N(0, I) をサンプリング            ← ターゲットノイズ
  4. x_t = √(ᾱ_t)·x_0 + √(1−ᾱ_t)·ε を計算  ← 順方向拡散
  5. ε̂ = ε_θ(x_t, t) を計算              ← U-Netがノイズを予測
  6. Loss = MSE(ε, ε̂)                    ← 実ノイズと予測ノイズを比較
  7. 逆伝播 & θを更新
5.3 実装:完全な訓練ループ
def train_ddpm(model, dataloader, schedule, epochs=100, lr=2e-4, device='cuda'):
    """
    完全なDDPM訓練ループ。

    Args:
        model: U-Netノイズ予測器
        dataloader: (images, labels)バッチを返す
        schedule: 事前計算されたノイズスケジュール辞書
        epochs: 訓練エポック数
        lr: 学習率
        device: torchデバイス
    """
    optimizer = torch.optim.Adam(model.parameters(), lr=lr)
    loss_fn = nn.MSELoss()
    T = len(schedule['betas'])

    sqrt_alpha_bar = schedule['sqrt_alpha_bar'].to(device)
    sqrt_one_minus_alpha_bar = schedule['sqrt_one_minus_alpha_bar'].to(device)

    model.train()
    for epoch in range(epochs):
        epoch_loss = 0.0
        for batch_idx, (x_0, _) in enumerate(dataloader):
            x_0 = x_0.to(device)
            B = x_0.shape[0]

            # ステップ2: ランダムなタイムステップをサンプリング
            t = torch.randint(0, T, (B,), device=device)

            # ステップ3-4: 順方向拡散(ノイズサンプリング + x_tの計算)
            x_t, noise = forward_diffusion(
                x_0, t, sqrt_alpha_bar, sqrt_one_minus_alpha_bar
            )

            # ステップ5: ノイズを予測
            noise_pred = model(x_t, t)

            # ステップ6: 損失を計算
            loss = loss_fn(noise_pred, noise)

            # ステップ7: 逆伝播
            optimizer.zero_grad()
            loss.backward()
            optimizer.step()

            epoch_loss += loss.item()

        avg_loss = epoch_loss / len(dataloader)
        if (epoch + 1) % 10 == 0:
            print(f"Epoch {epoch+1}/{epochs}, Loss: {avg_loss:.4f}")
| 訓練コンポーネント | 役割 | 対応するコード |
|---|---|---|
| データセットからのx_0 | クリーンな入力画像 | x_0 = batch[0].to(device) |
| t ~ Uniform | ランダムなタイムステップ | torch.randint(0, T, (B,)) |
| ε ~ N(0,I) | ターゲットノイズ | torch.randn_like(x_0) |
| 再パラメータ化によるx_t | ノイズ画像 | forward_diffusion(...) |
| ε_θ(x_t, t) | U-Netの予測 | model(x_t, t) |
| MSE(ε, ε̂) | 簡略化損失 | nn.MSELoss()(pred, target) |
試験のヒント: 評価では、訓練ループをゼロから書く必要があります。ステップの順序が重要です:順方向拡散 → 予測 → 損失 → 逆伝播。
optimizer.zero_grad()を間違った位置に置いたり、loss.backward()を忘れたりすると、モデルは学習せず——減点されます。
6. Classifier-Free Diffusion Guidance(CFG)
6.1 条件付き生成とCFG
基本のDDPMは無条件で画像を生成します。条件(クラスラベル、テキストプロンプト)に従って画像を生成するには、条件付き生成が必要です。Classifier-Free Guidance(CFG)は最もエレガントなアプローチです:
Classifier-Free Guidance
═════════════════════════

  訓練: モデルは条件cを受け取るが、確率p_uncondでランダムにc → ∅にドロップ
  ┌──────────────────────────────────────┐
  │  if random() < p_uncond (例: 0.1):   │
  │      c = ∅  (null / 空)              │    ← 10%が無条件
  │  ε̂ = ε_θ(x_t, t, c)                 │
  └──────────────────────────────────────┘

  推論: 条件付きと無条件の予測を組み合わせ
  ┌──────────────────────────────────────────────────────────────┐
  │  ε̂_uncond = ε_θ(x_t, t, ∅)           ← 無条件予測          │
  │  ε̂_cond   = ε_θ(x_t, t, c)           ← 条件付き予測        │
  │                                                              │
  │  ε̂_guided = ε̂_uncond + w · (ε̂_cond − ε̂_uncond)             │
  │              ▲                 ▲ ガイダンス方向               │
  │              ベースライン        スケールwで増幅              │
  └──────────────────────────────────────────────────────────────┘

  w = ガイダンススケール:
    w = 1.0  → 標準的な条件付き(ガイダンスなし)
    w = 7.5  → 一般的な値(Stable Diffusionのデフォルト)
    w = 20   → 非常に強いガイダンス → 忠実だが多様性が低い
    w = 0.0  → 純粋な無条件
6.2 ガイダンススケールのトレードオフ
| ガイダンススケール w | 品質 | 多様性 | 条件への忠実度 | ユースケース |
|---|---|---|---|---|
| 0.0 | 低い | 非常に高い | なし(無条件) | 探索 |
| 1.0 | 中程度 | 高い | 標準 | ガイダンスなし |
| 3.0 – 5.0 | 良い | 中程度 | 良い | バランスの取れた生成 |
| 7.0 – 8.5 | 非常に良い | 低め | 非常に良い | Stable Diffusionデフォルト |
| 15.0 – 20.0 | 過飽和 | 非常に低い | 過剰 | 芸術的、スタイライズド |
6.3 実装:CFG訓練とサンプリング
def train_ddpm_cfg(model, dataloader, schedule, epochs=100,
                   lr=2e-4, p_uncond=0.1, num_classes=10, device='cuda'):
    """
    Classifier-Free GuidanceによるDDPM訓練。
    モデルは(x_t, t, class_label)を入力として受け取る。
    訓練中、class_labelをランダムにnull_classに置き換える。
    """
    optimizer = torch.optim.Adam(model.parameters(), lr=lr)
    loss_fn = nn.MSELoss()
    T = len(schedule['betas'])
    null_class = num_classes  # num_classesを「クラスなし」トークンとして使用

    sqrt_ab = schedule['sqrt_alpha_bar'].to(device)
    sqrt_omab = schedule['sqrt_one_minus_alpha_bar'].to(device)

    model.train()
    for epoch in range(epochs):
        for x_0, labels in dataloader:
            x_0, labels = x_0.to(device), labels.to(device)
            B = x_0.shape[0]

            # ランダムなタイムステップ
            t = torch.randint(0, T, (B,), device=device)

            # CFG: 条件をランダムにドロップ
            mask = torch.rand(B, device=device) < p_uncond
            labels_cfg = labels.clone()
            labels_cfg[mask] = null_class  # nullトークンに置き換え

            # 順方向拡散
            x_t, noise = forward_diffusion(x_0, t, sqrt_ab, sqrt_omab)

            # ノイズを予測(nullの可能性があるラベルで条件付き)
            noise_pred = model(x_t, t, labels_cfg)

            # 損失
            loss = loss_fn(noise_pred, noise)
            optimizer.zero_grad()
            loss.backward()
            optimizer.step()


@torch.no_grad()
def sample_ddpm_cfg(model, shape, schedule, class_label, guidance_scale=7.5,
                    num_classes=10, device='cuda'):
    """
    Classifier-Free GuidanceによるDDPMサンプリング。

    ε̂_guided = ε̂_uncond + w * (ε̂_cond - ε̂_uncond)

    Args:
        class_label: (B,) — 各サンプルのターゲットクラス
        guidance_scale: w — 高いほど条件に忠実
    """
    T = len(schedule['betas'])
    betas = schedule['betas'].to(device)
    alphas = schedule['alphas'].to(device)
    alpha_bar = schedule['alpha_bar'].to(device)
    sqrt_alpha = schedule['sqrt_alpha'].to(device)
    sqrt_omab = schedule['sqrt_one_minus_alpha_bar'].to(device)
    null_class = num_classes

    x_t = torch.randn(shape, device=device)
    class_label = class_label.to(device)
    null_label = torch.full_like(class_label, null_class)

    for t in reversed(range(T)):
        t_batch = torch.full((shape[0],), t, device=device, dtype=torch.long)

        # 2回のフォワードパス: 条件付き + 無条件
        eps_cond = model(x_t, t_batch, class_label)    # ε_θ(x_t, t, c)
        eps_uncond = model(x_t, t_batch, null_label)   # ε_θ(x_t, t, ∅)

        # CFG公式
        eps_guided = eps_uncond + guidance_scale * (eps_cond - eps_uncond)

        # 平均を計算
        coeff_xt = 1.0 / sqrt_alpha[t]
        coeff_eps = (1.0 - alphas[t]) / sqrt_omab[t]
        mu = coeff_xt * (x_t - coeff_eps * eps_guided)

        # デノイズステップ
        if t > 0:
            sigma = torch.sqrt(betas[t])
            x_t = mu + sigma * torch.randn_like(x_t)
        else:
            x_t = mu

    return x_t
試験のヒント: CFGにはサンプリングステップごとに2回のフォワードパスが必要です——条件付き1回と無条件1回。そのため、CFGを使ったサンプリングは2倍遅くなります。DLIラボでフォワードパスを1回しか実行しないと、ガイダンスは効果がなく——出力は無条件と同じになります。
7. チートシート:DDPM公式のまとめ
| 公式 | 意味 | 使用場面 |
|---|---|---|
| x_t = √ᾱ_t · x_0 + √(1−ᾱ_t) · ε | 順方向拡散(閉形式) | 訓練:x_0からx_tを作成 |
| ε̂ = ε_θ(x_t, t) | U-Netがノイズを予測 | 訓練:出力 | サンプリング:デノイズ |
| L = MSE(ε, ε̂) | 簡略化ELBO損失 | 訓練:損失計算 |
| μ = (1/√α_t)(x_t − (1−α_t)/√(1−ᾱ_t) · ε̂) | 逆方向ステップの予測平均 | サンプリング:μ_θを計算 |
| x_{t−1} = μ + √β_t · z | サンプリングステップ(t=0のときz=0) | サンプリング:1ステップデノイズ |
| ε̂ = ε̂_∅ + w(ε̂_c − ε̂_∅) | CFGガイダンス公式 | 条件付きサンプリング |
DDPMパイプラインのまとめ
═════════════════════

  ┌─────────────────────────────────────────────────────────┐
  │                       訓練                              │
  │                                                         │
  │  x_0 ──[forward_diffusion]──► x_t ──[U-Net]──► ε̂      │
  │   │         ↑                                    │      │
  │   └─── t,ε (ランダム) ─────────────── MSE(ε, ε̂)  │      │
  │                                         │               │
  │                                      逆伝播             │
  └─────────────────────────────────────────────────────────┘

  ┌─────────────────────────────────────────────────────────┐
  │                    サンプリング                          │
  │                                                         │
  │  x_T ──► [U-Net] ──► ε̂ ──► μ_θ ──► x_{T-1}           │
  │                                       │                 │
  │         [U-Net] ──► ε̂ ──► μ_θ ──► x_{T-2}             │
  │                                       │                 │
  │         ...T回繰り返し...              │                 │
  │                                       ▼                 │
  │                                      x_0 (生成完了!)   │
  └─────────────────────────────────────────────────────────┘

  ┌─────────────────────────────────────────────────────────┐
  │                  CFGサンプリング                         │
  │                                                         │
  │  各ステップtで:                                         │
  │    ε̂_∅ = UNet(x_t, t, null)      ← 無条件              │
  │    ε̂_c = UNet(x_t, t, class)     ← 条件付き            │
  │    ε̂ = ε̂_∅ + w · (ε̂_c − ε̂_∅)   ← ガイド付き予測     │
  │    x_{t-1} = denoise(x_t, ε̂)                          │
  └─────────────────────────────────────────────────────────┘
8. 練習問題
5つのコーディング問題です——答えを確認する前に自分で実装してみてください。
Q1: forward_diffusion(x_0, t, noise_schedule) → x_t, noiseを実装
画像のバッチx_0、タイムステップのテンソルt、事前計算された係数を含む辞書noise_scheduleを受け取るforward_diffusion関数を書いてください。x_tと使用されたノイズεを返してください。
def forward_diffusion(x_0, t, noise_schedule):
    """
    Args:
        x_0: (B, C, H, W) — クリーンな画像、[-1, 1]に正規化済み
        t: (B,) — 整数のタイムステップインデックス
        noise_schedule: 以下のキーを持つ辞書:
            'sqrt_alpha_bar': (T,) テンソル
            'sqrt_one_minus_alpha_bar': (T,) テンソル
    Returns:
        x_t: (B, C, H, W) — ノイズ画像
        noise: (B, C, H, W) — 追加されたガウスノイズ
    """
    # TODO: 再パラメータ化トリックを使って順方向拡散を実装
    pass
回答Q1を表示
def forward_diffusion(x_0, t, noise_schedule):
    sqrt_alpha_bar = noise_schedule['sqrt_alpha_bar']
    sqrt_one_minus_alpha_bar = noise_schedule['sqrt_one_minus_alpha_bar']

    # ノイズ ε ~ N(0, I) をサンプリング
    noise = torch.randn_like(x_0)

    # バッチの係数を取得しブロードキャスト用にリシェイプ
    # (B,) → (B, 1, 1, 1)
    s_ab = sqrt_alpha_bar[t].view(-1, 1, 1, 1)
    s_omab = sqrt_one_minus_alpha_bar[t].view(-1, 1, 1, 1)

    # 再パラメータ化トリック:
    # x_t = √(ᾱ_t) * x_0 + √(1 - ᾱ_t) * ε
    x_t = s_ab * x_0 + s_omab * noise

    return x_t, noise
解説:3つの重要なステップがあります:(1) torch.randn_likeでx_0と同じ形状のノイズをサンプリング、(2) インデックスtで係数を取得し.view(-1, 1, 1, 1)で4Dブロードキャスト用にリシェイプ、(3) 再パラメータ化トリックを適用。ノイズも返す必要があることに注意してください。訓練ループでMSE損失のターゲットとして必要になるためです。
Q2: 逆方向拡散サンプリングループを実装
純粋なノイズから逆方向拡散ステップを反復することで新しい画像を生成するsample_ddpm関数を書いてください。モデルはすでに訓練済みです。
@torch.no_grad()
def sample_ddpm(model, n_samples, img_channels, img_size, schedule, device):
    """
    Args:
        model: 訓練済みU-Net、(x_t, t_batch) → 予測ノイズ
        n_samples: int — 生成する画像の数
        img_channels: int — 例: MNISTなら1
        img_size: int — 例: 28
        schedule: 'betas', 'alphas', 'alpha_bar',
                  'sqrt_alpha', 'sqrt_one_minus_alpha_bar'を含む辞書
    Returns:
        images: (n_samples, C, H, W) — 生成された画像
    """
    # TODO: 完全なDDPMサンプリングアルゴリズムを実装
    pass
回答Q2を表示
@torch.no_grad()
def sample_ddpm(model, n_samples, img_channels, img_size, schedule, device):
    T = len(schedule['betas'])
    betas = schedule['betas'].to(device)
    alphas = schedule['alphas'].to(device)
    sqrt_alpha = schedule['sqrt_alpha'].to(device)
    sqrt_omab = schedule['sqrt_one_minus_alpha_bar'].to(device)

    shape = (n_samples, img_channels, img_size, img_size)

    # 純粋なノイズ x_T ~ N(0, I) から開始
    x_t = torch.randn(shape, device=device)

    for t in reversed(range(T)):
        t_batch = torch.full((n_samples,), t, device=device, dtype=torch.long)

        # U-Netがノイズを予測
        eps_pred = model(x_t, t_batch)

        # 予測された平均を計算:
        # μ_θ = (1/√α_t) * (x_t − ((1−α_t) / √(1−ᾱ_t)) * ε̂)
        coeff_xt = 1.0 / sqrt_alpha[t]
        coeff_eps = (1.0 - alphas[t]) / sqrt_omab[t]
        mu = coeff_xt * (x_t - coeff_eps * eps_pred)

        # x_{t-1}をサンプリング: t > 0ならノイズを追加、それ以外は平均を返す
        if t > 0:
            sigma = torch.sqrt(betas[t])
            z = torch.randn_like(x_t)
            x_t = mu + sigma * z
        else:
            x_t = mu

    return x_t
解説:サンプリングループはt=T-1からt=0まで逆方向に実行されます。各ステップで:(1) U-Netがノイズε̂を予測、(2) DDPMの公式で平均μ_θを計算、(3) t > 0ならノイズzを追加(確率的サンプリング)。重要:@torch.no_grad()を使用して1000ステップにわたる勾配蓄積を防ぎます——これをしないとOOMが発生します。t=0のステップは最終出力なのでノイズを追加しません。
Q3: デバッグ — モデルが黒い画像を出力する
ある学生が逆方向サンプリングを実装しましたが、結果が常に黒い画像(ほぼ0)になります。以下のコードのバグを見つけてください:
@torch.no_grad()
def buggy_sample(model, shape, schedule, device):
    T = len(schedule['betas'])
    betas = schedule['betas'].to(device)
    alphas = schedule['alphas'].to(device)
    sqrt_alpha = schedule['sqrt_alpha'].to(device)
    sqrt_omab = schedule['sqrt_one_minus_alpha_bar'].to(device)

    x_t = torch.randn(shape, device=device)

    for t in reversed(range(T)):
        t_batch = torch.full((shape[0],), t, device=device, dtype=torch.long)
        eps_pred = model(x_t, t_batch)

        # バグはここにあります — 見つけてください!
        coeff_xt = 1.0 / sqrt_alpha[t]
        coeff_eps = (1.0 - alphas[t]) / sqrt_omab[t]
        mu = coeff_xt * (x_t + coeff_eps * eps_pred)  # line A

        if t > 0:
            sigma = torch.sqrt(betas[t])
            x_t = mu + sigma * torch.randn_like(x_t)
        else:
            x_t = mu

    return x_t
回答Q3を表示
バグ: μを計算する行で、coeff_eps * eps_predの前に−ではなく+を使用しています。
# バグ(line A):
mu = coeff_xt * (x_t + coeff_eps * eps_pred)   # ← 誤り: -ではなく+

# 修正:
mu = coeff_xt * (x_t - coeff_eps * eps_pred)   # ← 正しい: ノイズを引く
解説:DDPMの逆方向平均の公式はμ = (1/√α_t)(x_t − ((1−α_t)/√(1−ᾱ_t)) · ε̂)です。マイナス記号が「デノイジング」の本質です——予測されたノイズを引きます。プラス記号を使うと、ノイズを除去するのではなくさらにノイズを追加してしまいます → 1000ステップで画像が中和され(0付近で振動) → 出力がほぼ0(黒)になります。これは微妙なバグです。コードはエラーなく実行され、出力の形状も正しいですが——値だけが間違っています。
Q4: ガイダンススケール付きCFGサンプリングを実装
モデルは条件ドロップアウトで訓練済みです。Classifier-Free Guidanceによるサンプリング関数を書いてください。
@torch.no_grad()
def sample_cfg(model, shape, schedule, class_labels, guidance_scale,
               num_classes, device):
    """
    Args:
        model: シグネチャ model(x_t, t, class_label) → noise のU-Net
        shape: (B, C, H, W)
        class_labels: (B,) — ターゲットクラスインデックス
        guidance_scale: float w — 例: 7.5
        num_classes: int — 総クラス数(null_class = num_classes)
    Returns:
        images: (B, C, H, W)
    """
    # TODO: CFGサンプリングを実装
    # ヒント: ステップごとに2回のフォワードパス — 条件付きと無条件
    pass
回答Q4を表示
@torch.no_grad()
def sample_cfg(model, shape, schedule, class_labels, guidance_scale,
               num_classes, device):
    T = len(schedule['betas'])
    betas = schedule['betas'].to(device)
    alphas = schedule['alphas'].to(device)
    sqrt_alpha = schedule['sqrt_alpha'].to(device)
    sqrt_omab = schedule['sqrt_one_minus_alpha_bar'].to(device)
    null_class = num_classes

    x_t = torch.randn(shape, device=device)
    class_labels = class_labels.to(device)
    null_labels = torch.full_like(class_labels, null_class)

    for t in reversed(range(T)):
        t_batch = torch.full((shape[0],), t, device=device, dtype=torch.long)

        # 2回のフォワードパス
        eps_uncond = model(x_t, t_batch, null_labels)   # ε_θ(x_t, t, ∅)
        eps_cond = model(x_t, t_batch, class_labels)    # ε_θ(x_t, t, c)

        # CFG: ε̂ = ε_uncond + w * (ε_cond - ε_uncond)
        eps_guided = eps_uncond + guidance_scale * (eps_cond - eps_uncond)

        # ガイド付きノイズ予測による逆方向ステップ
        coeff_xt = 1.0 / sqrt_alpha[t]
        coeff_eps = (1.0 - alphas[t]) / sqrt_omab[t]
        mu = coeff_xt * (x_t - coeff_eps * eps_guided)

        if t > 0:
            sigma = torch.sqrt(betas[t])
            x_t = mu + sigma * torch.randn_like(x_t)
        else:
            x_t = mu

    return x_t
解説:CFGサンプリングは標準的なサンプリングと異なり、各ステップで2回のU-Netフォワードパスを実行します:(1) null_classによる無条件、(2) 実際のクラスによる条件付き。そして組み合わせ:ε̂ = ε̂_∅ + w·(ε̂_c − ε̂_∅)。w=1.0のとき → 標準的な条件付き(ガイダンスなし)。w>1.0のとき → 条件付きと無条件の差を増幅 → より鮮明な画像だが多様性は低下。null_classは通常 = num_classes(実クラス外のインデックス)です。
Q5: 線形 vs コサインスケジュールの比較 — ᾱ_tが0.01を下回るのはいつ?
T=1000で、各スケジュールでᾱ_tが0.01を下回るタイムステップを計算して比較するコードを書いてください。これは生成品質にどのような意味がありますか?
def compare_schedules(T=1000):
    """
    線形とコサインの両スケジュールでalpha_barを計算。
    各スケジュールでalpha_barが0.01を下回るタイムステップを求める。
    比較結果を出力。
    """
    # TODO: linear_beta_schedule()とcosine_beta_schedule()を使って実装
    pass
回答Q5を表示
import torch
import math

def linear_beta_schedule(T, beta_start=1e-4, beta_end=0.02):
    return torch.linspace(beta_start, beta_end, T)

def cosine_beta_schedule(T, s=0.008):
    steps = torch.arange(T + 1, dtype=torch.float32)
    f_t = torch.cos(((steps / T) + s) / (1 + s) * (math.pi / 2)) ** 2
    alpha_bar = f_t / f_t[0]
    betas = 1 - (alpha_bar[1:] / alpha_bar[:-1])
    return torch.clamp(betas, min=1e-5, max=0.999)

def compare_schedules(T=1000):
    # 線形スケジュール
    betas_lin = linear_beta_schedule(T)
    alphas_lin = 1.0 - betas_lin
    alpha_bar_lin = torch.cumprod(alphas_lin, dim=0)

    # コサインスケジュール
    betas_cos = cosine_beta_schedule(T)
    alphas_cos = 1.0 - betas_cos
    alpha_bar_cos = torch.cumprod(alphas_cos, dim=0)

    # alpha_bar < 0.01となるポイントを探す
    threshold = 0.01
    t_lin = (alpha_bar_lin < threshold).nonzero(as_tuple=True)[0][0].item()
    t_cos = (alpha_bar_cos < threshold).nonzero(as_tuple=True)[0][0].item()

    print(f"線形スケジュール: ᾱ_t < {threshold} at t = {t_lin}")
    print(f"  ᾱ at t=250: {alpha_bar_lin[250]:.4f}")
    print(f"  ᾱ at t=500: {alpha_bar_lin[500]:.4f}")
    print(f"  ᾱ at t=750: {alpha_bar_lin[750]:.6f}")
    print()
    print(f"コサインスケジュール: ᾱ_t < {threshold} at t = {t_cos}")
    print(f"  ᾱ at t=250: {alpha_bar_cos[250]:.4f}")
    print(f"  ᾱ at t=500: {alpha_bar_cos[500]:.4f}")
    print(f"  ᾱ at t=750: {alpha_bar_cos[750]:.4f}")
    print()
    print(f"差分: コサインは{t_cos - t_lin}タイムステップ長く信号を保持")

compare_schedules()
# 出力(概算):
# 線形スケジュール: ᾱ_t < 0.01 at t ≈ 650
#   ᾱ at t=250: 0.6766
#   ᾱ at t=500: 0.0473
#   ᾱ at t=750: 0.000014
#
# コサインスケジュール: ᾱ_t < 0.01 at t ≈ 940
#   ᾱ at t=250: 0.8536
#   ᾱ at t=500: 0.5000
#   ᾱ at t=750: 0.1464
#
# 差分: コサインは約290タイムステップ長く信号を保持
解説:線形スケジュールは信号を早期に破壊します——ᾱ_t < 0.01はt≈650付近で、連鎖の最後の35%がほぼ無駄(ノイズが実質的に純粋)であることを意味します。コサインはt≈940までᾱ_t > 0.01を保持し、すべてのTステップをより効率的に活用します。特に注目すべき点:t=500(連鎖の中間地点)で、線形はᾱ≈0.05(信号5%)しかないのに対し、コサインはᾱ≈0.50(信号50%)を保持しています。これがコサインがより良い生成品質を生む理由を説明しています——モデルはより多くのタイムステップから有用な勾配を得られ、純粋なノイズ領域での無駄な計算がありません。
試験のヒント: DLIの評価では、ノイズスケジュールに関する質問で通常、あるスケジュールがなぜ優れているかの説明が求められます。重要な洞察:良いスケジュールは信号の破壊をすべてのタイムステップに均等に分散すべきです——速すぎず(線形)、遅すぎず。コサインはβ_tではなくᾱ_tを直接設計することでこれを実現しています。