1. はじめに:クラスラベルからテキストプロンプトへ
前回のレッスンでは、クラスラベル(数字0〜9)を使ったClassifier-Free Guidance(CFG)を実装しました。しかし、Stable Diffusionはクラスラベルを使用しません。自由形式のテキストプロンプトを使用します。では、「a photo of a cat」をU-Netが理解できるテンソルにどうやって変換するのでしょうか?
その答えはCLIP(Contrastive Language-Image Pretraining)にあります。これは2021年にOpenAIが発表した、言語と画像をつなぐブリッジモデルです。これはDiffusion Modelsセクションの最後のレッスンであり、これまで学んだすべての知識を組み合わせて完全なテキストから画像へのパイプラインを構築します。
試験のヒント: DLI評価S-FX-14では、U-Net、DDPM、CFG、テキスト条件付けを組み合わせて完全なパイプラインを構築することが求められます。このレッスンは「総合まとめ」です。レッスン3〜4の各コンポーネントを十分に理解し、レッスン5でそれらを接続すれば、評価をより速く完了できます。
Roadmap: Class Label → Text Prompt Conditioning
════════════════════════════════════════════════

  Lesson 3: U-Net backbone          → Denoiserアーキテクチャ
  Lesson 4: DDPM + CFG              → クラスラベルによる学習とサンプリング
  Lesson 5: CLIP + Cross-Attention  → テキストから画像へのパイプライン ← 現在のレッスン
        │
        ▼
  ┌──────────────────────────────────────────────────────────┐
  │  "a sunset over mountains"                               │
  │         │                                                │
  │         ▼                                                │
  │   ┌──────────┐   ┌──────────────────┐   ┌──────────┐   │
  │   │   CLIP   │──►│  Cross-Attention  │──►│  U-Net   │   │
  │   │ Encoder  │   │  (K, V from text) │   │ Denoise  │   │
  │   └──────────┘   └──────────────────┘   └──────────┘   │
  │                                              │          │
  │                                              ▼          │
  │                                        [ 🖼️ Image ]     │
  └──────────────────────────────────────────────────────────┘
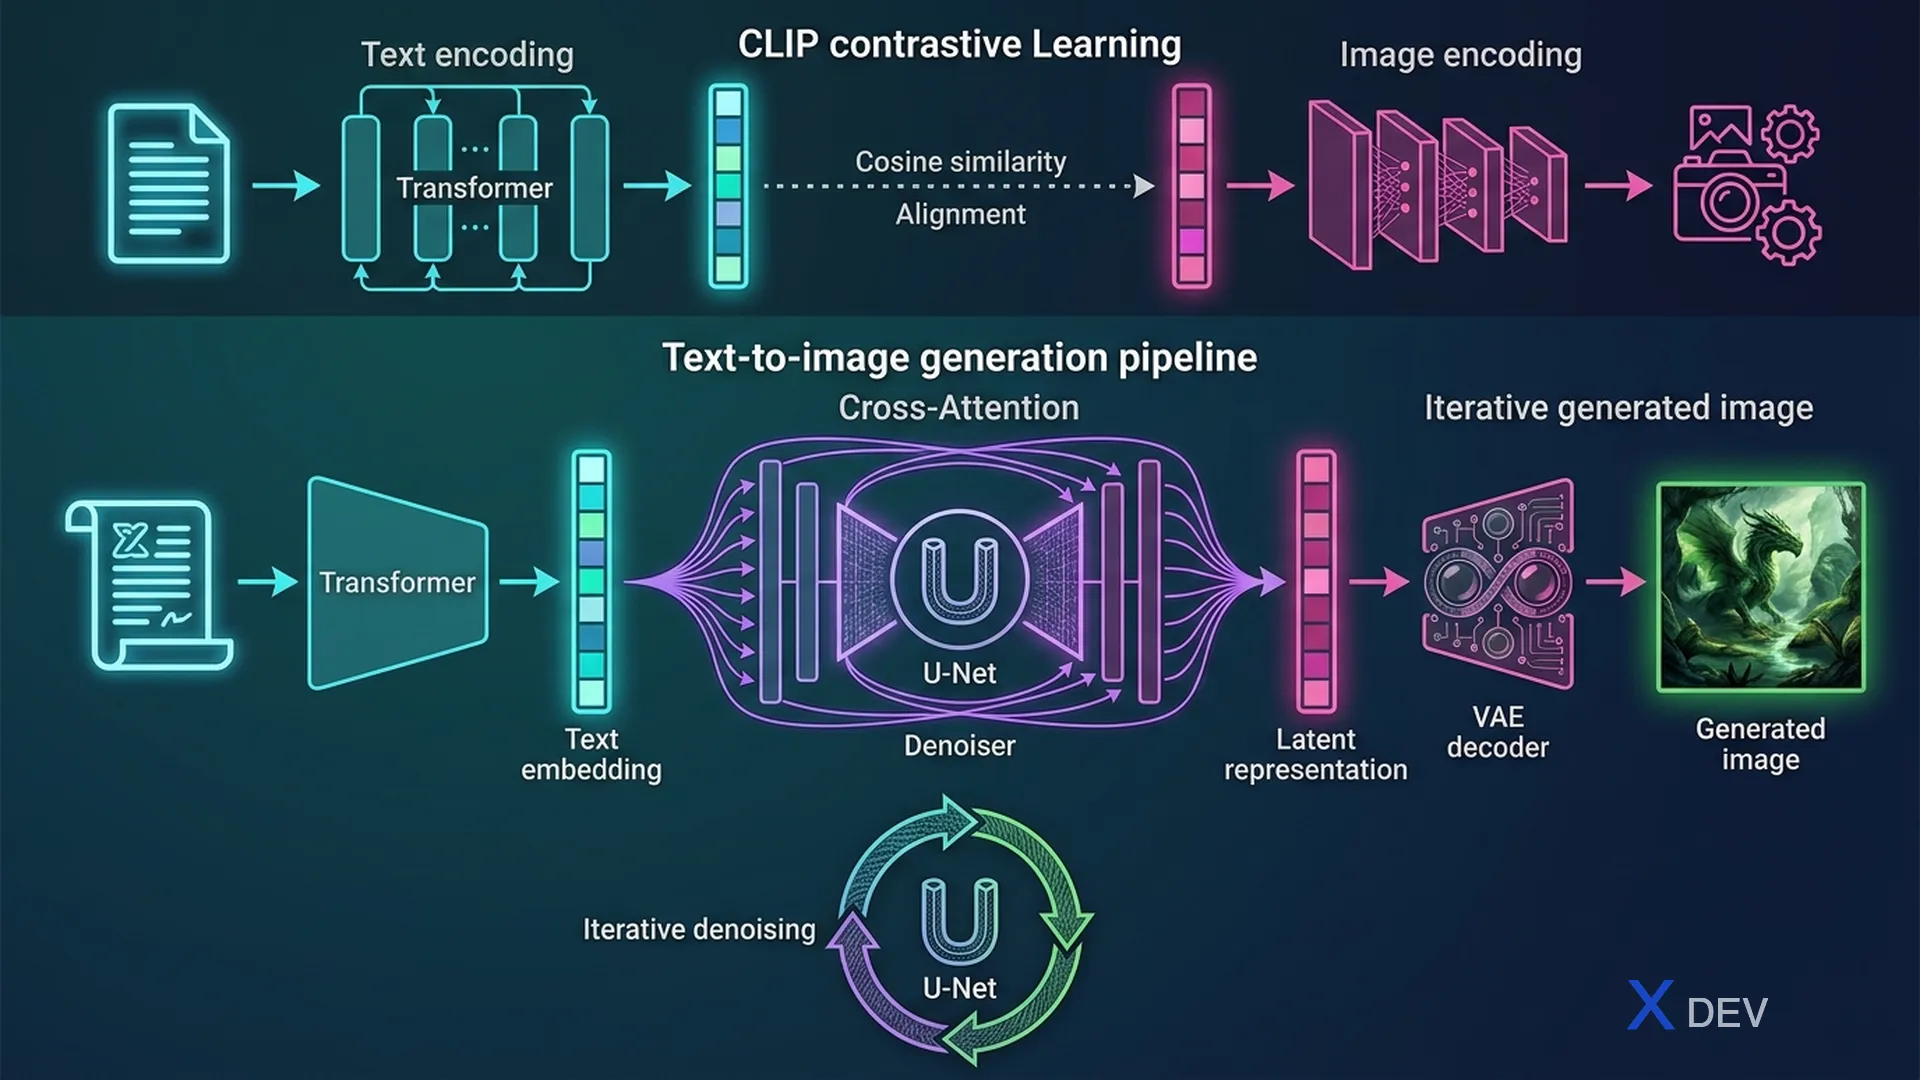
2. CLIP — Contrastive Language-Image Pretraining
2.1 Dual-Encoderアーキテクチャ
CLIPは、インターネットから収集した4億組の(テキスト、画像)ペアで同時に学習された2つのエンコーダで構成されています:
- Text Encoder:Transformer(GPTと同様) — テキストを受け取り、埋め込みベクトル(512次元または768次元)を出力します
- Image Encoder:ViT(Vision Transformer)またはResNet — 画像を受け取り、同じ次元の埋め込みを出力します
重要なポイント:両方のエンコーダは同じベクトル空間に埋め込みを出力します。これにより、コサイン類似度を使ってテキストと画像を直接比較できます。
CLIP Architecture — Dual Encoder
═════════════════════════════════

  TEXT BRANCH                          IMAGE BRANCH
  ───────────                          ────────────

  "a photo of    ┌───────────────┐     ┌─────┐   ┌───────────────┐
   a cat"    ──► │ Text Encoder  │     │ 🖼️  │──►│ Image Encoder │
                 │ (Transformer) │     │     │   │ (ViT / ResNet)│
                 └───────┬───────┘     └─────┘   └───────┬───────┘
                         │                                │
                         ▼                                ▼
                  ┌──────────────┐                 ┌──────────────┐
                  │ Text Embed.  │                 │ Image Embed. │
                  │ (768-dim)    │                 │ (768-dim)    │
                  └──────┬───────┘                 └──────┬───────┘
                         │                                │
                         └────────────┬───────────────────┘
                                      │
                                      ▼
                              ┌───────────────┐
                              │    Cosine      │
                              │  Similarity    │
                              │  sim(t, i)     │
                              └───────────────┘

  学習(4億組の画像-テキストペア):
  ┌──────────────────────────────────────────────────────┐
  │  sim(text_i, image_i) を最大化    ← 一致するペア      │
  │  sim(text_i, image_j) を最小化    ← 一致しないペア    │
  └──────────────────────────────────────────────────────┘
2.2 対照損失(Contrastive Loss)
CLIPはN×Nの類似度行列に対する対称交差エントロピー損失を使用します。N組の(テキスト、画像)ペアのバッチでは:
Contrastive Loss — 類似度行列
═════════════════════════════════════

  バッチ N = 4 ペア(テキスト、画像):

              image_0   image_1   image_2   image_3
            ┌─────────┬─────────┬─────────┬─────────┐
  text_0    │  0.95 ✓ │  0.12   │  0.08   │  0.03   │
            ├─────────┼─────────┼─────────┼─────────┤
  text_1    │  0.10   │  0.91 ✓ │  0.15   │  0.07   │
            ├─────────┼─────────┼─────────┼─────────┤
  text_2    │  0.05   │  0.11   │  0.93 ✓ │  0.09   │
            ├─────────┼─────────┼─────────┼─────────┤
  text_3    │  0.08   │  0.06   │  0.12   │  0.89 ✓ │
            └─────────┴─────────┴─────────┴─────────┘

  目標:対角線(✓)→ 高く、それ以外 → 低く

  Loss = (CE_rows + CE_cols) / 2
       = cross_entropy(logits, labels)(両方向)

  logits = temperature * text_embeds @ image_embeds.T
  labels = [0, 1, 2, ..., N-1]   ← 恒等マッチング
Temperatureパラメータ(学習可能、初期値 ≈ 0.07)は分布のシャープさを制御します。Temperature が低いほど、正例と負例の区別がより明確になります。
| コンポーネント | 詳細 | CLIPでの仕様 |
|---|---|---|
| Text Encoder | 12層Transformer、BPEトークナイザ | 最大77トークン、CLS埋め込みを出力 |
| Image Encoder | ViT-B/32 または ViT-L/14 | 画像をパッチに分割、CLSを出力 |
| 埋め込み次元 | 512(ViT-B/32)または 768(ViT-L/14) | テキストと画像の共有空間 |
| 学習データ | 4億組の画像-テキストペア(WITデータセット) | インターネットから収集 |
| 損失関数 | 対称交差エントロピー | InfoNCE / NT-Xent の変種 |
| Temperature | 学習可能なスカラー τ | 初期値 ≈ 0.07、学習中に更新 |
試験のヒント: CLIPは画像を生成しません。テキストと画像を共有空間にエンコードするだけです。テキストから画像へのパイプラインでは、CLIPのText Encoderのみを使用してU-Netの条件付け信号を作成します。Image Encoderは生成時には使用されません。
3. コードでのCLIPエンコーディングの使用
3.1 CLIPの読み込みとテキストのエンコード
import torch
import clip
from PIL import Image

# 事前学習済みCLIPモデルの読み込み
device = "cuda" if torch.cuda.is_available() else "cpu"
model, preprocess = clip.load("ViT-B/32", device=device)

# ── テキストのエンコード ──
text_prompts = ["a photo of a cat", "a sunset over mountains", "a red car"]
text_tokens = clip.tokenize(text_prompts).to(device)  # (3, 77) — 77トークンにパディング

with torch.no_grad():
    text_embeddings = model.encode_text(text_tokens)  # (3, 512)
    text_embeddings = text_embeddings / text_embeddings.norm(dim=-1, keepdim=True)  # L2正規化

print(f"Text embeddings shape: {text_embeddings.shape}")  # (3, 512)
3.2 画像のエンコードと類似度の計算
# ── 画像のエンコード ──
images = [preprocess(Image.open(f"img_{i}.jpg")).unsqueeze(0) for i in range(3)]
image_batch = torch.cat(images).to(device)  # (3, 3, 224, 224)

with torch.no_grad():
    image_embeddings = model.encode_image(image_batch)   # (3, 512)
    image_embeddings = image_embeddings / image_embeddings.norm(dim=-1, keepdim=True)

# ── コサイン類似度 ──
similarity = text_embeddings @ image_embeddings.T  # (3, 3)
print(similarity)
# tensor([[ 0.31,  0.05,  0.02],    ← "cat" が image_0 に一致
#         [ 0.04,  0.28,  0.06],    ← "sunset" が image_1 に一致
#         [ 0.03,  0.07,  0.26]])   ← "red car" が image_2 に一致
結果:内容が一致するテキストと画像が最も高い類似度を持ちます。これが共有埋め込み空間の力です。テキストで画像を検索したり、その逆も可能です。
3.3 Diffusion ModelsにおけるCLIP:シーケンス埋め込み
重要:Stable DiffusionはCLS埋め込み(単一ベクトル)を使用しません。代わりに、CLIP Text Encoderからのトークン埋め込みのシーケンス(投影層の前の出力)を使用します:
CLS Embedding vs Sequence Embeddings
═════════════════════════════════════

  テキスト: "a photo of a cat"
  トークン化: [SOS, "a", "photo", "of", "a", "cat", EOS, PAD, PAD, ...]

  CLIP Text Encoderの出力:
  ┌──────────────────────────────────────────────┐
  │  token_0 (SOS)  → [0.12, -0.34, 0.56, ...]  │
  │  token_1 ("a")  → [0.08, -0.21, 0.43, ...]  │
  │  token_2 ("photo") → [...]                   │
  │  token_3 ("of") → [...]                      │
  │  token_4 ("a")  → [...]                      │
  │  token_5 ("cat")→ [0.91, 0.15, -0.33, ...]  │  ← 意味情報
  │  token_6 (EOS)  → [0.67, 0.42, -0.18, ...]  │  ← CLS(CLIPが使用)
  │  ...                                         │
  │  token_76 (PAD) → [0.00, 0.00, 0.00, ...]   │
  └──────────────────────────────────────────────┘

  Stable Diffusionが使用:全77トークン埋め込み → (1, 77, 768)
  CLIPゼロショットが使用:EOSトークン埋め込みのみ → (1, 768)
| ユースケース | 出力 | 形状 | 理由 |
|---|---|---|---|
| CLIP分類 | CLS / EOSトークン | (B, 768) | グローバルな類似度比較 |
| Stable Diffusion | 全トークンシーケンス | (B, 77, 768) | Cross-Attentionにはトークンごとの情報が必要 |
試験のヒント: 「U-Netへのテキスト条件付け入力の形状は?」と問われた場合、答えは(batch, 77, 768)です。(batch, 768)ではありません。Cross-Attentionには単一ベクトルではなく、シーケンスが必要です。
4. Cross-Attention:テキスト埋め込みのU-Netへの注入
4.1 Cross-Attentionのメカニズム
レッスン3では、U-NetはSelf-Attentionを使用していました。Q、K、Vはすべて画像特徴から生成されます。Cross-AttentionではKとVのソースが変わります:
Self-Attention vs Cross-Attention
═════════════════════════════════

  SELF-ATTENTION(U-Net内):
  ───────────────────────────────
  Q = W_q · image_features    ← 画像から
  K = W_k · image_features    ← 画像から
  V = W_v · image_features    ← 画像から

  Attention = softmax(Q · K^T / √d) · V

  CROSS-ATTENTION(テキスト → 画像):
  ────────────────────────────────
  Q = W_q · image_features    ← 画像から(クエリ)
  K = W_k · text_embeddings   ← CLIPテキストから(キー)
  V = W_v · text_embeddings   ← CLIPテキストから(バリュー)

  Attention = softmax(Q_image · K_text^T / √d) · V_text

  ┌──────────────────────────────────────────────────┐
  │  Q の形状: (B, H*W, d_model)    ← 空間ピクセル    │
  │  K の形状: (B, 77, d_model)     ← テキストトークン  │
  │  V の形状: (B, 77, d_model)     ← テキストトークン  │
  │  スコア:   (B, H*W, 77)        ← ピクセル→トークン │
  │  出力:     (B, H*W, d_model)    ← テキスト考慮済み画像 │
  └──────────────────────────────────────────────────┘
各ピクセルが77個のテキストトークンすべてを「参照」し、どのトークンに注目するかを決定します。猫の領域にあるピクセルは「cat」トークンに強く注目し、空の領域のピクセルは「sky」に注目します。
4.2 U-NetブロックにおけるCross-Attention
U-Net Block with Cross-Attention
════════════════════════════════

  入力: x(画像特徴、形状: B×C×H×W)
  条件: text_emb(CLIP出力、形状: B×77×768)
  タイムステップ: t_emb(タイムステップ埋め込み、形状: B×d)

  ┌─────────────────────────────────────────────┐
  │                U-Net Block                   │
  │                                             │
  │  x ──► [ResBlock + t_emb] ──► x'           │
  │              │                               │
  │              ▼                               │
  │     [Self-Attention]                         │
  │       Q,K,V ← x'                            │
  │              │                               │
  │              ▼                               │
  │     [Cross-Attention]   ◄── text_emb        │
  │       Q ← x'                                │
  │       K,V ← text_emb                        │
  │              │                               │
  │              ▼                               │
  │     [FFN / MLP]                              │
  │              │                               │
  │              ▼                               │
  │           output                             │
  └─────────────────────────────────────────────┘

  各ブロック内の順序: ResBlock → Self-Attn → Cross-Attn → FFN
4.3 実装:CrossAttentionモジュール
import torch
import torch.nn as nn
import torch.nn.functional as F

class CrossAttention(nn.Module):
    """
    Cross-Attention: Qは画像特徴から、K/Vはテキスト埋め込みから。
    U-Netブロックでテキスト条件付けを注入するために使用。
    """
    def __init__(self, d_model, context_dim, n_heads=8):
        super().__init__()
        self.n_heads = n_heads
        self.d_head = d_model // n_heads

        # Qは画像から、K/Vはテキストから
        self.to_q = nn.Linear(d_model, d_model, bias=False)
        self.to_k = nn.Linear(context_dim, d_model, bias=False)
        self.to_v = nn.Linear(context_dim, d_model, bias=False)
        self.out_proj = nn.Linear(d_model, d_model)
        self.norm = nn.LayerNorm(d_model)

    def forward(self, x, context):
        """
        Args:
            x: 画像特徴 (B, H*W, d_model)
            context: CLIPからのテキスト埋め込み (B, seq_len, context_dim)
        Returns:
            テキスト条件付き画像特徴 (B, H*W, d_model)
        """
        residual = x
        x = self.norm(x)

        B, N, _ = x.shape
        H = self.n_heads
        d = self.d_head

        # Q, K, Vへの投影
        Q = self.to_q(x).view(B, N, H, d).transpose(1, 2)       # (B, H, N, d)
        K = self.to_k(context).view(B, -1, H, d).transpose(1, 2) # (B, H, S, d)
        V = self.to_v(context).view(B, -1, H, d).transpose(1, 2) # (B, H, S, d)

        # スケーリングドット積アテンション
        scale = d ** -0.5
        attn = torch.matmul(Q, K.transpose(-2, -1)) * scale  # (B, H, N, S)
        attn = F.softmax(attn, dim=-1)

        # 値の加重和
        out = torch.matmul(attn, V)                     # (B, H, N, d)
        out = out.transpose(1, 2).contiguous().view(B, N, H * d)  # (B, N, d_model)
        out = self.out_proj(out)

        return out + residual  # 残差接続
4.4 Self-Attention + Cross-Attentionを組み合わせたU-Netブロック
class TransformerBlock(nn.Module):
    """単一のTransformerブロック: Self-Attn → Cross-Attn → FFN"""
    def __init__(self, d_model, context_dim, n_heads=8):
        super().__init__()
        self.self_attn = nn.MultiheadAttention(d_model, n_heads, batch_first=True)
        self.self_attn_norm = nn.LayerNorm(d_model)

        self.cross_attn = CrossAttention(d_model, context_dim, n_heads)

        self.ffn = nn.Sequential(
            nn.LayerNorm(d_model),
            nn.Linear(d_model, d_model * 4),
            nn.GELU(),
            nn.Linear(d_model * 4, d_model),
        )

    def forward(self, x, context):
        # Self-Attention
        norm_x = self.self_attn_norm(x)
        attn_out, _ = self.self_attn(norm_x, norm_x, norm_x)
        x = x + attn_out

        # Cross-Attention(テキストを注入)
        x = self.cross_attn(x, context)

        # フィードフォワード
        x = x + self.ffn(x)
        return x
試験のヒント: 評価でよくある間違い:K、Vをテキストではなく画像から設定してしまうこと。Cross-AttentionのK、Vが画像特徴から取得される場合、テキストプロンプトは全く効果がなくなり、出力は無条件生成と同じになります。デバッグのヒント:
self.to_kとself.to_vがcontext(テキスト)を受け取っているか、x(画像)を受け取っているかを確認してください。
5. 完全なテキストから画像へのパイプライン
5.1 概要:すべてのコンポーネントの統合
Full Text-to-Image Pipeline
════════════════════════════

  入力: "a golden retriever playing in snow"

  ┌──────────────────────────────────────────────────────────────┐
  │                                                              │
  │  ステップ1: テキストエンコーディング                            │
  │  ─────────────────────                                       │
  │  prompt ──► CLIP Tokenizer ──► CLIP Text Encoder             │
  │                                      │                       │
  │                               text_emb (1, 77, 768)         │
  │                                      │                       │
  │  ステップ2: ノイズの初期化              │                       │
  │  ────────────────────────────        │                       │
  │  x_T ~ N(0, I)  (純粋なノイズ)      │                       │
  │       形状: (1, C, H, W)             │                       │
  │              │                        │                       │
  │  ステップ3: 逆拡散ループ               │                       │
  │  ───────────────────────────────     │                       │
  │  for t = T, T-1, ..., 1:            │                       │
  │    │                                  │                       │
  │    ├─► ε̂_uncond = UNet(x_t, t, ∅)   │  ← 無条件            │
  │    ├─► ε̂_cond = UNet(x_t, t, text_emb) ← 条件付き          │
  │    │                                                         │
  │    ├─► ε̂ = ε̂_uncond + w·(ε̂_cond − ε̂_uncond)   ← CFG      │
  │    │                                                         │
  │    └─► x_{t-1} = denoise_step(x_t, ε̂, t)                   │
  │              │                                               │
  │  ステップ4: 出力                                              │
  │  ──────────────                                              │
  │  x_0 = 最終的なノイズ除去画像                                  │
  │                                                              │
  └──────────────────────────────────────────────────────────────┘
5.2 実装:テキストから画像へのサンプリング
@torch.no_grad()
def text_to_image_sample(
    unet, clip_model, prompt, schedule,
    guidance_scale=7.5, image_size=64, channels=3,
    device='cuda'
):
    """
    完全なテキストから画像へのサンプリングパイプライン。
    CLIPエンコーディング + CFG + DDPM逆拡散を統合。
    """
    T = len(schedule['betas'])
    betas = schedule['betas'].to(device)
    alphas = schedule['alphas'].to(device)
    alpha_bar = schedule['alpha_bar'].to(device)

    # ── ステップ1: テキストプロンプトのエンコード ──
    text_tokens = clip.tokenize([prompt]).to(device)           # (1, 77)
    text_emb = clip_model.encode_text_sequence(text_tokens)    # (1, 77, 768)

    # 無条件パス用のNull埋め込み(CFG)
    null_tokens = clip.tokenize([""]).to(device)
    null_emb = clip_model.encode_text_sequence(null_tokens)    # (1, 77, 768)

    # ── ステップ2: 純粋なノイズから開始 ──
    x_t = torch.randn(1, channels, image_size, image_size, device=device)

    # ── ステップ3: CFGを用いた逆拡散 ──
    for t in reversed(range(T)):
        t_batch = torch.tensor([t], device=device)

        # 条件付きと無条件の予測
        noise_cond = unet(x_t, t_batch, context=text_emb)     # ε̂_cond
        noise_uncond = unet(x_t, t_batch, context=null_emb)   # ε̂_uncond

        # Classifier-Free Guidance
        noise_pred = noise_uncond + guidance_scale * (noise_cond - noise_uncond)

        # DDPMノイズ除去ステップ
        alpha_t = alphas[t]
        alpha_bar_t = alpha_bar[t]
        beta_t = betas[t]

        # 予測されたx_0
        x_0_pred = (x_t - (1 - alpha_bar_t).sqrt() * noise_pred) / alpha_bar_t.sqrt()
        x_0_pred = x_0_pred.clamp(-1, 1)

        if t > 0:
            alpha_bar_prev = alpha_bar[t - 1]
            # 事後分布の平均
            coeff1 = beta_t * alpha_bar_prev.sqrt() / (1 - alpha_bar_t)
            coeff2 = (1 - alpha_bar_prev) * alpha_t.sqrt() / (1 - alpha_bar_t)
            mean = coeff1 * x_0_pred + coeff2 * x_t

            # 事後分布の分散
            sigma = (beta_t * (1 - alpha_bar_prev) / (1 - alpha_bar_t)).sqrt()
            z = torch.randn_like(x_t)
            x_t = mean + sigma * z
        else:
            x_t = x_0_pred  # 最終ステップ:ノイズなし

    return x_t  # 生成された画像 (1, C, H, W)
5.3 パイプラインコンポーネントのまとめ
| コンポーネント | 役割 | 入力 → 出力 | 学習可能? |
|---|---|---|---|
| CLIP Text Encoder | テキスト → 埋め込みにエンコード | str → (B, 77, 768) | 固定(事前学習済み) |
| U-Net(Cross-Attn付き) | ノイズ ε̂ を予測 | (x_t, t, text_emb) → ε̂ | はい — 主要な学習対象 |
| ノイズスケジュール | β_t, α_t, ᾱ_t を定義 | t → スケジュール値 | いいえ(固定) |
| CFG | 条件付き/無条件を統合 | (ε̂_cond, ε̂_uncond, w) → ε̂ | いいえ(推論時のみ) |
| DDPMサンプラー | 段階的にノイズ除去 | (x_t, ε̂, t) → x_{t-1} | いいえ(固定公式) |
試験のヒント: 評価では、CLIPエンコーダとスケジュールがすでに提供されたコードスケルトンを受け取ります。あなたのタスクは、U-Netのフォワードパス(Cross-Attention付き)とサンプリングループ(CFG付き)を実装することです。CLIPを書き直す必要はありません。すでに提供されています。
6. Latent Diffusion — Stable Diffusionの概要
6.1 ピクセル空間拡散の問題
オリジナルのDDPMはピクセル空間で直接拡散を行います。256×256のRGB画像の場合、各拡散ステップで196,608次元を処理します。これは非常に遅く、メモリを大量に消費します。
Latent Diffusion Model(LDM)(Stable Diffusionの基盤)は、はるかに小さな潜在空間で拡散を実行することでこの問題を解決します。
Pixel Space vs Latent Space Diffusion
══════════════════════════════════════

  ピクセル空間(オリジナルDDPM):
  ────────────────────────
  画像: 256 × 256 × 3 = 196,608次元
  U-Netは非常に大きなテンソルを処理する必要がある
  ✗ 遅い  ✗ 高VRAM  ✗ 1000ステップ

  潜在空間(Stable Diffusion):
  ─────────────────────────────────
  画像 ──► VAE Encoder ──► 潜在表現: 32 × 32 × 4 = 4,096次元
                                          │
                              48倍小さい    │
                                          ▼
                              潜在空間での拡散
                                          │
                                          ▼
                            潜在表現 ──► VAE Decoder ──► 画像

  ┌───────────────────────────────────────────────────────┐
  │  Stable Diffusionアーキテクチャ:                       │
  │                                                       │
  │  "a golden retriever"                                 │
  │         │                                             │
  │         ▼                                             │
  │  ┌──────────┐                                         │
  │  │   CLIP   │──── text_emb (1, 77, 768)              │
  │  │ Encoder  │         │                               │
  │  └──────────┘         │                               │
  │                       ▼                               │
  │  z_T (ノイズ) ──► U-Net (潜在) ──► z_0 (潜在)        │
  │  (1,4,32,32)    + cross-attn      (1,4,32,32)       │
  │                                        │              │
  │                                        ▼              │
  │                                 ┌──────────┐          │
  │                                 │   VAE    │          │
  │                                 │ Decoder  │          │
  │                                 └────┬─────┘          │
  │                                      │                │
  │                                      ▼                │
  │                               画像 (1,3,256,256)      │
  └───────────────────────────────────────────────────────┘
6.2 VAE:Encoder & Decoder
| コンポーネント | ピクセル空間 | 潜在空間 | 圧縮率 |
|---|---|---|---|
| 画像サイズ | 256 × 256 × 3 | 32 × 32 × 4 | 48倍少ない次元 |
| 512 × 512 × 3 | 786,432次元 | 64 × 64 × 4 = 16,384 | 48倍少ない次元 |
| U-Net入力 | フル解像度のピクセル | 圧縮された潜在表現 | はるかに高速 |
| 学習コスト | 非常に高い(多くのGPU日数) | はるかに低い | 1 GPUで実現可能 |
# Latent Diffusion — VAE + U-Netを潜在空間で使用
from diffusers import AutoencoderKL

# 事前学習済みVAEの読み込み
vae = AutoencoderKL.from_pretrained("stabilityai/sd-vae-ft-mse")
vae = vae.to(device).eval()

# ── 画像 → 潜在表現へのエンコード ──
with torch.no_grad():
    # image: (B, 3, 256, 256)、[-1, 1]に正規化済み
    latent = vae.encode(image).latent_dist.sample()  # (B, 4, 32, 32)
    latent = latent * 0.18215  # スケーリングファクター(Stable Diffusionの慣例)

# ── 潜在空間で拡散を実行 ──
# x_T = torch.randn(1, 4, 32, 32)  ← 潜在空間でのノイズ
# ... 潜在表現に対する逆拡散ループ ...

# ── 潜在表現 → 画像へのデコード ──
with torch.no_grad():
    latent_decoded = latent / 0.18215
    image_out = vae.decode(latent_decoded).sample  # (B, 3, 256, 256)
    image_out = (image_out + 1) / 2  # [-1,1] → [0,1]
6.3 DDIMスケジューラ:ステップ数の削減
DDPMは1画像あたり1000ステップが必要です。DDIM(Denoising Diffusion Implicit Models)は、タイムステップをスキップすることで20〜50ステップのみで決定論的サンプリングを可能にします:
| スケジューラ | ステップ数 | 確率的? | 品質 | 速度 |
|---|---|---|---|---|
| DDPM | 1000 | はい(各ステップでランダムz) | 良好 | 非常に遅い |
| DDIM | 20–50 | いいえ(決定論的) | 同等 | 20–50倍高速 |
| Euler | 20–30 | 任意 | 良好 | 高速 |
| DPM-Solver | 10–25 | 任意 | 非常に良好 | 最速 |
DDPM(1000ステップ)vs DDIM(50ステップ)
═════════════════════════════════════

  DDPM:   x_1000 → x_999 → x_998 → ... → x_1 → x_0
          └──────────── 1000回のU-Net呼び出し ────────────┘

  DDIM:   x_1000 → x_980 → x_960 → ... → x_20 → x_0
          └──────────── 50回のU-Net呼び出し ──────────────┘
          (毎回20ステップをスキップ)

  DDIMの核心的洞察:非マルコフ的 — x_{t-k}はx_tとx_0(予測値)に依存
  → 各中間ステップを通過する必要がない
  → 同等の品質で20倍高速
試験のヒント: 「Stable Diffusionが50ステップでDDPMが1000ステップなのはなぜか?」と問われた場合、答えはDDIMスケジューラと潜在空間に関係しています。両方の要因が寄与します:DDIMはステップ数を削減し、潜在空間は各ステップのサイズを縮小します。
7. チートシート — パート2のまとめ
| 概念 | 主要な公式/詳細 | 試験の焦点 |
|---|---|---|
| CLIP Text Encoder | テキスト → (B, 77, 768) 埋め込み | 形状、固定 vs 学習可能 |
| Contrastive Loss | N×N類似度行列に対するCE | 一致ペア ↑、不一致ペア ↓ |
| Cross-Attention Q | Q = W_q · image_features | Qは画像から、テキストからではない |
| Cross-Attention K, V | K = W_k · text_emb, V = W_v · text_emb | K, Vはテキストから、画像からではない |
| U-Netブロック順序 | ResBlock → Self-Attn → Cross-Attn → FFN | コーディングの順序が重要 |
| CFG公式 | ε̂ = ε̂_uncond + w·(ε̂_cond − ε̂_uncond) | w = 7.5がデフォルト、2回のフォワードパス |
| 潜在空間(SD) | 256×256×3 → 32×32×4(VAE経由) | 48倍の圧縮、4チャネル潜在表現 |
| DDIM vs DDPM | 50 vs 1000ステップ | 非マルコフ、決定論的 |
| VAEスケーリングファクター | 0.18215 | エンコード後に×、デコード前に÷ |
| パイプライン順序 | テキスト → CLIP → U-Net(+CFG) → VAE Decode → 画像 | エンドツーエンドのフロー |
8. 試験対策 — DLI S-FX-14 最終評価
8.1 評価の概要
DLI評価S-FX-14では、JupyterLab環境でコーディングタスクを完了する必要があります。# TODOマーカー付きのコードスケルトンが提供され、不足している部分を実装します。
| セクション | 内容 | 推定配点 | 推奨時間 |
|---|---|---|---|
| U-Netアーキテクチャ | ResBlock、Attention、CrossAttentionの実装 | 約30% | 25分 |
| DDPM学習 | 順拡散、学習ループ、損失 | 約25% | 20分 |
| テキスト条件付け | CLIPの統合、Cross-Attentionの配線 | 約25% | 20分 |
| サンプリングパイプライン | 逆拡散 + CFGサンプリング | 約20% | 15分 |
8.2 よくある落とし穴と修正方法
| 落とし穴 | 症状 | 修正方法 |
|---|---|---|
| Cross-AttnのK/Vが画像から | テキストプロンプトが出力に影響しない | K、Vがcontext(テキスト)を受け取り、Qがx(画像)を受け取ることを確認 |
| CLIPのL2正規化忘れ | 類似度の値が想定範囲外 | / embed.norm(dim=-1, keepdim=True)を追加 |
| CFGのguidance_scale = 1.0 | 低品質の画像、プロンプトに従わない | w = 7.5または問題で指定された値を使用 |
| Attention reshape時の形状エラー | RuntimeError: shape mismatch | (B, H, N, d) → (B, N, H*d)の順序を確認 |
サンプリング時の.no_grad()忘れ | メモリ不足 | サンプリングループをtorch.no_grad()で囲む |
| VAEスケーリングファクターの誤り | 画像出力が色褪せまたは彩度過多 | エンコード:× 0.18215、デコード:÷ 0.18215 |
| タイムステップ埋め込みの次元の誤り | ResBlockでサイズ不一致 | t_embの次元がチャネル次元と一致することを確認 |
8.3 試験戦略
- ノートブック全体を最初に読む(5分) — フローを理解し、TODOブロックを特定します
- 順番に実装する:U-Netブロック → 順拡散 → 学習ループ → サンプリング
- 各部分をテストする:各TODOの後にセルを実行し、正しい形状/出力を確認します
- 形状エラーをデバッグする:一時的に
print(tensor.shape)を追加します - 提供されたコードを書き直さない — TODOのみを埋め、それ以外はすべてそのままにします
試験のヒント: 評価ではコードを複数回実行できます。段階的にテストしてください:1つのTODOを実装 → セルを実行 → 検証 → 次のTODOへ。すべてを実装してから実行しようとしないでください。複数のエラーが同時に発生すると、デバッグが非常に困難になります。
9. 練習問題 — コーディング演習
以下の問題はDLI評価の形式を模擬しています。答えを確認する前に、自分で解いてみてください。
Q1:CrossAttentionモジュールの実装
CrossAttentionモジュールを完成させてください。Qは画像特徴から、KとVはテキスト埋め込みから取得します。残差接続を持つマルチヘッドアテンションを使用してください。
class CrossAttention(nn.Module):
    def __init__(self, d_model=256, context_dim=768, n_heads=8):
        super().__init__()
        self.n_heads = n_heads
        self.d_head = d_model // n_heads
        # TODO: to_q, to_k, to_v, out_proj, normを定義
        pass

    def forward(self, x, context):
        """
        x: (B, N, d_model) - 画像特徴
        context: (B, S, context_dim) - テキスト埋め込み
        Returns: (B, N, d_model)
        """
        # TODO: Cross-Attentionを実装
        pass
答えを表示 Q1
class CrossAttention(nn.Module):
    def __init__(self, d_model=256, context_dim=768, n_heads=8):
        super().__init__()
        self.n_heads = n_heads
        self.d_head = d_model // n_heads
        self.to_q = nn.Linear(d_model, d_model, bias=False)
        self.to_k = nn.Linear(context_dim, d_model, bias=False)
        self.to_v = nn.Linear(context_dim, d_model, bias=False)
        self.out_proj = nn.Linear(d_model, d_model)
        self.norm = nn.LayerNorm(d_model)

    def forward(self, x, context):
        residual = x
        x = self.norm(x)
        B, N, _ = x.shape
        H, d = self.n_heads, self.d_head

        Q = self.to_q(x).view(B, N, H, d).transpose(1, 2)         # (B, H, N, d)
        K = self.to_k(context).view(B, -1, H, d).transpose(1, 2)   # (B, H, S, d)
        V = self.to_v(context).view(B, -1, H, d).transpose(1, 2)   # (B, H, S, d)

        scale = d ** -0.5
        attn = torch.matmul(Q, K.transpose(-2, -1)) * scale
        attn = F.softmax(attn, dim=-1)

        out = torch.matmul(attn, V)
        out = out.transpose(1, 2).contiguous().view(B, N, H * d)
        out = self.out_proj(out)
        return out + residual
ポイント:to_qはx(画像)を受け取り、to_kとto_vはcontext(テキスト)を受け取ります。Self-Attentionとの唯一の違いはここです。
Q2:完全なテキストから画像へのサンプリングパイプラインの構築
Cross-Attention付きの学習済みU-Net、CLIPテキストエンコーダ、DDPMスケジュールが与えられた場合、Classifier-Free Guidanceを含む完全なサンプリング関数を実装してください。
@torch.no_grad()
def sample_text_to_image(unet, clip_encoder, prompt, schedule,
                          guidance_scale=7.5, H=64, W=64, C=3,
                          device='cuda'):
    """
    テキストプロンプトから画像を生成。
    Args:
        unet: Cross-Attention付きU-Net(x_t, t, contextを受け取る)
        clip_encoder: テキスト → (1, 77, 768)にエンコード
        prompt: 文字列、例 "a cat sitting on a chair"
        schedule: 'betas', 'alphas', 'alpha_bar'を含むdict
        guidance_scale: CFGの重み(w)
    Returns: 生成された画像テンソル (1, C, H, W)
    """
    # TODO: 完全なパイプラインを実装
    # 1. CLIPでプロンプトとnullプロンプトをエンコード
    # 2. x_Tをランダムノイズとして初期化
    # 3. CFGを用いた逆拡散ループ
    # 4. x_0を返す
    pass
答えを表示 Q2
@torch.no_grad()
def sample_text_to_image(unet, clip_encoder, prompt, schedule,
                          guidance_scale=7.5, H=64, W=64, C=3,
                          device='cuda'):
    T = len(schedule['betas'])
    betas = schedule['betas'].to(device)
    alphas = schedule['alphas'].to(device)
    alpha_bar = schedule['alpha_bar'].to(device)

    # 1. テキストのエンコード
    text_emb = clip_encoder.encode(prompt)       # (1, 77, 768)
    null_emb = clip_encoder.encode("")            # (1, 77, 768)

    # 2. ノイズの初期化
    x_t = torch.randn(1, C, H, W, device=device)

    # 3. 逆拡散
    for t in reversed(range(T)):
        t_tensor = torch.tensor([t], device=device)

        # CFG:2回のフォワードパス
        eps_cond = unet(x_t, t_tensor, context=text_emb)
        eps_uncond = unet(x_t, t_tensor, context=null_emb)
        eps = eps_uncond + guidance_scale * (eps_cond - eps_uncond)

        # DDPM逆ステップ
        ab_t = alpha_bar[t]
        a_t = alphas[t]
        b_t = betas[t]

        x0_pred = (x_t - (1 - ab_t).sqrt() * eps) / ab_t.sqrt()
        x0_pred = x0_pred.clamp(-1, 1)

        if t > 0:
            ab_prev = alpha_bar[t - 1]
            c1 = b_t * ab_prev.sqrt() / (1 - ab_t)
            c2 = (1 - ab_prev) * a_t.sqrt() / (1 - ab_t)
            mean = c1 * x0_pred + c2 * x_t
            sigma = (b_t * (1 - ab_prev) / (1 - ab_t)).sqrt()
            x_t = mean + sigma * torch.randn_like(x_t)
        else:
            x_t = x0_pred

    return x_t
ポイント:(1) CFGの無条件パス用のNull埋め込み、(2) 各ステップでU-Netを2回フォワードパス、(3) 数値的安定性のためx0_predをclamp、(4) t=0ではノイズなし。
Q3:Latent Diffusionが約50ステップでDDPMが1000ステップ必要な理由の説明
DDPMとDDIMのステップ選択の違いを示す短い関数を書き、DDIMがステップをスキップできる理由をコメントで説明してください。
def compare_schedulers(T=1000, ddim_steps=50):
    """
    DDPMとDDIMのタイムステップ選択の違いを表示。
    TODO: 両方のタイムステップシーケンスを返し、
    DDIMが品質低下なしにステップをスキップできる理由をコメントで説明。
    """
    # TODO: 実装
    pass
答えを表示 Q3
import numpy as np

def compare_schedulers(T=1000, ddim_steps=50):
    """
    DDPM: すべてのタイムステップ t = T-1, T-2, ..., 1, 0 を訪問する必要がある
      → 各ステップはマルコフ的:x_{t-1}はx_tのみに依存
      → マルコフ連鎖を壊さずにステップをスキップできない

    DDIM: 非マルコフ的な定式化を使ってタイムステップをスキップできる
      → x_{t-k} = f(x_t, predicted_x_0) — x_tと予測されたx_0に依存
      → 予測されたx_0を通る「ショートカット」で複数ステップを飛ばせる
      → 決定論的(各ステップでランダムノイズzを追加しない)
    """
    # DDPM: 全1000ステップ
    ddpm_steps = list(range(T - 1, -1, -1))  # [999, 998, ..., 1, 0]

    # DDIM: 等間隔のサブセット
    step_size = T // ddim_steps  # 1000 // 50 = 20
    ddim_timesteps = list(range(T - 1, -1, -step_size))  # [999, 979, 959, ..., 19]

    print(f"DDPM: {len(ddpm_steps)} ステップ")
    print(f"  最初の5つ: {ddpm_steps[:5]}")
    print(f"  最後の5つ: {ddpm_steps[-5:]}")

    print(f"\nDDIM: {len(ddim_timesteps)} ステップ")
    print(f"  最初の5つ: {ddim_timesteps[:5]}")
    print(f"  最後の5つ: {ddim_timesteps[-5:]}")

    # 核心的理由:DDIMは非マルコフ的な更新則を使用:
    # x_{t-k} = sqrt(ᾱ_{t-k}) * predicted_x0 + sqrt(1 - ᾱ_{t-k}) * direction
    # この公式はt-1だけでなく、任意のt-kに対して機能する
    # → t=999からt=979に直接スキップ可能

    return ddpm_steps, ddim_timesteps
核心的な洞察:DDPMはマルコフ的(各ステップは前のステップのみに依存)ですが、DDIMは非マルコフ的(予測されたx_0にも依存)です。非マルコフ的な定式化により、品質の大幅な低下なしに複数のステップを一度に「ジャンプ」できます。
Q4:デバッグ — テキストプロンプトが生成画像に影響しない
以下のコードは画像を生成しますが、テキストプロンプトを変更しても出力が変わりません。バグを見つけて修正してください。
class BuggyUNetBlock(nn.Module):
    def __init__(self, d_model=256, context_dim=768, n_heads=8):
        super().__init__()
        self.self_attn = nn.MultiheadAttention(d_model, n_heads, batch_first=True)
        self.cross_attn_q = nn.Linear(d_model, d_model)
        self.cross_attn_k = nn.Linear(d_model, d_model)      # ここにバグ?
        self.cross_attn_v = nn.Linear(d_model, d_model)      # ここにバグ?
        self.cross_attn_out = nn.Linear(d_model, d_model)
        self.norm1 = nn.LayerNorm(d_model)
        self.norm2 = nn.LayerNorm(d_model)

    def forward(self, x, context):
        # Self-Attention
        norm_x = self.norm1(x)
        sa_out, _ = self.self_attn(norm_x, norm_x, norm_x)
        x = x + sa_out

        # Cross-Attention
        norm_x = self.norm2(x)
        Q = self.cross_attn_q(norm_x)
        K = self.cross_attn_k(norm_x)    # ← この行
        V = self.cross_attn_v(norm_x)    # ← とこの行
        # ... アテンション計算 ...
        return x
答えを表示 Q4
# バグ:cross_attn_kとcross_attn_vがcontext(テキスト埋め込み)ではなく
# norm_x(画像特徴)を受け取っている。
# これにより「Cross-Attention」が実質的に別のSelf-Attentionになり、
# テキストプロンプトが出力にゼロの影響しか与えない。

# 修正1:Linearの入力次元を変更
self.cross_attn_k = nn.Linear(context_dim, d_model)  # d_modelではなくcontext_dim
self.cross_attn_v = nn.Linear(context_dim, d_model)   # d_modelではなくcontext_dim

# 修正2:norm_xではなくcontextを渡す
K = self.cross_attn_k(context)    # ← 修正:norm_xではなくcontextを使用
V = self.cross_attn_v(context)    # ← 修正:norm_xではなくcontextを使用
2つのバグ:(1) cross_attn_kとcross_attn_vの入力次元がcontext_dimではなくd_modelになっている、(2) KとVがcontext(テキスト)ではなくnorm_x(画像)から計算されている。結果:U-Netがテキスト条件付けを完全に無視し、プロンプトに関係なく出力が無条件生成と同じになります。
Q5:統合テスト — 動作するテキストから画像へのシステムの組み立て
以下の構築済みコンポーネントが与えられた場合、それらを動作するテキストから画像へのシステムに接続する統合コードを書き、1枚の画像を生成してください。
# 構築済みコンポーネント(すでに定義済み):
# - clip_model: .encode_text(tokens)を持つ → (B, 77, 768)
# - unet: .forward(x_t, t_emb, context)を持つ → ノイズ予測
# - schedule: 'betas', 'alphas', 'alpha_bar'を含むdict(T=1000)
# - ddpm_reverse_step(x_t, noise_pred, t, schedule) → x_{t-1}

def generate_image(prompt: str, negative_prompt: str = "",
                   guidance_scale: float = 7.5, steps: int = 1000,
                   image_size: int = 64, channels: int = 3):
    """
    TODO: すべてのコンポーネントを接続。
    処理内容:CLIPエンコーディング、CFG用のnullプロンプト、逆ループ、CFGの統合。
    最終的な画像テンソルを返す。
    """
    pass
答えを表示 Q5
@torch.no_grad()
def generate_image(prompt: str, negative_prompt: str = "",
                   guidance_scale: float = 7.5, steps: int = 1000,
                   image_size: int = 64, channels: int = 3):
    device = next(unet.parameters()).device

    # ── 1. CLIPエンコード:ポジティブとネガティブ/nullプロンプト ──
    pos_tokens = clip.tokenize([prompt]).to(device)
    neg_tokens = clip.tokenize([negative_prompt]).to(device)

    pos_emb = clip_model.encode_text(pos_tokens)     # (1, 77, 768)
    neg_emb = clip_model.encode_text(neg_tokens)     # (1, 77, 768)

    # ── 2. ランダムノイズの初期化 ──
    x_t = torch.randn(1, channels, image_size, image_size, device=device)

    # ── 3. CFGを用いた逆拡散 ──
    for t in reversed(range(steps)):
        t_tensor = torch.tensor([t], device=device)

        # CFG用の2回のフォワードパス
        noise_pos = unet(x_t, t_tensor, context=pos_emb)
        noise_neg = unet(x_t, t_tensor, context=neg_emb)

        # CFGの統合
        noise_guided = noise_neg + guidance_scale * (noise_pos - noise_neg)

        # ノイズ除去ステップ
        x_t = ddpm_reverse_step(x_t, noise_guided, t, schedule)

    # ── 4. 後処理 ──
    image = (x_t.clamp(-1, 1) + 1) / 2   # [-1,1] → [0,1]
    return image

# 生成!
img = generate_image("a golden retriever playing in snow", guidance_scale=7.5)
print(f"Output shape: {img.shape}")  # (1, 3, 64, 64)
統合チェックリスト:(1) ポジティブとネガティブの両方のプロンプトをエンコード、(2) 正しい形状でノイズを初期化、(3) T-1から0まで逆順にループ、(4) 各ステップでCFG用に2回のフォワードパス、(5) guidance_scaleで統合、(6) ノイズ除去ステップを呼び出し、(7) 出力を後処理。空のネガティブプロンプト ""は無条件として機能します。これがStable DiffusionがCFGを処理する方法です。