はじめに
あなたの会社のルールについて ChatGPT に質問して、でっち上げの答えを受け取ったことがありますか?または、先週の出来事について尋ねても、AI は「2024 年 4 月以降の情報はありません」と言いますか?
これらは LLM の 2 つの最大の問題です。
| 問題 | 説明 | 例 |
|---|---|---|
| 幻覚 | AIは知らないうちに情報を「作り上げる」 | ルールについて聞く → ルールはWHOが作った |
| 知識の限界 | AI はトレーニング時までのデータしか知りません | 今週のニュースについて質問する → 「わかりません」 |
| ドメインの知識がない | AI はあなたの個人データを知りません | 自社製品に関する質問 → 一般回答 |
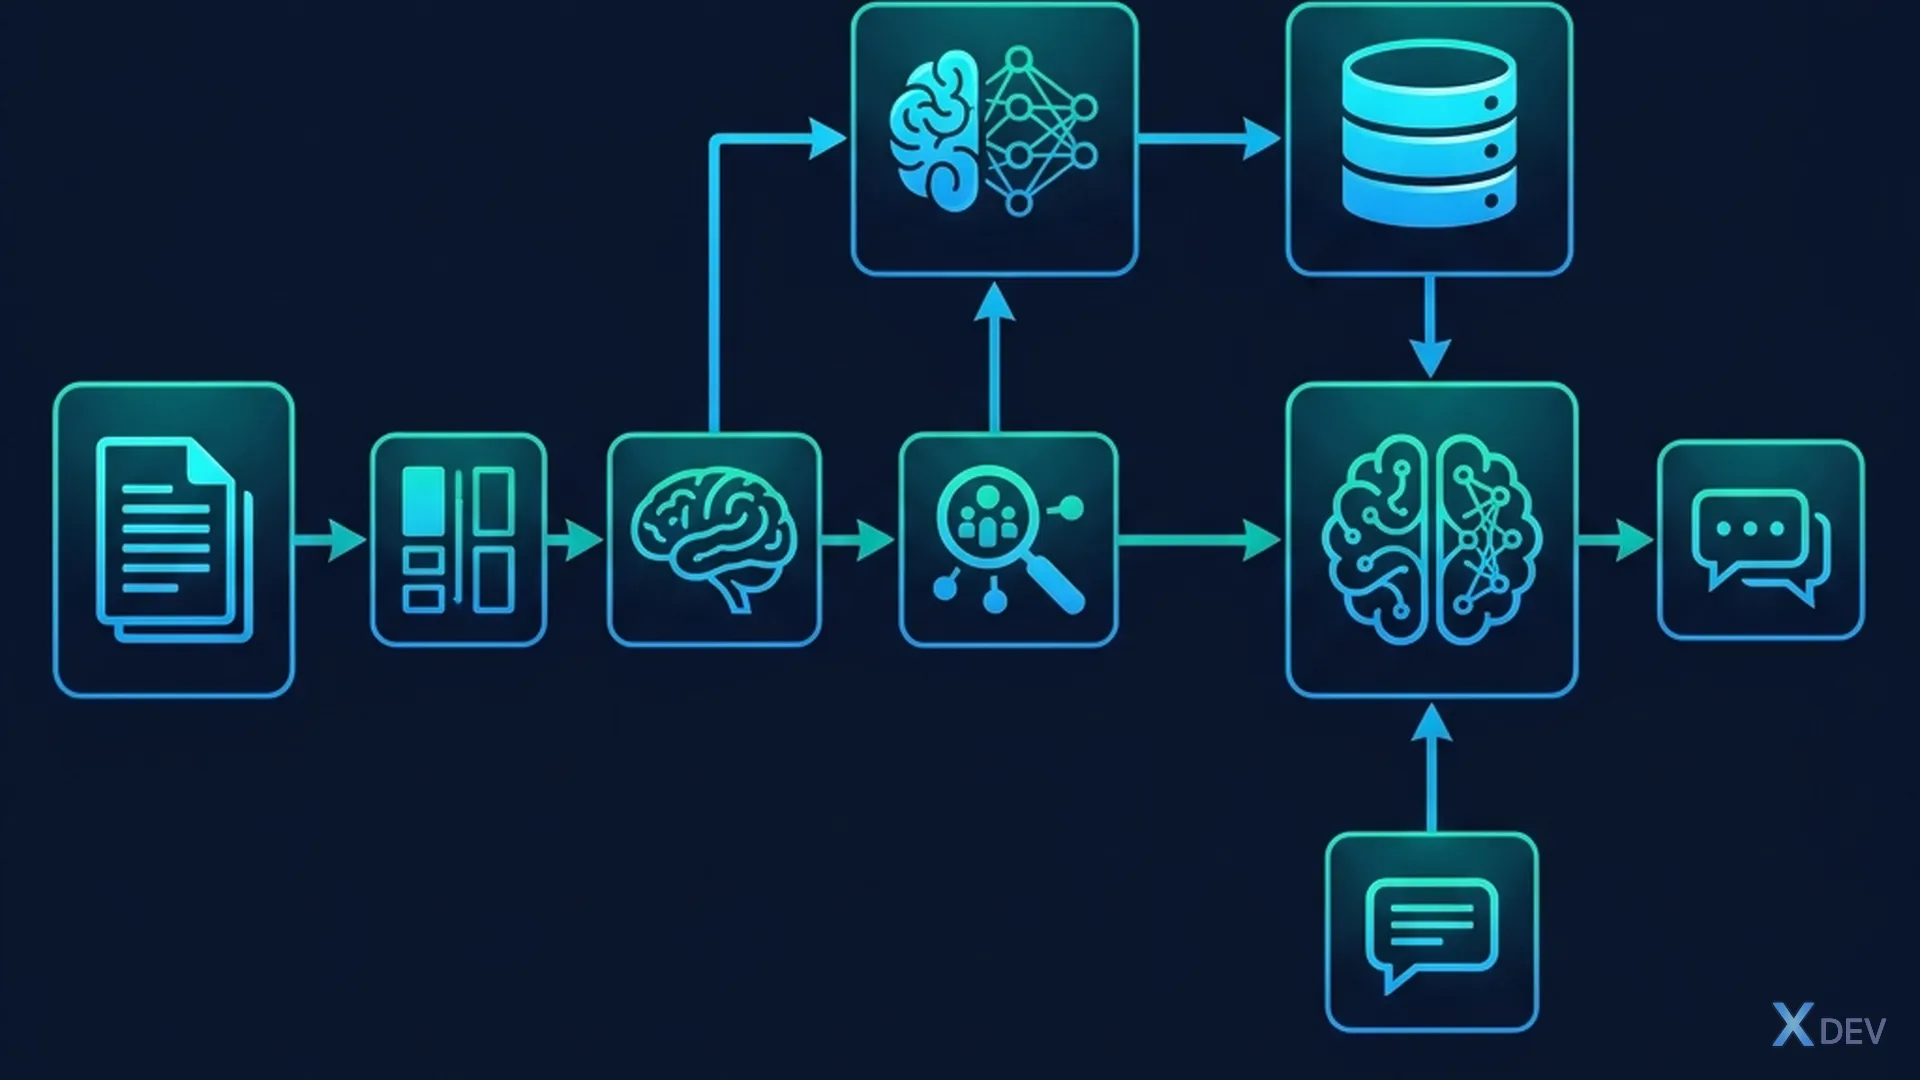
RAG (検索拡張生成) は、応答する前に LLM にドキュメントを「読み取らせる」ことで、3 つの問題すべてを解決します。
1. RAGとは何ですか?
1.1 主なアイデア
通常の生活の例: 口頭試験を受けると想像してください:
- RAG なし = 試験 閉じられた本 → 頭の中にある知識のみを使用する → 間違いやすく、忘れやすい
- はい RAG = オープンブック 試験 → 答える前に書類を調べることができます → はるかに正確です!
RAG = 答える前に AI に「本を開いて」もらいます。
1.2 RAG の 3 つのステップ
User hỏi: "Chính sách nghỉ phép 2026 là gì?"
                                          │
                                          ▼
                    ┌─────────────────────────┐
Step 1: RETRIEVE    │ Tìm tài liệu liên quan  │
(Tìm kiếm)         │ trong knowledge base     │
                    │ → "HR_Policy_2026.pdf"   │
                    │    trang 15-17            │
                    └──────────┬──────────────┘
                               ▼
                    ┌─────────────────────────┐
Step 2: AUGMENT     │ Ghép tài liệu tìm được  │
(Bổ sung)           │ vào prompt cho LLM       │
                    │ → "Dựa trên tài liệu    │
                    │    sau, trả lời câu hỏi" │
                    └──────────┬──────────────┘
                               ▼
                    ┌─────────────────────────┐
Step 3: GENERATE    │ LLM đọc tài liệu        │
(Trả lời)          │ + tạo câu trả lời        │
                    │ → "Theo chính sách 2026, │
                    │    nhân viên được 15 ngày │
                    │    phép/năm..."           │
                    └─────────────────────────┘
1.3 RAG が効果的なのはなぜですか?
| ラグなし | はいラグ |
|---|---|
| AIは「記憶」(教師データ)から答えます | 実際の文書から AI が回答 |
| 知らなくても補うことができます | 特定の情報源からの引用 |
| 古い知識(切り捨て) | ドキュメント リアルタイム更新 |
| 個人データがわからない | 個人データを読む |
2. RAG アーキテクチャの詳細
2.1 2 段階: インデックス作成とクエリ作成
=== GIAI ĐOẠN 1: INDEXING (làm 1 lần, offline) ===

Tài liệu gốc     →    Chunking    →    Embedding    →    Vector DB
[PDF, DOCX, Web]     [Chia nhỏ]      [Text → Vector]    [Lưu trữ]

company_policy.pdf → Chunk 1: 300 từ → [0.23, -0.15, ...] → ChromaDB
                     Chunk 2: 300 từ → [0.45, 0.22, ...]
                     Chunk 3: 300 từ → [-0.11, 0.67, ...]


=== GIAI ĐOẠN 2: QUERYING (mỗi câu hỏi, real-time) ===

Câu hỏi user → Embedding → Similarity Search → Top-K chunks → LLM → Answer
"Nghỉ phép              tìm chunks               ghép vào      trả lời
 bao nhiêu?"            gần nhất                  prompt        từ tài liệu
2.2 段階的な説明
ステップ 1 — チャンク化: 文書を小さな段落 (約 300 ~ 500 ワード) に分割します。なぜ? LLM のコンテキスト ウィンドウは限られているため、小さな断片の方が正確に検索しやすくなります。
ステップ 2 — 埋め込み: テキストを ベクター (数値シーケンス) に変換します。同様の意味を持つテキストセグメントは、高次元空間で 互いに近いベクトルを持ちます。
# "Chính sách nghỉ phép" → [0.23, -0.15, 0.87, ...]
# "Quy định ngày phép"   → [0.25, -0.12, 0.85, ...]  ← rất gần!
# "Lương thưởng"         → [-0.45, 0.55, 0.12, ...]  ← rất xa
ステップ 3 — 類似性検索: ユーザーが質問すると、質問を埋め込み、ベクトルが最も近いチャンクを見つけ、関連性の高い上位 K 個のチャンク (通常は K=3 ~ 5) を返します。
ステップ 4 — 生成: チャンクをプロンプトに結合し、LLM に送信します。
System: Trả lời câu hỏi dựa trên context được cung cấp.
        Nếu context không chứa câu trả lời, nói "Tôi không
        tìm thấy thông tin trong tài liệu."

Context:
---
[Chunk 1: "Theo chính sách 2026, nhân viên full-time được
15 ngày phép/năm. Nhân viên trên 5 năm được 18 ngày..."]
[Chunk 2: "Quy trình xin phép: gửi đơn trước 3 ngày..."]
---

User: Nhân viên mới được bao nhiêu ngày nghỉ phép?
💡 演習 2: 「図書館」の例を使用して、技術者以外の同僚に RAG を説明します: 図書館員 (検索者)、関連書籍 (コンテキスト)、学生 (LLM が自分で答えをまとめます)。 3~4文書いてみてください。
3. デモ: 50 行の「PDF でチャット」
これは、最も単純な RAG パイプラインです。Python + OpenAI + ChromaDB だけです。
3.1 インストール
pip install openai chromadb langchain langchain-openai \
            langchain-community pypdf
3.2 完全なコード
"""
RAG đơn giản nhất: Chat with PDF
50 dòng code — hiểu toàn bộ flow!
"""
from langchain_community.document_loaders import PyPDFLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_openai import OpenAIEmbeddings, ChatOpenAI
from langchain_community.vectorstores import Chroma
from langchain.prompts import ChatPromptTemplate
from langchain.schema.runnable import RunnablePassthrough

# === Bước 1: Load PDF ===
loader = PyPDFLoader("company_policy.pdf")
pages = loader.load()
print(f"Loaded {len(pages)} pages")

# === Bước 2: Chunking ===
splitter = RecursiveCharacterTextSplitter(
    chunk_size=500,     # Mỗi chunk ~500 ký tự
    chunk_overlap=50    # Overlap 50 ký tự (tránh cắt giữa câu)
)
chunks = splitter.split_documents(pages)
print(f"Split into {len(chunks)} chunks")

# === Bước 3: Embedding + Store vào Vector DB ===
embeddings = OpenAIEmbeddings(model="text-embedding-3-small")
vectorstore = Chroma.from_documents(chunks, embeddings)
retriever = vectorstore.as_retriever(search_kwargs={"k": 3})

# === Bước 4: RAG Chain ===
template = """Trả lời câu hỏi dựa trên context sau.
Nếu không tìm thấy, nói "Tôi không tìm thấy trong tài liệu."
Trích dẫn nguồn (trang số) nếu có thể.

Context:
{context}

Câu hỏi: {question}
"""
prompt = ChatPromptTemplate.from_template(template)
llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)

rag_chain = (
    {"context": retriever, "question": RunnablePassthrough()}
    | prompt
    | llm
)

# === Bước 5: Hỏi! ===
while True:
    question = input("\n❓ Hỏi: ")
    if question.lower() in ["quit", "exit"]:
        break
    answer = rag_chain.invoke(question)
    print(f"\n💬 {answer.content}")
3.3 フローの説明
User: "Nhân viên mới được bao nhiêu ngày phép?"
  ↓
1. Embedding câu hỏi → vector [0.3, -0.1, ...]
  ↓
2. Tìm 3 chunks gần nhất trong ChromaDB
  ↓
3. Ghép chunks vào template prompt
  ↓
4. Gửi cho GPT-4o-mini
  ↓
5. AI đọc chunks + trả lời: "Theo tài liệu trang 15,
   nhân viên mới được 15 ngày phép/năm..."
重要: AI は、でっちあげではなく、文書に基づいて答えます。これがRAGの強みです。
💡 演習 3:
- 任意の PDF ファイル (履歴書、教材、ドキュメント) で上記のコードを実行します。
- 5 つの質問をする: 3 つは PDF で回答あり、2 つは回答なし → AI はどのように処理しますか?
- 変更してみる
chunk_size=500に200そして1000—品質はどのように変化しますか?
4. RAG と微調整 — いつ何を使用するか?
これは最も一般的な質問です。「RAG モデルと微調整モデルを使用するべきですか?」
4.1 詳細な比較表
| 基準 | ラグ | 微調整 |
|---|---|---|
| 目的 | 知識 (知識) を追加する | 行動 (行動) を変更する |
| 例 | 会社のドキュメントからの返信 | ブランドの声に従って書く |
| セットアップ費用 | 低価格 (~$5-50) | 高 (~$50-500+) |
| 時間 | 数分 | 時間 → 日数 |
| データを更新 | ✅ リアルタイム更新 | ❌ 再トレーニングが必要 |
| 精度 | 曹操 (引用元) | 中等度 (おそらく幻覚) |
| スケーラブル | ✅ ドキュメントを簡単に追加 | ❌ スケーリングが難しい |
4.2 意思決定の枠組み
Câu hỏi quyết định:
                        ┌─ Cần AI biết data MỚI/RIÊNG? → RAG
                        │
Bạn cần gì? ────────── ├─ Cần AI thay đổi PHONG CÁCH/FORMAT? → Fine-tuning
                        │
                        ├─ Cần CẢ HAI? → RAG + Fine-tuning (Hybrid)
                        │
                        └─ Không chắc? → Thử RAG trước (rẻ, nhanh)
4.3 実践例
| 数学の問題 | 選択 | 理由 |
|---|---|---|
| チャットボットが 100 件のブログ投稿からの FAQ に回答 | ラグ | 知識のギャップ - 別のデータが必要 |
| AI が CEO の声でメールを作成 | 微調整 | 行動のギャップ - スタイルを変更する必要がある |
| AI が医師の薬探しをサポート | ラグ | 更新されたデータ + 出典の引用が必要 |
| AI がサポート チケットを分類 | 微調整 | タスク固有の動作 |
| 社内チャットボット + ブランドボイス | ハイブリッド | 知識と自分のスタイルの両方が必要 |
経験則: 迷った場合は、RAG から始めてください。 RAG は安価で高速で反復が簡単です。 RAG が不十分な場合にのみ微調整します。
5. 最も一般的な使用例
5.1 ビジネス
| 使用例 | 説明 | データソース |
|---|---|---|
| 社内ナレッジ ボット | 従業員がプロセスとポリシーについて尋ねる | 人事ドキュメント、SOP、wiki |
| カスタマーサポート | FAQ + 製品ドキュメントからのボット回答 | ヘルプセンター、マニュアル |
| 法務アシスタント | 法律と契約を調べる | 法的文書、契約書 |
| 販売促進 | ケーススタディ、競合情報を見つける | CRM データ、レポート |
5.2 個人/教育
| 使用例 | 説明 | データソース |
|---|---|---|
| スタディアシスタント | 「教科書とチャット」 - 教科書について質問する | PDF ブック、スライド |
| 研究ヘルパー | 50 以上の論文からの洞察の要約 | Arxiv 論文 |
| 個人Wiki | メモを取る + メモからの Q&A | 黒曜石、概念 |
| コードドキュメント | 10万行以上のコードベースについて質問する | ソースコード、ドキュメント |
5.3 AI 製品
| 使用例 | 実際の例 |
|---|---|
| Perplexity AI | 検索エンジン + RAG (ウェブ検索→返信) |
| Notion AI | Notion ワークスペースからの RAG |
| GitHub コパイロット | 現在のコードベースからの RAG |
| ChatGPT + ブラウズ | リアルタイム Web からの RAG |
💡 演習 5: 会社/プロジェクト/学校の RAG 使用例を 3 つ挙げてください。ユースケースごとに、データ ソース、ユーザー、成功指標を決定します。
6. 制限 — RAG は「特効薬」ではありません
| 制限事項 | 説明 | 解決策 (次のレッスンで学習します) |
|---|---|---|
| ゴミが入って、ゴミが出る | 不良データ → 不良 RAG | データ クリーニング (レッスン 5) |
| チャンクが小さすぎる/大きすぎる | コンテキストが失われた、またはノイズが多すぎる | チャンク戦略 (レッスン 5) |
| 曖昧なクエリ | レトリバーは正しい | を見つけられませんでした。クエリ変換 (レッスン 7) |
| 途中で迷ってしまった | LLM は | 間のコンテキストを無視します。再ランキング (レッスン 8) |
| マルチモーダル | PDF 内の画像/表が削除されました | マルチモーダル RAG (レッスン 10) |
概要
| コンセプト | 覚えておいてください |
|---|---|
| ラグ | 取得 → 拡張 → 生成 (試験「オープンブック」) |
| 解決済み | 幻覚、知識の遮断、専門知識 |
| インデックス作成 | チャンク → 埋め込み → 保存 (オフライン、1 回) |
| クエリ中 | クエリを埋め込む → 検索 → 拡張 → 生成 (リアルタイム) |
| 対微調整 | RAG = より多くの知識、微調整 = 行動を変える |
| から始まります | RAG ファースト (安価、高速、反復が容易) |
一般的な演習
- ✅ 小さな演習 (2、3、5) を完了する
- ハンズオン: パート 3 の「Chat with PDF」デモを実際のドキュメントを使用して実行します。結果のスクリーンショットを撮ります。
- アーキテクチャ図: パート 5 の特定の使用例に合わせて RAG アーキテクチャを再描画します (draw.io または Mermaid を使用)。
- 調査: 2026 年に最も使用されている 3 つの RAG ツール/製品を見つけます (ヒント: LangChain、LlamaIndex、Vercel AI SDK)。長所/短所を比較します。
次の記事: 埋め込みモデル — テキストをベクターに変換する方法、OpenAI、Cohere、オープンソースの比較、およびベトナム語での埋め込み。