簡介
您是否曾經向 ChatGPT 詢問過貴公司的規則並收到了...編造的答案?或詢問 上週 發生的事件,但 AI 說“我沒有 2024 年 4 月之後的信息”?
這是LLM的兩個最大問題:
| 問題 | 說明 | 範例 |
|---|---|---|
| 幻覺 | AI在不知不覺中「編造」訊息 | 詢問規則 → 誰制定了規則 |
| 知識截止 | AI 只知道訓練時的資料 | 詢問本週新聞→「我不知道」 |
| 沒有領域知識 | AI不知道你的私人資料 | 詢問公司產品 → 一般回答 |
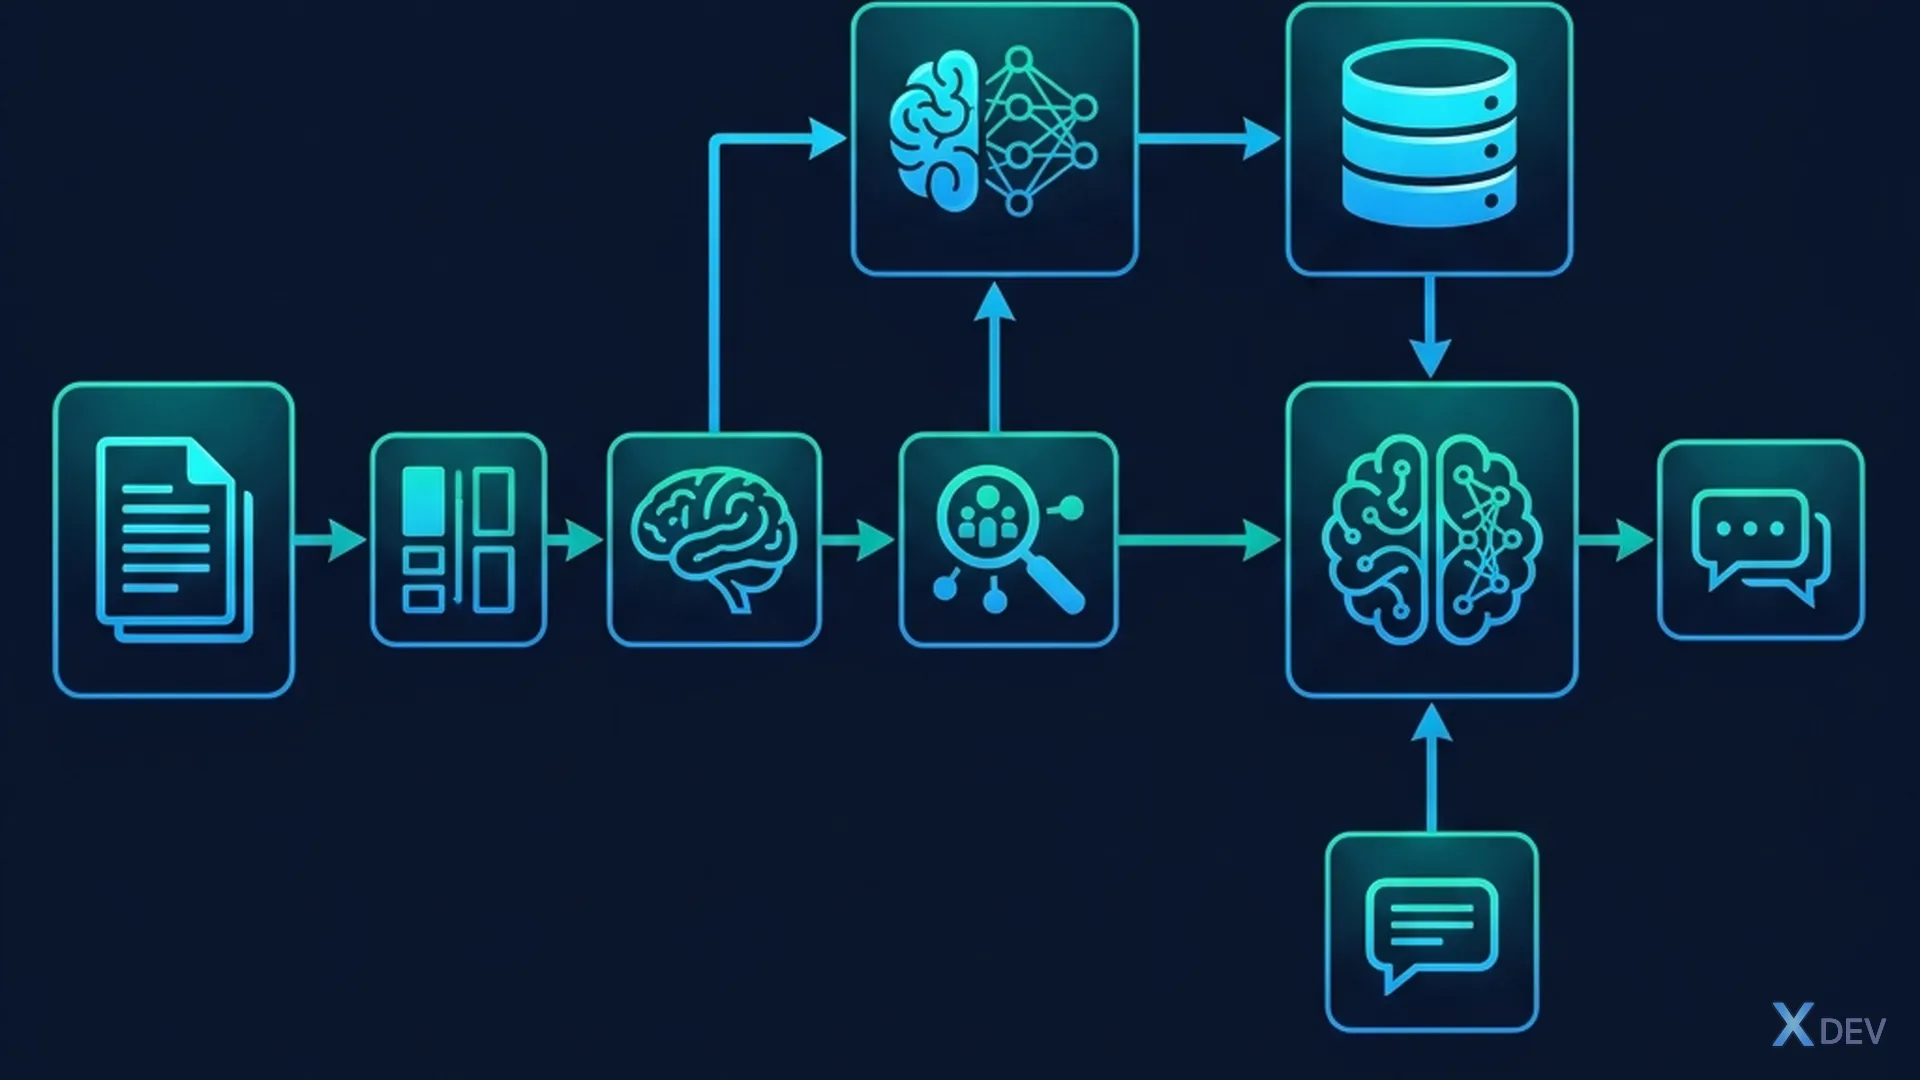
RAG (檢索增強生成)透過讓法學碩士在回復之前「閱讀」您的文件來解決所有 3 個問題。
1.什麼是RAG?
1.1 主要思想
**日常生活中的例子:**想像一下你參加口說考試:
- 無RAG = 考試閉卷 → 只使用頭腦中的知識 → 容易出錯,容易忘記
- 是的 RAG = 開卷考試 → 作答前可以查資料 → 更準確!
RAG = 請AI「打開書本」後再回答。
1.2 RAG的三步
User hỏi: "Chính sách nghỉ phép 2026 là gì?"
                                          │
                                          ▼
                    ┌─────────────────────────┐
Step 1: RETRIEVE    │ Tìm tài liệu liên quan  │
(Tìm kiếm)         │ trong knowledge base     │
                    │ → "HR_Policy_2026.pdf"   │
                    │    trang 15-17            │
                    └──────────┬──────────────┘
                               ▼
                    ┌─────────────────────────┐
Step 2: AUGMENT     │ Ghép tài liệu tìm được  │
(Bổ sung)           │ vào prompt cho LLM       │
                    │ → "Dựa trên tài liệu    │
                    │    sau, trả lời câu hỏi" │
                    └──────────┬──────────────┘
                               ▼
                    ┌─────────────────────────┐
Step 3: GENERATE    │ LLM đọc tài liệu        │
(Trả lời)          │ + tạo câu trả lời        │
                    │ → "Theo chính sách 2026, │
                    │    nhân viên được 15 ngày │
                    │    phép/năm..."           │
                    └─────────────────────────┘
1.3 為什麼RAG有效?
| 沒有抹布 | 是的 RAG |
|---|---|
| AI從「記憶」回答(訓練資料) | 來自真實文件的人工智慧答案 |
| 不知道的可以補 | 特定來源的引用 |
| 舊知識(截止) | 文件即時更新 |
| 不知道私人資料 | 閱讀您的私人資料 |
2. RAG架構詳解
2.1 兩個階段:索引與查詢
=== GIAI ĐOẠN 1: INDEXING (làm 1 lần, offline) ===

Tài liệu gốc     →    Chunking    →    Embedding    →    Vector DB
[PDF, DOCX, Web]     [Chia nhỏ]      [Text → Vector]    [Lưu trữ]

company_policy.pdf → Chunk 1: 300 từ → [0.23, -0.15, ...] → ChromaDB
                     Chunk 2: 300 từ → [0.45, 0.22, ...]
                     Chunk 3: 300 từ → [-0.11, 0.67, ...]


=== GIAI ĐOẠN 2: QUERYING (mỗi câu hỏi, real-time) ===

Câu hỏi user → Embedding → Similarity Search → Top-K chunks → LLM → Answer
"Nghỉ phép              tìm chunks               ghép vào      trả lời
 bao nhiêu?"            gần nhất                  prompt        từ tài liệu
2.2 逐步解釋
** 步驟 1 — 分塊:** 將文件分成小段落(約 300-500 個字)。為什麼?由於LLM的上下文視窗有限,小片段更容易準確搜尋。
第 2 步 — 嵌入: 將文字轉換為 向量(數字序列)。具有相似意義的文本片段在高維空間中將具有彼此接近的向量。
# "Chính sách nghỉ phép" → [0.23, -0.15, 0.87, ...]
# "Quy định ngày phép"   → [0.25, -0.12, 0.85, ...]  ← rất gần!
# "Lương thưởng"         → [-0.45, 0.55, 0.12, ...]  ← rất xa
**步驟3-相似性搜尋:**當使用者提問時,嵌入問題→找到向量最接近的區塊→傳回前K個最相關的區塊(通常K=3-5)。
第 4 步 — 產生: 將區塊合併到提示中,發送給 LLM:
System: Trả lời câu hỏi dựa trên context được cung cấp.
        Nếu context không chứa câu trả lời, nói "Tôi không
        tìm thấy thông tin trong tài liệu."

Context:
---
[Chunk 1: "Theo chính sách 2026, nhân viên full-time được
15 ngày phép/năm. Nhân viên trên 5 năm được 18 ngày..."]
[Chunk 2: "Quy trình xin phép: gửi đơn trước 3 ngày..."]
---

User: Nhân viên mới được bao nhiêu ngày nghỉ phép?
💡練習 2: 使用「圖書館」範例向非技術同事解釋 RAG:圖書館員(檢索員)、相關書籍(上下文)、學生(LLM 自己編譯答案)。試著寫 3-4 句話。
3. 示範:50 行“用 PDF 聊天”
這是最簡單的 RAG 管道 - 只需 Python + OpenAI + ChromaDB:
3.1 安裝
pip install openai chromadb langchain langchain-openai \
            langchain-community pypdf
3.2 完整程式碼
"""
RAG đơn giản nhất: Chat with PDF
50 dòng code — hiểu toàn bộ flow!
"""
from langchain_community.document_loaders import PyPDFLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_openai import OpenAIEmbeddings, ChatOpenAI
from langchain_community.vectorstores import Chroma
from langchain.prompts import ChatPromptTemplate
from langchain.schema.runnable import RunnablePassthrough

# === Bước 1: Load PDF ===
loader = PyPDFLoader("company_policy.pdf")
pages = loader.load()
print(f"Loaded {len(pages)} pages")

# === Bước 2: Chunking ===
splitter = RecursiveCharacterTextSplitter(
    chunk_size=500,     # Mỗi chunk ~500 ký tự
    chunk_overlap=50    # Overlap 50 ký tự (tránh cắt giữa câu)
)
chunks = splitter.split_documents(pages)
print(f"Split into {len(chunks)} chunks")

# === Bước 3: Embedding + Store vào Vector DB ===
embeddings = OpenAIEmbeddings(model="text-embedding-3-small")
vectorstore = Chroma.from_documents(chunks, embeddings)
retriever = vectorstore.as_retriever(search_kwargs={"k": 3})

# === Bước 4: RAG Chain ===
template = """Trả lời câu hỏi dựa trên context sau.
Nếu không tìm thấy, nói "Tôi không tìm thấy trong tài liệu."
Trích dẫn nguồn (trang số) nếu có thể.

Context:
{context}

Câu hỏi: {question}
"""
prompt = ChatPromptTemplate.from_template(template)
llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)

rag_chain = (
    {"context": retriever, "question": RunnablePassthrough()}
    | prompt
    | llm
)

# === Bước 5: Hỏi! ===
while True:
    question = input("\n❓ Hỏi: ")
    if question.lower() in ["quit", "exit"]:
        break
    answer = rag_chain.invoke(question)
    print(f"\n💬 {answer.content}")
3.3 解釋流程
User: "Nhân viên mới được bao nhiêu ngày phép?"
  ↓
1. Embedding câu hỏi → vector [0.3, -0.1, ...]
  ↓
2. Tìm 3 chunks gần nhất trong ChromaDB
  ↓
3. Ghép chunks vào template prompt
  ↓
4. Gửi cho GPT-4o-mini
  ↓
5. AI đọc chunks + trả lời: "Theo tài liệu trang 15,
   nhân viên mới được 15 ngày phép/năm..."
重要提示:人工智慧答案基於文件,而非編造!這是RAG的核心優勢。
💡練習 3:
- 使用任何 PDF 檔案(履歷、學習材料、文件)來執行上述程式碼。
- 問 5 個問題:3 個有 PDF 答案,2 個沒有 → AI 如何處理? 3.嘗試改變
chunk_size=500進入200和1000— 品質如何改變?
4. RAG 與微調 — 何時使用什麼?
這是最常見的問題:“我應該使用 RAG 還是微調模型?”
4.1 詳細比較表
| 標準 | 抹布 | 微調 |
|---|---|---|
| 目的 | 加入知識(知識) | 改變行為(行為) |
| 範例 | 公司文件回覆 | 依照品牌聲音來寫 |
| 設定成本 | 低 (~$5-50) | 高 (~$50-500+) |
| 時間 | 幾分鐘 | 小時 → 天 |
| 更新資料 | ✅ 即時更新 | ❌必須重新訓練 |
| 準確度 | 曹(引用來源) | 中度(可能產生幻覺) |
| 可擴充 | ✅ 輕鬆新增文件 | ❌ 難以擴充 |
4.2 決策框架
Câu hỏi quyết định:
                        ┌─ Cần AI biết data MỚI/RIÊNG? → RAG
                        │
Bạn cần gì? ────────── ├─ Cần AI thay đổi PHONG CÁCH/FORMAT? → Fine-tuning
                        │
                        ├─ Cần CẢ HAI? → RAG + Fine-tuning (Hybrid)
                        │
                        └─ Không chắc? → Thử RAG trước (rẻ, nhanh)
4.3 實際例子
| 數學問題 | 選擇 | 原因 |
|---|---|---|
| 聊天機器人回答 100 篇部落格文章中的常見問題 | 抹布 | 知識差距-需要單獨的數據 |
| 人工智慧以執行長的聲音寫電子郵件 | 微調 | 行為差距-需要改變風格 |
| AI支援醫生查找藥品 | 抹布 | 需要更新資料+來源引用 |
| AI 將支援票分類 | 微調 | 特定於任務的行為 |
| 內部聊天機器人+品牌聲音 | 混合 | 需要知識+自己的風格 |
經驗法則: 如果有疑問,從 RAG 開始。 RAG 便宜、快速、易於迭代。僅當 RAG 不夠時才進行微調。
5. 最常見的用例
5.1 商業
| 使用案例 | 描述 | 資料來源 |
|---|---|---|
| 內部知識機器人 | 員工詢問流程和政策 | HR 文件、SOP、wiki |
| 客戶支援 | 常見問題解答 + 產品文件中的機器人答案 | 幫助中心、手冊 |
| 法律助理 | 尋找法律和合約 | 法律文件、合約 |
| 銷售支援 | 尋找案例研究、競爭情報 | CRM 數據、報告 |
5.2 個人/教育
| 使用案例 | 描述 | 資料來源 |
|---|---|---|
| 學習助理 | 「與教科書對話」—問教科書問題 | PDF 書籍、幻燈片 |
| 研究助理 | 50 多篇論文的見解摘要 | Arxiv 論文 |
| 個人維基 | 筆記+筆記問答 | 黑曜石,概念 |
| 程式碼文檔 | 詢問 100K+ 行程式碼庫 | 原始碼、文檔 |
5.3 人工智慧產品
| 使用案例 | 現實生活中的例子 |
|---|---|
| 困惑人工智慧 | 搜尋引擎+RAG(搜尋網頁→回覆) |
| 概念人工智慧 | 來自您的 Notion 工作區的 RAG |
| GitHub 副駕駛 | 目前程式碼庫中的 RAG |
| 聊天GPT + 瀏覽 | 來自即時網路的 RAG |
💡練習 5: 為您的公司/專案/學校列出 3 個 RAG 用例。對於每個用例,確定:資料來源、使用者是誰以及成功指標。
6. 限制 — RAG 不是“靈丹妙藥”
| 限制 | 說明 | 解決方案(下一課學習) |
|---|---|---|
| 垃圾進,垃圾出 | 壞資料 → 壞 RAG | 資料清理(第 5 課) |
| 塊太小/太大 | 失去上下文或太多噪音 | 分塊策略(第 5 課) |
| 不明確的查詢 | 檢索器未找到正確的 | 查詢轉換(第 7 課) |
| 迷失在中間 | LLM 忽略 | 之間的上下文重新排名(第 8 課) |
| 多式聯運 | PDF 中的圖像/表格已刪除 | 多式聯運 RAG(第 10 課) |
總結
| 概念 | 記住 |
|---|---|
| 抹布 | 檢索→增強→產生(考試「開卷」) |
| 已解決 | 幻覺、知識斷絕、領域知識 |
| 索引 | 區塊→嵌入→儲存(離線,1次) |
| 查詢 | 嵌入查詢→搜尋→增強→產生(即時) |
| 與微調 | RAG = 更多知識,微調 = 改變行為 |
| 開頭為 | RAG 第一(便宜、快速、易於迭代) |
一般練習
- ✅ 完成小練習(2、3、5)
- 實務: 使用真實文件執行第 3 部分中的「使用 PDF 聊天」簡報。截取結果的螢幕截圖。
- 架構圖: 在第 5 部分中為特定用例重新繪製 RAG 架構(使用 draw.io 或 Mermaid)。
- **研究:**找到2026年最常用的3個RAG工具/產品(提示:LangChain、LlamaIndex、Vercel AI SDK)。比較優點/缺點。
下一篇文章: 嵌入模型 — 如何將文字轉換為向量、比較 OpenAI、Cohere 與開源,以及越南語嵌入。