Giới thiệu
Bạn có bao giờ hỏi ChatGPT về nội quy công ty bạn và nhận được câu trả lời... bịa? Hoặc hỏi về sự kiện tuần trước nhưng AI nói "Tôi không có thông tin sau tháng 4/2024"?
Đó là 2 vấn đề lớn nhất của LLM:
| Vấn đề | Giải thích | Ví dụ |
|---|---|---|
| Hallucination | AI "bịa" thông tin khi không biết | Hỏi về nội quy → AI bịa nội quy |
| Knowledge Cutoff | AI chỉ biết dữ liệu đến thời điểm training | Hỏi tin tức tuần này → "Tôi không biết" |
| No Domain Knowledge | AI không biết dữ liệu riêng của bạn | Hỏi về sản phẩm công ty → trả lời chung chung |
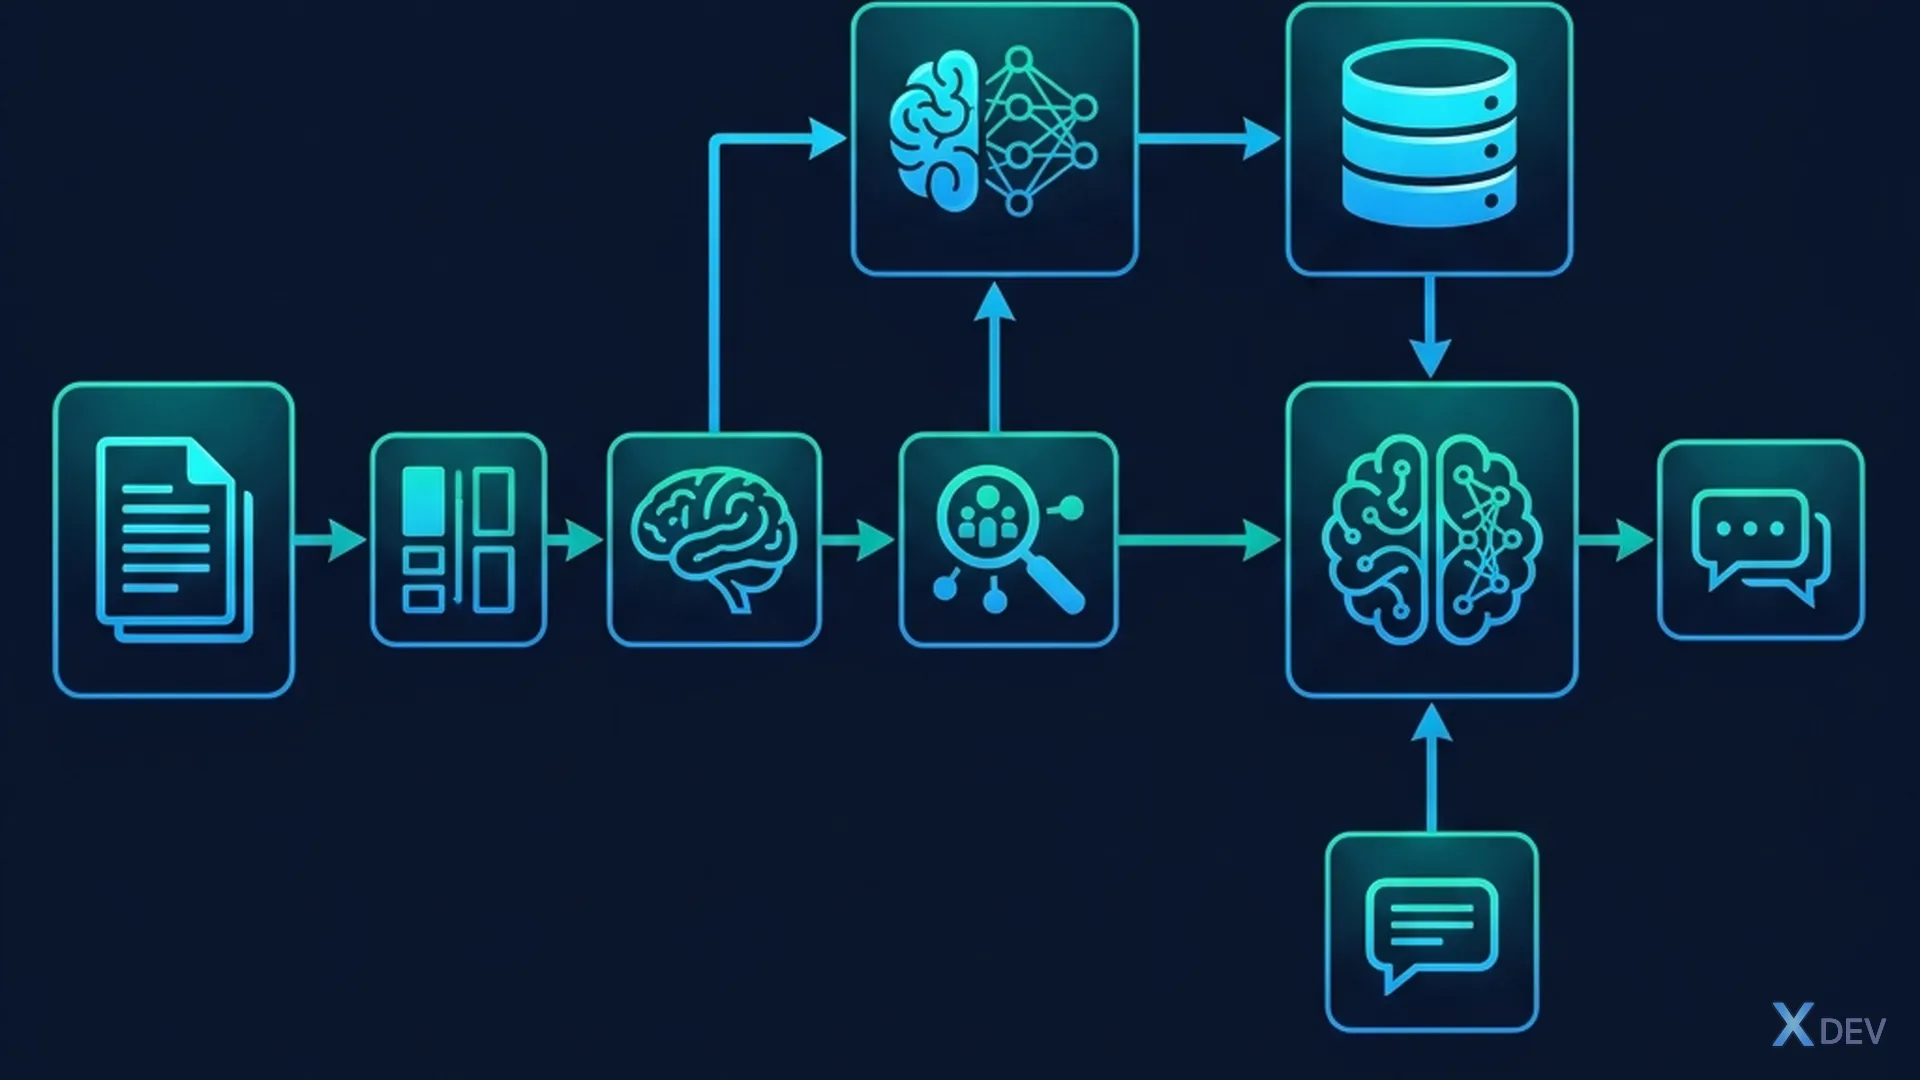
RAG (Retrieval-Augmented Generation) giải quyết cả 3 vấn đề bằng cách cho LLM "đọc" tài liệu của bạn trước khi trả lời.
1. RAG là gì?
1.1 Ý tưởng chính
Ví dụ đời thường: Hãy tưởng tượng bạn đi thi vấn đáp:
- Không có RAG = Thi đóng sách → chỉ dùng kiến thức trong đầu → dễ sai, dễ quên
- Có RAG = Thi mở sách → được tra tài liệu trước khi trả lời → chính xác hơn nhiều!
RAG = Cho AI "mở sách" trước khi trả lời.
1.2 Ba bước của RAG
User hỏi: "Chính sách nghỉ phép 2026 là gì?"
                                          │
                                          ▼
                    ┌─────────────────────────┐
Step 1: RETRIEVE    │ Tìm tài liệu liên quan  │
(Tìm kiếm)         │ trong knowledge base     │
                    │ → "HR_Policy_2026.pdf"   │
                    │    trang 15-17            │
                    └──────────┬──────────────┘
                               ▼
                    ┌─────────────────────────┐
Step 2: AUGMENT     │ Ghép tài liệu tìm được  │
(Bổ sung)           │ vào prompt cho LLM       │
                    │ → "Dựa trên tài liệu    │
                    │    sau, trả lời câu hỏi" │
                    └──────────┬──────────────┘
                               ▼
                    ┌─────────────────────────┐
Step 3: GENERATE    │ LLM đọc tài liệu        │
(Trả lời)          │ + tạo câu trả lời        │
                    │ → "Theo chính sách 2026, │
                    │    nhân viên được 15 ngày │
                    │    phép/năm..."           │
                    └─────────────────────────┘
1.3 Tại sao RAG hiệu quả?
| Không có RAG | Có RAG |
|---|---|
| AI trả lời từ "trí nhớ" (training data) | AI trả lời từ tài liệu thực |
| Có thể bịa nếu không biết | Trích dẫn từ nguồn cụ thể |
| Kiến thức cũ (cutoff) | Tài liệu cập nhật real-time |
| Không biết data riêng | Đọc data riêng của bạn |
2. Kiến trúc RAG chi tiết
2.1 Hai giai đoạn: Indexing & Querying
=== GIAI ĐOẠN 1: INDEXING (làm 1 lần, offline) ===

Tài liệu gốc     →    Chunking    →    Embedding    →    Vector DB
[PDF, DOCX, Web]     [Chia nhỏ]      [Text → Vector]    [Lưu trữ]

company_policy.pdf → Chunk 1: 300 từ → [0.23, -0.15, ...] → ChromaDB
                     Chunk 2: 300 từ → [0.45, 0.22, ...]
                     Chunk 3: 300 từ → [-0.11, 0.67, ...]


=== GIAI ĐOẠN 2: QUERYING (mỗi câu hỏi, real-time) ===

Câu hỏi user → Embedding → Similarity Search → Top-K chunks → LLM → Answer
"Nghỉ phép              tìm chunks               ghép vào      trả lời
 bao nhiêu?"            gần nhất                  prompt        từ tài liệu
2.2 Giải thích từng bước
Bước 1 — Chunking: Chia tài liệu thành các đoạn nhỏ (~300-500 từ). Tại sao? Vì LLM có giới hạn context window, và đoạn nhỏ dễ tìm kiếm chính xác hơn.
Bước 2 — Embedding: Biến text thành vector (dãy số). Các đoạn text có ý nghĩa tương tự sẽ có vector gần nhau trong không gian nhiều chiều.
# "Chính sách nghỉ phép" → [0.23, -0.15, 0.87, ...]
# "Quy định ngày phép"   → [0.25, -0.12, 0.85, ...]  ← rất gần!
# "Lương thưởng"         → [-0.45, 0.55, 0.12, ...]  ← rất xa
Bước 3 — Similarity Search: Khi user hỏi, embedding câu hỏi → tìm chunks có vector gần nhất → trả về top-K chunks liên quan nhất (thường K=3-5).
Bước 4 — Generate: Ghép chunks vào prompt, gửi cho LLM:
System: Trả lời câu hỏi dựa trên context được cung cấp.
        Nếu context không chứa câu trả lời, nói "Tôi không
        tìm thấy thông tin trong tài liệu."

Context:
---
[Chunk 1: "Theo chính sách 2026, nhân viên full-time được
15 ngày phép/năm. Nhân viên trên 5 năm được 18 ngày..."]
[Chunk 2: "Quy trình xin phép: gửi đơn trước 3 ngày..."]
---

User: Nhân viên mới được bao nhiêu ngày nghỉ phép?
💡 Bài tập 2: Giải thích RAG cho đồng nghiệp non-tech bằng ví dụ "thư viện": thủ thư (retriever), sách liên quan (context), sinh viên (LLM tự tổng hợp câu trả lời). Thử viết 3-4 câu.
3. Demo: "Chat with PDF" trong 50 dòng
Đây là RAG pipeline đơn giản nhất — chỉ cần Python + OpenAI + ChromaDB:
3.1 Cài đặt
pip install openai chromadb langchain langchain-openai \
            langchain-community pypdf
3.2 Code hoàn chỉnh
"""
RAG đơn giản nhất: Chat with PDF
50 dòng code — hiểu toàn bộ flow!
"""
from langchain_community.document_loaders import PyPDFLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_openai import OpenAIEmbeddings, ChatOpenAI
from langchain_community.vectorstores import Chroma
from langchain.prompts import ChatPromptTemplate
from langchain.schema.runnable import RunnablePassthrough

# === Bước 1: Load PDF ===
loader = PyPDFLoader("company_policy.pdf")
pages = loader.load()
print(f"Loaded {len(pages)} pages")

# === Bước 2: Chunking ===
splitter = RecursiveCharacterTextSplitter(
    chunk_size=500,     # Mỗi chunk ~500 ký tự
    chunk_overlap=50    # Overlap 50 ký tự (tránh cắt giữa câu)
)
chunks = splitter.split_documents(pages)
print(f"Split into {len(chunks)} chunks")

# === Bước 3: Embedding + Store vào Vector DB ===
embeddings = OpenAIEmbeddings(model="text-embedding-3-small")
vectorstore = Chroma.from_documents(chunks, embeddings)
retriever = vectorstore.as_retriever(search_kwargs={"k": 3})

# === Bước 4: RAG Chain ===
template = """Trả lời câu hỏi dựa trên context sau.
Nếu không tìm thấy, nói "Tôi không tìm thấy trong tài liệu."
Trích dẫn nguồn (trang số) nếu có thể.

Context:
{context}

Câu hỏi: {question}
"""
prompt = ChatPromptTemplate.from_template(template)
llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)

rag_chain = (
    {"context": retriever, "question": RunnablePassthrough()}
    | prompt
    | llm
)

# === Bước 5: Hỏi! ===
while True:
    question = input("\n❓ Hỏi: ")
    if question.lower() in ["quit", "exit"]:
        break
    answer = rag_chain.invoke(question)
    print(f"\n💬 {answer.content}")
3.3 Giải thích flow
User: "Nhân viên mới được bao nhiêu ngày phép?"
  ↓
1. Embedding câu hỏi → vector [0.3, -0.1, ...]
  ↓
2. Tìm 3 chunks gần nhất trong ChromaDB
  ↓
3. Ghép chunks vào template prompt
  ↓
4. Gửi cho GPT-4o-mini
  ↓
5. AI đọc chunks + trả lời: "Theo tài liệu trang 15,
   nhân viên mới được 15 ngày phép/năm..."
Quan trọng: AI trả lời dựa trên tài liệu, không phải tự bịa! Đây là sức mạnh cốt lõi của RAG.
💡 Bài tập 3:
- Chạy code trên với 1 file PDF bất kỳ (CV, tài liệu học, docs).
- Hỏi 5 câu: 3 câu có đáp án trong PDF, 2 câu không có → AI xử lý thế nào?
- Thử thay
chunk_size=500thành200và1000— chất lượng thay đổi ra sao?
4. RAG vs Fine-tuning — Khi nào dùng gì?
Đây là câu hỏi phổ biến nhất: "Tôi nên dùng RAG hay fine-tune model?"
4.1 Bảng so sánh chi tiết
| Tiêu chí | RAG | Fine-tuning |
|---|---|---|
| Mục đích | Thêm knowledge (kiến thức) | Thay đổi behavior (hành vi) |
| Ví dụ | Trả lời từ docs công ty | Viết theo brand voice |
| Chi phí setup | Thấp (~$5-50) | Cao (~$50-500+) |
| Thời gian | Vài phút | Vài giờ → ngày |
| Update data | ✅ Cập nhật real-time | ❌ Phải re-train |
| Accuracy | Cao (trích dẫn nguồn) | Trung bình (có thể hallucinate) |
| Scalable | ✅ Thêm docs dễ | ❌ Khó scale |
4.2 Decision Framework
Câu hỏi quyết định:
                        ┌─ Cần AI biết data MỚI/RIÊNG? → RAG
                        │
Bạn cần gì? ────────── ├─ Cần AI thay đổi PHONG CÁCH/FORMAT? → Fine-tuning
                        │
                        ├─ Cần CẢ HAI? → RAG + Fine-tuning (Hybrid)
                        │
                        └─ Không chắc? → Thử RAG trước (rẻ, nhanh)
4.3 Ví dụ thực tế
| Bài toán | Chọn | Lý do |
|---|---|---|
| Chatbot trả lời FAQ từ 100 bài blog | RAG | Knowledge gap — cần data riêng |
| AI viết email theo giọng CEO | Fine-tuning | Behavior gap — cần thay đổi style |
| AI hỗ trợ bác sĩ tra cứu thuốc | RAG | Cần data cập nhật + trích dẫn nguồn |
| AI phân loại ticket support | Fine-tuning | Task-specific behavior |
| Chatbot nội bộ + brand voice | Hybrid | Cần cả knowledge + style riêng |
Quy tắc ngón cái: Nếu không chắc, bắt đầu bằng RAG. RAG rẻ, nhanh, dễ iterate. Fine-tuning chỉ khi RAG không đủ.
5. Use Cases phổ biến nhất
5.1 Doanh nghiệp
| Use Case | Mô tả | Nguồn data |
|---|---|---|
| Internal Knowledge Bot | Nhân viên hỏi về quy trình, chính sách | HR docs, SOPs, wiki |
| Customer Support | Bot trả lời từ FAQ + docs sản phẩm | Help center, manuals |
| Legal Assistant | Tra cứu luật, hợp đồng | Văn bản pháp luật, contracts |
| Sales Enablement | Tìm case studies, competitive intel | CRM data, reports |
5.2 Cá nhân / Giáo dục
| Use Case | Mô tả | Nguồn data |
|---|---|---|
| Study Assistant | "Chat with textbook" — hỏi bài giáo khoa | PDF sách, slides |
| Research Helper | Tổng hợp insights từ 50+ papers | Arxiv papers |
| Personal Wiki | Note-taking + Q&A từ notes | Obsidian, Notion |
| Code Documentation | Hỏi về codebase 100K+ dòng | Source code, docs |
5.3 Sản phẩm AI
| Use Case | Ví dụ thực tế |
|---|---|
| Perplexity AI | Search engine + RAG (search web → trả lời) |
| Notion AI | RAG từ workspace Notion của bạn |
| GitHub Copilot | RAG từ codebase hiện tại |
| ChatGPT + Browse | RAG từ web real-time |
💡 Bài tập 5: Liệt kê 3 use cases RAG cho công ty / dự án / trường học của bạn. Với mỗi use case, xác định: nguồn data, ai là user, và metric thành công.
6. Limitations — RAG không phải "silver bullet"
| Limitation | Giải thích | Giải pháp (học ở bài sau) |
|---|---|---|
| Garbage in, garbage out | Data xấu → RAG xấu | Data cleaning (Bài 5) |
| Chunk quá nhỏ/lớn | Mất context hoặc quá nhiều noise | Chunking strategies (Bài 5) |
| Query mơ hồ | Retriever không tìm đúng | Query transformation (Bài 7) |
| Lost in the middle | LLM bỏ qua context ở giữa | Re-ranking (Bài 8) |
| Multimodal | Ảnh/bảng trong PDF bị bỏ | Multimodal RAG (Bài 10) |
Tóm tắt
| Concept | Ghi nhớ |
|---|---|
| RAG | Retrieve → Augment → Generate (thi "mở sách") |
| Giải quyết | Hallucination, knowledge cutoff, domain knowledge |
| Indexing | Chunk → Embed → Store (offline, 1 lần) |
| Querying | Embed query → Search → Augment → Generate (real-time) |
| vs Fine-tuning | RAG = thêm knowledge, Fine-tuning = thay đổi behavior |
| Bắt đầu bằng | RAG trước (rẻ, nhanh, dễ iterate) |
Bài tập tổng hợp
- ✅ Hoàn thành bài tập nhỏ (2, 3, 5)
- Hands-on: Chạy demo "Chat with PDF" ở phần 3 với tài liệu thật. Chụp screenshot kết quả.
- Architecture Diagram: Vẽ lại kiến trúc RAG cho 1 use case cụ thể ở phần 5 (dùng draw.io hoặc Mermaid).
- Research: Tìm 3 tools/sản phẩm RAG đang được dùng nhiều nhất 2026 (hint: LangChain, LlamaIndex, Vercel AI SDK). So sánh ưu/nhược.
Bài tiếp theo: Embedding Models — cách biến text thành vector, so sánh OpenAI vs Cohere vs Open-source, và embedding tiếng Việt.