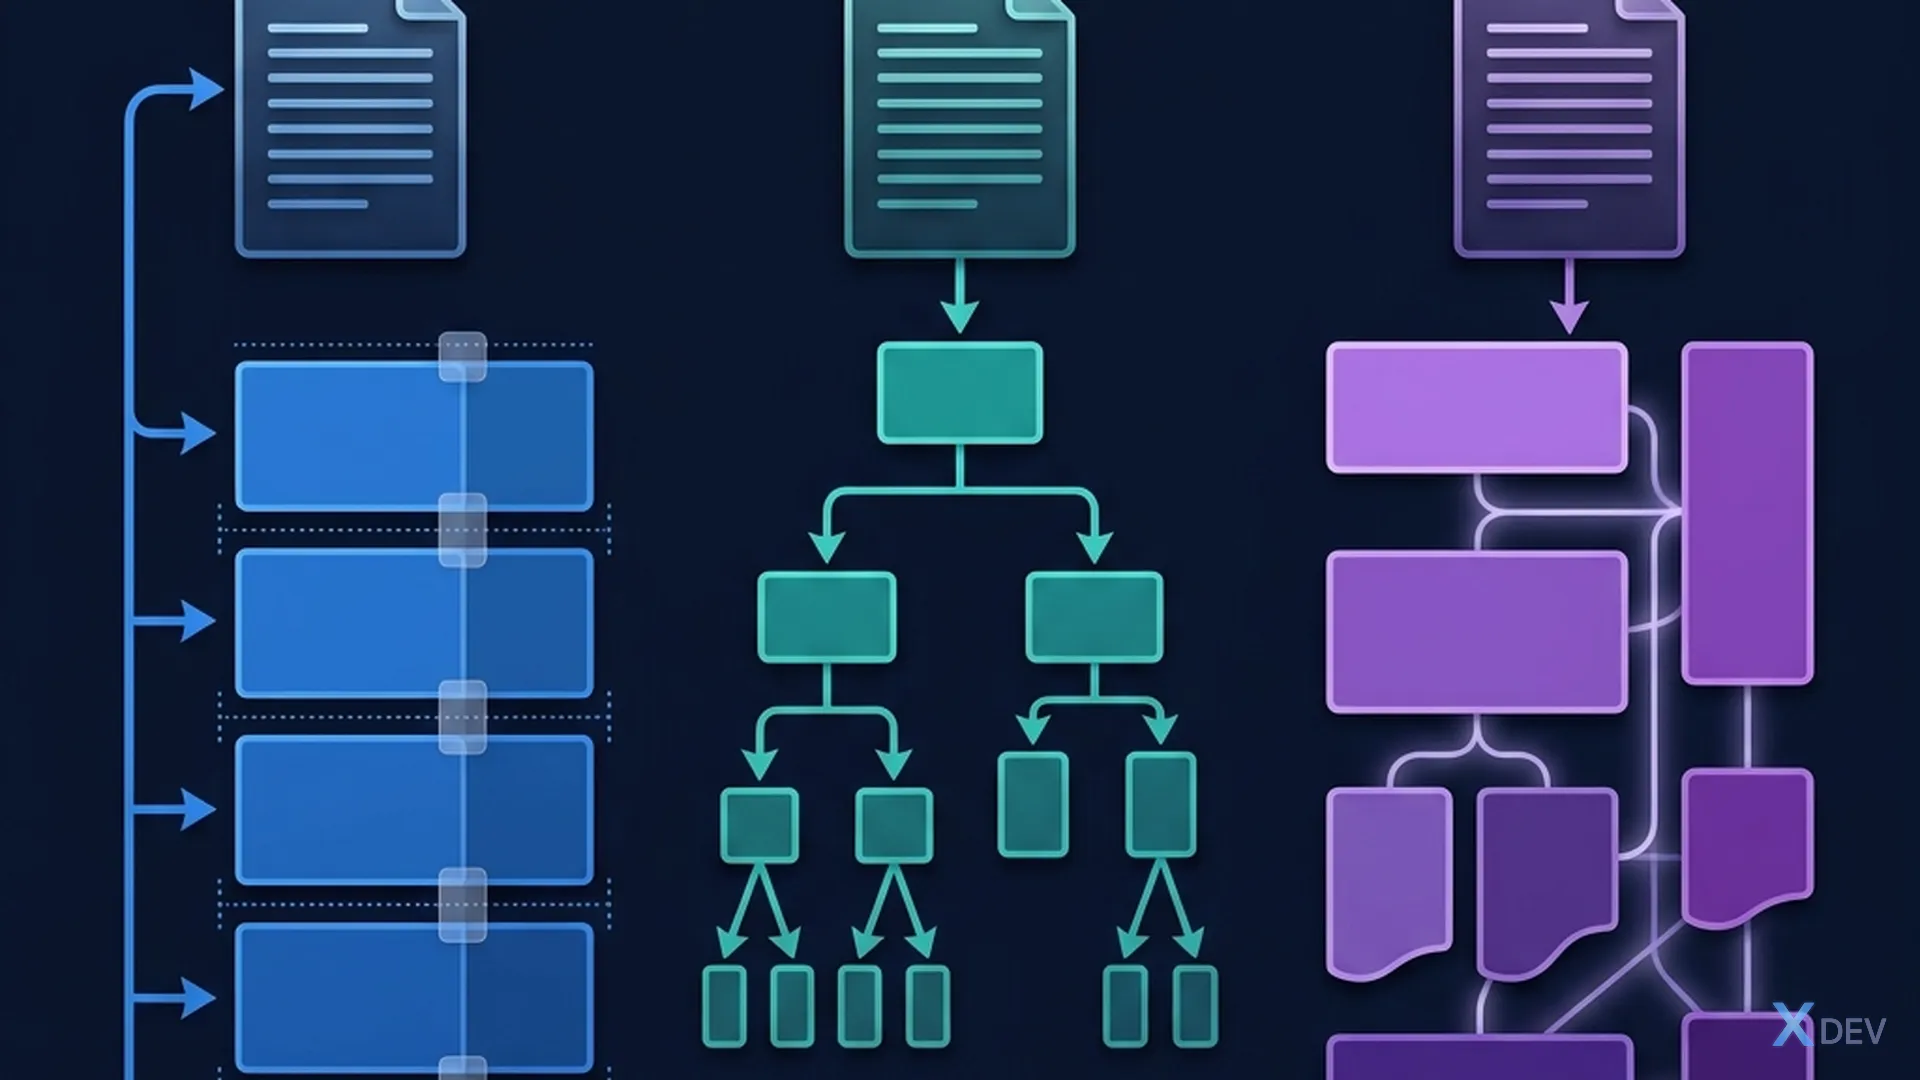
はじめに
ドキュメントをロードした後 (レッスン 4)、次のステップは チャンク化です。これは、検索の品質の 60% を決定するステップです。つまり、間違ったチャンク サイズを選択する = 間違ったコンテキストを見つける = AI が間違った答えを与えることになります。
例: 500 ページの本の中で 1 つの段落を探していると想像してください。本を 章 に分割すると (大きすぎます) → 見つけることはできますが、冗長な情報が多くなります。 個々の文に分割すると (小さすぎる) → 文脈が失われます。適切なチャンク化 = 完全な意味を保つために ちょうど十分な段落に分割します。
1. なぜチャンク化が必要なのでしょうか?
1.1 3 つの主な理由
| 理由 | 説明 |
|---|---|
| コンテキスト ウィンドウ | LLM のトークンは限られています (4K ~ 128K)。 100 ページの文書が入りきらない |
| 検索精度 | 小さなチャンク = より正確な検索 (ノイズが少ない) |
| コスト | 各トークンには費用がかかります。十分な量 = 経済的 |
1.2 チャンクサイズはどのように影響しますか?
Chunk quá NHỎ (50 từ):
  ✅ Tìm kiếm chính xác
  ❌ Mất context xung quanh
  ❌ 1 ý bị tách thành 3 chunks → AI không hiểu

Chunk quá LỚN (2000 từ):
  ✅ Giữ đủ context
  ❌ Chứa nhiều thông tin không liên quan (noise)
  ❌ Embedding quality giảm (quá nhiều ý trong 1 vector)

Chunk VỪA ĐỦ (300-500 từ):
  ✅ Giữ context đủ cho 1 ý chính
  ✅ Embedding chính xác
  ✅ Ít noise
2. チャンク戦略
2.1 固定サイズのチャンク化 — 最も単純な
"""Fixed-size: chia theo số ký tự cố định"""
from langchain.text_splitter import CharacterTextSplitter

text = """Chính sách nghỉ phép năm 2026:

1. Nhân viên full-time được 15 ngày phép/năm.
2. Nhân viên part-time được 8 ngày phép/năm.
3. Nhân viên trên 5 năm được +3 ngày.

Quy trình xin phép:
- Gửi đơn trước 3 ngày làm việc
- Được quản lý phê duyệt
- Nghỉ khẩn cấp: thông báo trong ngày"""

splitter = CharacterTextSplitter(
    separator="\n",       # Cắt theo dòng mới
    chunk_size=200,       # Mỗi chunk tối đa 200 ký tự
    chunk_overlap=30,     # Overlap 30 ký tự
)

chunks = splitter.split_text(text)
for i, chunk in enumerate(chunks):
    print(f"\n--- Chunk {i+1} ({len(chunk)} chars) ---")
    print(chunk)
2.2 再帰的文字分割 — 最も人気のある
"""Recursive: thử chia theo \n\n → \n → ". " → " " → """"""
from langchain.text_splitter import RecursiveCharacterTextSplitter

splitter = RecursiveCharacterTextSplitter(
    chunk_size=500,
    chunk_overlap=50,
    separators=["\n\n", "\n", ". ", " ", ""],  # Thứ tự ưu tiên
)

chunks = splitter.split_text(text)
# Ưu tiên cắt theo paragraph → sentence → word
なぜ「再帰的」なのか?
1. Thử cắt theo "\n\n" (paragraph) → nếu chunk < 500 chars → OK
2. Nếu paragraph > 500 chars → thử cắt theo "\n" (dòng)
3. Nếu dòng > 500 chars → thử cắt theo ". " (câu)
4. Nếu câu > 500 chars → cắt theo " " (từ)
5. Last resort: cắt giữa từ (hiếm khi xảy ra)
2.3 セマンティックチャンキング — 最も賢い方法
"""Semantic: cắt dựa trên ý nghĩa, không phải kích thước"""
from langchain_experimental.text_splitter import SemanticChunker
from langchain_openai import OpenAIEmbeddings

embeddings = OpenAIEmbeddings(model="text-embedding-3-small")

# Semantic chunker: chia khi "ý nghĩa thay đổi"
splitter = SemanticChunker(
    embeddings,
    breakpoint_threshold_type="percentile",  # Cắt khi similarity drop
    breakpoint_threshold_amount=80,          # Percentile 80 → new chunk
)

chunks = splitter.split_text(long_document)

# Chunks sẽ có size KHÁC NHAU — nhưng mỗi chunk chứa
# 1 ý trọn vẹn (tự detect khi nào chuyển chủ đề)
2.4 3 つの戦略を比較する
| 戦略 | 利点 | デメリット | いつ使用するか |
|---|---|---|---|
| 固定サイズ | シンプル、速い | 真ん中をカット | プロトタイプ |
| 再帰的 | バランスをとり、境界を尊重する | チャンクサイズが等しい | ほとんどのプロジェクト |
| セマンティック | チャンクの意味 | 高価な API (埋め込み)、遅い | 高品質ラグ |
推奨事項: RecursiveCharacterTextSplitter から始めます。高品質が必要な場合は、SemanticChunker をお試しください。
3. チャンクのオーバーラップ — なぜ必要なのでしょうか?
3.1 問題: 文の途中でカットする
Chunk 1: "...nhân viên trên 5 năm được"     ← Cắt giữa ý!
Chunk 2: "+3 ngày phép mỗi năm."             ← Mất context!
連続する 2 つのチャンク間のオーバーラップ = 繰り返し部分:
Chunk 1: "...nhân viên trên 5 năm được +3 ngày phép mỗi năm."
Chunk 2: "được +3 ngày phép mỗi năm. Quy trình xin phép:..."
          ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ overlap
3.2 オーバーラップサイズの選択
Chunk size: 500 chars
Overlap recommendations:
- 10% (50 chars): minimal, nhanh, ít trùng
- 20% (100 chars): balanced ← RECOMMENDED
- 30% (150 chars): safe, tốt cho văn bản phức tạp

Overlap > 30%: quá nhiều trùng lặp, lãng phí storage
4. チャンクサイズの最適化
4.1 ベンチマークのチャンク サイズ
"""Benchmark: test nhiều chunk sizes để tìm tối ưu"""
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_openai import OpenAIEmbeddings, ChatOpenAI
from langchain_community.vectorstores import Chroma

# Test data: 20 câu hỏi + đáp án đúng (golden test set)
test_qa = [
    {"question": "Nghỉ phép bao nhiêu ngày?", "expected": "15 ngày"},
    {"question": "Ai phê duyệt nghỉ phép?", "expected": "quản lý"},
    # ... 18 câu nữa
]

chunk_sizes = [200, 300, 500, 800, 1000, 1500]
results = {}

for size in chunk_sizes:
    # Chunk
    splitter = RecursiveCharacterTextSplitter(
        chunk_size=size, chunk_overlap=int(size * 0.2)
    )
    chunks = splitter.split_documents(documents)

    # Index
    vectorstore = Chroma.from_documents(chunks, OpenAIEmbeddings())
    retriever = vectorstore.as_retriever(search_kwargs={"k": 3})

    # Test retrieval accuracy
    correct = 0
    for qa in test_qa:
        results_docs = retriever.invoke(qa["question"])
        # Kiểm tra đáp án có trong retrieved docs không
        context = " ".join([d.page_content for d in results_docs])
        if qa["expected"].lower() in context.lower():
            correct += 1

    accuracy = correct / len(test_qa) * 100
    results[size] = {"accuracy": accuracy, "num_chunks": len(chunks)}
    print(f"Chunk size {size}: {accuracy:.0f}% accuracy, {len(chunks)} chunks")

# Kết quả thường: 300-500 tốt nhất cho hầu hết trường hợp
4.2 文書タイプ別のガイドライン
| ドキュメントの種類 | チャンクサイズ | オーバーラップ | 理由 |
|---|---|---|---|
| よくある質問 / Q&A | 200-300 | 20 | 各 Q&A = 1 チャンク |
| 技術文書 | 500-800 | 100 | 幅広いコンテキストが必要 |
| 法律/契約 | 300-500 | 50 | 各節 = 1 チャンク |
| ブログ/記事 | 500-1000 | 100 | 段落ベース |
| コードドキュメント | 300-500 | 50 | 関数/クラスベース |
| チャットログ | 200-400 | 30 | メッセージベース |
💡 演習 4: 実際のドキュメントで 3 つのチャンク サイズ (200、500、1000) をベンチマークします。 10 個のテスト問題を作成します。どのチャンク サイズが最高の取得精度を実現しますか?
5. 高度な: ドキュメントベースのチャンク化
5.1 マークダウンヘッダーの分割
"""Chia theo markdown headers — giữ nguyên cấu trúc"""
from langchain.text_splitter import MarkdownHeaderTextSplitter

md_text = """
# Chính sách nhân sự

## 1. Nghỉ phép
### 1.1 Nghỉ phép năm
15 ngày cho full-time, 8 ngày cho part-time.

### 1.2 Nghỉ ốm
Tối đa 30 ngày/năm có lương.

## 2. Lương thưởng
### 2.1 Lương cơ bản
Review mỗi 6 tháng.
"""

headers_to_split_on = [
    ("#", "H1"),
    ("##", "H2"),
    ("###", "H3"),
]

splitter = MarkdownHeaderTextSplitter(headers_to_split_on)
chunks = splitter.split_text(md_text)

for chunk in chunks:
    print(f"Headers: {chunk.metadata}")
    print(f"Content: {chunk.page_content[:80]}...")
    print()

# Output: chunk "1.1 Nghỉ phép năm" sẽ có metadata
# {"H1": "Chính sách nhân sự", "H2": "1. Nghỉ phép", "H3": "1.1 Nghỉ phép năm"}
5.2 親ドキュメントの取得者
Ý tưởng: Lưu chunks NHỎ để search chính xác,
         nhưng trả về chunk LỚN (parent) cho LLM.

Chunks nhỏ (search):  "15 ngày phép" (50 từ)
↓ match
Parent chunk (context): "Chính sách nghỉ phép: 15 ngày cho
                         full-time, 8 ngày cho part-time.
                         Nghỉ trên 5 năm được +3 ngày..." (300 từ)

→ Search chính xác + Context đầy đủ = Best of both worlds!
概要
| コンセプト | 覚えておいてください |
|---|---|
| チャンク | RAG |
| 再帰的 | ほとんどの場合に最適な戦略 |
| セマンティック | 最もスマートで、心に刺さる |
| オーバーラップ | chunk_size 10 ~ 20%、コンテキストの損失を回避 |
| チャンク サイズ | ほとんどの使用例では 300 ~ 500 文字 |
| ベンチマーク | 常に実際のデータでチャンク サイズをテストする |
一般的な演習
- ✅ 小さな演習を完了する (4)
- チャンクパイプライン: 書き込み関数
smart_chunk(doc, doc_type)ドキュメントの種類に基づいて戦略とサイズを選択します。 - 視覚化: 長いドキュメントをチャンク化し、視覚化します: チャンクの数を指定し、重複部分を強調表示し、チャンクごとのトークンをカウントします。
- エンドツーエンド: PDF の読み込み → チャンク (3 つの戦略) → ChromaDB へのインデックス作成 → 10 個の質問のクエリ → 精度の比較。
次の記事: メタデータ、フィルタリング、ハイブリッド検索 — チャンクにメタデータを追加し、ベクトル検索とキーワード検索を組み合わせます。