Giới thiệu
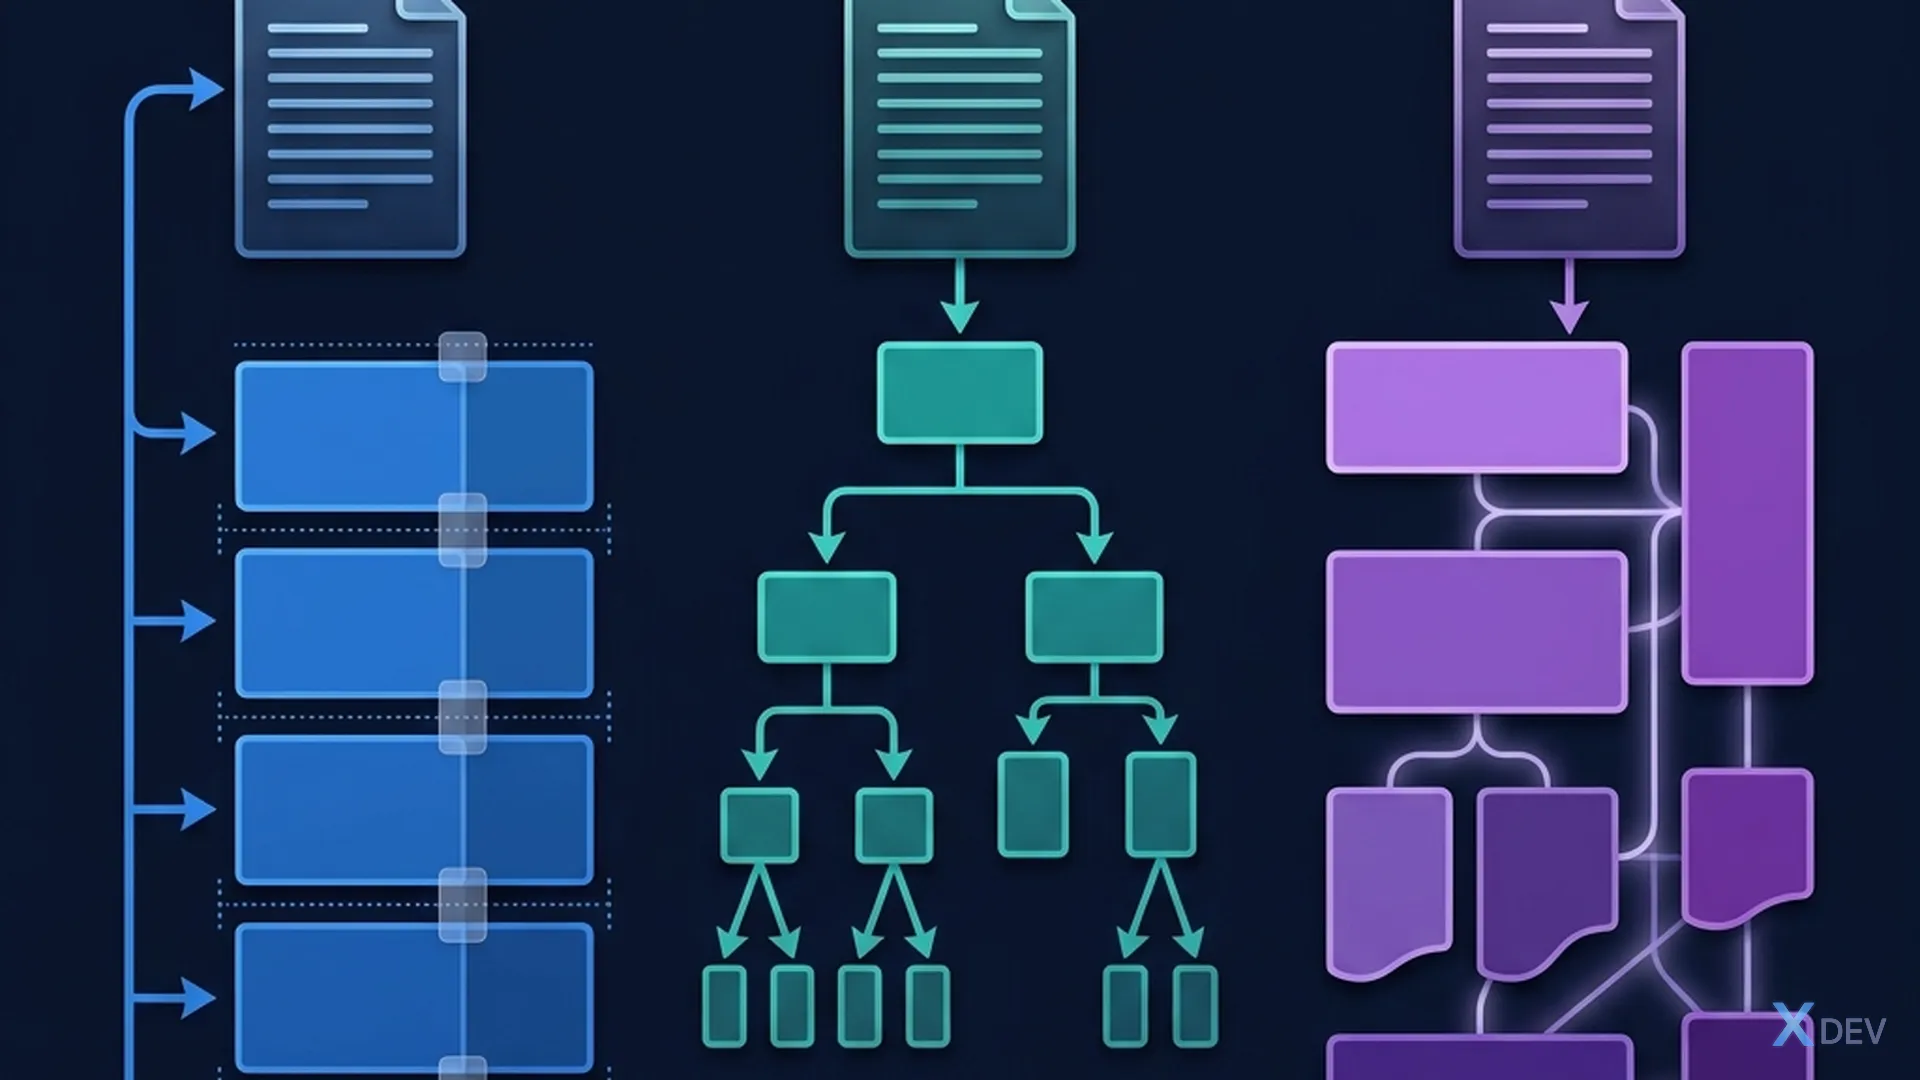
Sau khi load tài liệu (bài 4), bước tiếp theo là chia nhỏ (chunking). Đây là bước quyết định 60% chất lượng retrieval — chọn sai chunk size = tìm sai context = AI trả lời sai.
Ví dụ: Tưởng tượng bạn đang tìm 1 đoạn trong sách 500 trang. Nếu chia sách thành chương (quá lớn) → tìm được nhưng kèm nhiều thông tin thừa. Nếu chia thành từng câu (quá nhỏ) → mất context. Chunking tốt = chia thành đoạn vừa đủ để giữ ý nghĩa trọn vẹn.
1. Tại sao cần Chunking?
1.1 Ba lý do chính
| Lý do | Giải thích |
|---|---|
| Context window | LLM có giới hạn tokens (4K-128K). Không thể nhét cả tài liệu 100 trang |
| Retrieval accuracy | Chunk nhỏ = tìm chính xác hơn (less noise) |
| Cost | Mỗi token tốn tiền. Chunk vừa đủ = tiết kiệm |
1.2 Chunk size ảnh hưởng thế nào?
Chunk quá NHỎ (50 từ):
  ✅ Tìm kiếm chính xác
  ❌ Mất context xung quanh
  ❌ 1 ý bị tách thành 3 chunks → AI không hiểu

Chunk quá LỚN (2000 từ):
  ✅ Giữ đủ context
  ❌ Chứa nhiều thông tin không liên quan (noise)
  ❌ Embedding quality giảm (quá nhiều ý trong 1 vector)

Chunk VỪA ĐỦ (300-500 từ):
  ✅ Giữ context đủ cho 1 ý chính
  ✅ Embedding chính xác
  ✅ Ít noise
2. Các Chunking Strategies
2.1 Fixed-Size Chunking — Đơn giản nhất
"""Fixed-size: chia theo số ký tự cố định"""
from langchain.text_splitter import CharacterTextSplitter

text = """Chính sách nghỉ phép năm 2026:

1. Nhân viên full-time được 15 ngày phép/năm.
2. Nhân viên part-time được 8 ngày phép/năm.
3. Nhân viên trên 5 năm được +3 ngày.

Quy trình xin phép:
- Gửi đơn trước 3 ngày làm việc
- Được quản lý phê duyệt
- Nghỉ khẩn cấp: thông báo trong ngày"""

splitter = CharacterTextSplitter(
    separator="\n",       # Cắt theo dòng mới
    chunk_size=200,       # Mỗi chunk tối đa 200 ký tự
    chunk_overlap=30,     # Overlap 30 ký tự
)

chunks = splitter.split_text(text)
for i, chunk in enumerate(chunks):
    print(f"\n--- Chunk {i+1} ({len(chunk)} chars) ---")
    print(chunk)
2.2 Recursive Character Splitting — Phổ biến nhất
"""Recursive: thử chia theo \n\n → \n → ". " → " " → """"""
from langchain.text_splitter import RecursiveCharacterTextSplitter

splitter = RecursiveCharacterTextSplitter(
    chunk_size=500,
    chunk_overlap=50,
    separators=["\n\n", "\n", ". ", " ", ""],  # Thứ tự ưu tiên
)

chunks = splitter.split_text(text)
# Ưu tiên cắt theo paragraph → sentence → word
Tại sao "recursive"?
1. Thử cắt theo "\n\n" (paragraph) → nếu chunk < 500 chars → OK
2. Nếu paragraph > 500 chars → thử cắt theo "\n" (dòng)
3. Nếu dòng > 500 chars → thử cắt theo ". " (câu)
4. Nếu câu > 500 chars → cắt theo " " (từ)
5. Last resort: cắt giữa từ (hiếm khi xảy ra)
2.3 Semantic Chunking — Thông minh nhất
"""Semantic: cắt dựa trên ý nghĩa, không phải kích thước"""
from langchain_experimental.text_splitter import SemanticChunker
from langchain_openai import OpenAIEmbeddings

embeddings = OpenAIEmbeddings(model="text-embedding-3-small")

# Semantic chunker: chia khi "ý nghĩa thay đổi"
splitter = SemanticChunker(
    embeddings,
    breakpoint_threshold_type="percentile",  # Cắt khi similarity drop
    breakpoint_threshold_amount=80,          # Percentile 80 → new chunk
)

chunks = splitter.split_text(long_document)

# Chunks sẽ có size KHÁC NHAU — nhưng mỗi chunk chứa
# 1 ý trọn vẹn (tự detect khi nào chuyển chủ đề)
2.4 So sánh 3 strategies
| Strategy | Ưu điểm | Nhược điểm | Khi nào dùng |
|---|---|---|---|
| Fixed-size | Đơn giản, nhanh | Cắt giữa ý | Prototype |
| Recursive | Cân bằng, respect boundaries | Chunk size đều nhau | Hầu hết projects |
| Semantic | Chunk theo ý nghĩa | Tốn API (embed), chậm | High-quality RAG |
Recommendation: Bắt đầu bằng RecursiveCharacterTextSplitter. Nếu cần chất lượng cao, thử SemanticChunker.
3. Chunk Overlap — Tại sao cần?
3.1 Vấn đề: Cắt giữa câu
Chunk 1: "...nhân viên trên 5 năm được"     ← Cắt giữa ý!
Chunk 2: "+3 ngày phép mỗi năm."             ← Mất context!
Overlap = lặp lại 1 phần giữa 2 chunks liên tiếp:
Chunk 1: "...nhân viên trên 5 năm được +3 ngày phép mỗi năm."
Chunk 2: "được +3 ngày phép mỗi năm. Quy trình xin phép:..."
          ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ overlap
3.2 Chọn overlap size
Chunk size: 500 chars
Overlap recommendations:
- 10% (50 chars): minimal, nhanh, ít trùng
- 20% (100 chars): balanced ← RECOMMENDED
- 30% (150 chars): safe, tốt cho văn bản phức tạp

Overlap > 30%: quá nhiều trùng lặp, lãng phí storage
4. Tối ưu Chunk Size
4.1 Benchmark chunk size
"""Benchmark: test nhiều chunk sizes để tìm tối ưu"""
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_openai import OpenAIEmbeddings, ChatOpenAI
from langchain_community.vectorstores import Chroma

# Test data: 20 câu hỏi + đáp án đúng (golden test set)
test_qa = [
    {"question": "Nghỉ phép bao nhiêu ngày?", "expected": "15 ngày"},
    {"question": "Ai phê duyệt nghỉ phép?", "expected": "quản lý"},
    # ... 18 câu nữa
]

chunk_sizes = [200, 300, 500, 800, 1000, 1500]
results = {}

for size in chunk_sizes:
    # Chunk
    splitter = RecursiveCharacterTextSplitter(
        chunk_size=size, chunk_overlap=int(size * 0.2)
    )
    chunks = splitter.split_documents(documents)

    # Index
    vectorstore = Chroma.from_documents(chunks, OpenAIEmbeddings())
    retriever = vectorstore.as_retriever(search_kwargs={"k": 3})

    # Test retrieval accuracy
    correct = 0
    for qa in test_qa:
        results_docs = retriever.invoke(qa["question"])
        # Kiểm tra đáp án có trong retrieved docs không
        context = " ".join([d.page_content for d in results_docs])
        if qa["expected"].lower() in context.lower():
            correct += 1

    accuracy = correct / len(test_qa) * 100
    results[size] = {"accuracy": accuracy, "num_chunks": len(chunks)}
    print(f"Chunk size {size}: {accuracy:.0f}% accuracy, {len(chunks)} chunks")

# Kết quả thường: 300-500 tốt nhất cho hầu hết trường hợp
4.2 Guidelines theo loại tài liệu
| Loại tài liệu | Chunk size | Overlap | Lý do |
|---|---|---|---|
| FAQ / Q&A | 200-300 | 20 | Mỗi Q&A = 1 chunk |
| Tài liệu kỹ thuật | 500-800 | 100 | Cần context rộng |
| Luật / Hợp đồng | 300-500 | 50 | Mỗi điều khoản = 1 chunk |
| Blog / Article | 500-1000 | 100 | Paragraph-based |
| Code docs | 300-500 | 50 | Function/class-based |
| Chat logs | 200-400 | 30 | Message-based |
💡 Bài tập 4: Benchmark 3 chunk sizes (200, 500, 1000) trên tài liệu thật. Tạo 10 câu test. Chunk size nào cho retrieval accuracy tốt nhất?
5. Advanced: Document-Based Chunking
5.1 Markdown Header Splitting
"""Chia theo markdown headers — giữ nguyên cấu trúc"""
from langchain.text_splitter import MarkdownHeaderTextSplitter

md_text = """
# Chính sách nhân sự

## 1. Nghỉ phép
### 1.1 Nghỉ phép năm
15 ngày cho full-time, 8 ngày cho part-time.

### 1.2 Nghỉ ốm
Tối đa 30 ngày/năm có lương.

## 2. Lương thưởng
### 2.1 Lương cơ bản
Review mỗi 6 tháng.
"""

headers_to_split_on = [
    ("#", "H1"),
    ("##", "H2"),
    ("###", "H3"),
]

splitter = MarkdownHeaderTextSplitter(headers_to_split_on)
chunks = splitter.split_text(md_text)

for chunk in chunks:
    print(f"Headers: {chunk.metadata}")
    print(f"Content: {chunk.page_content[:80]}...")
    print()

# Output: chunk "1.1 Nghỉ phép năm" sẽ có metadata
# {"H1": "Chính sách nhân sự", "H2": "1. Nghỉ phép", "H3": "1.1 Nghỉ phép năm"}
5.2 Parent Document Retriever
Ý tưởng: Lưu chunks NHỎ để search chính xác,
         nhưng trả về chunk LỚN (parent) cho LLM.

Chunks nhỏ (search):  "15 ngày phép" (50 từ)
↓ match
Parent chunk (context): "Chính sách nghỉ phép: 15 ngày cho
                         full-time, 8 ngày cho part-time.
                         Nghỉ trên 5 năm được +3 ngày..." (300 từ)

→ Search chính xác + Context đầy đủ = Best of both worlds!
Tóm tắt
| Concept | Ghi nhớ |
|---|---|
| Chunking | Chia tài liệu thành đoạn nhỏ cho RAG |
| Recursive | Strategy tốt nhất cho hầu hết cases |
| Semantic | Thông minh nhất, cắt theo ý nghĩa |
| Overlap | 10-20% chunk_size, tránh mất context |
| Chunk size | 300-500 chars cho phần lớn use cases |
| Benchmark | Luôn test chunk size trên data thật |
Bài tập tổng hợp
- ✅ Hoàn thành bài tập nhỏ (4)
- Chunking Pipeline: Viết function
smart_chunk(doc, doc_type)tự chọn strategy + size dựa trên loại tài liệu. - Visualization: Chunk 1 tài liệu dài, visualize: đánh số chunks, highlight overlap, đếm tokens mỗi chunk.
- End-to-End: Load PDF → Chunk (3 strategies) → Index vào ChromaDB → Query 10 câu → So sánh accuracy.
Bài tiếp theo: Metadata, Filtering & Hybrid Search — thêm metadata cho chunks và kết hợp vector + keyword search.