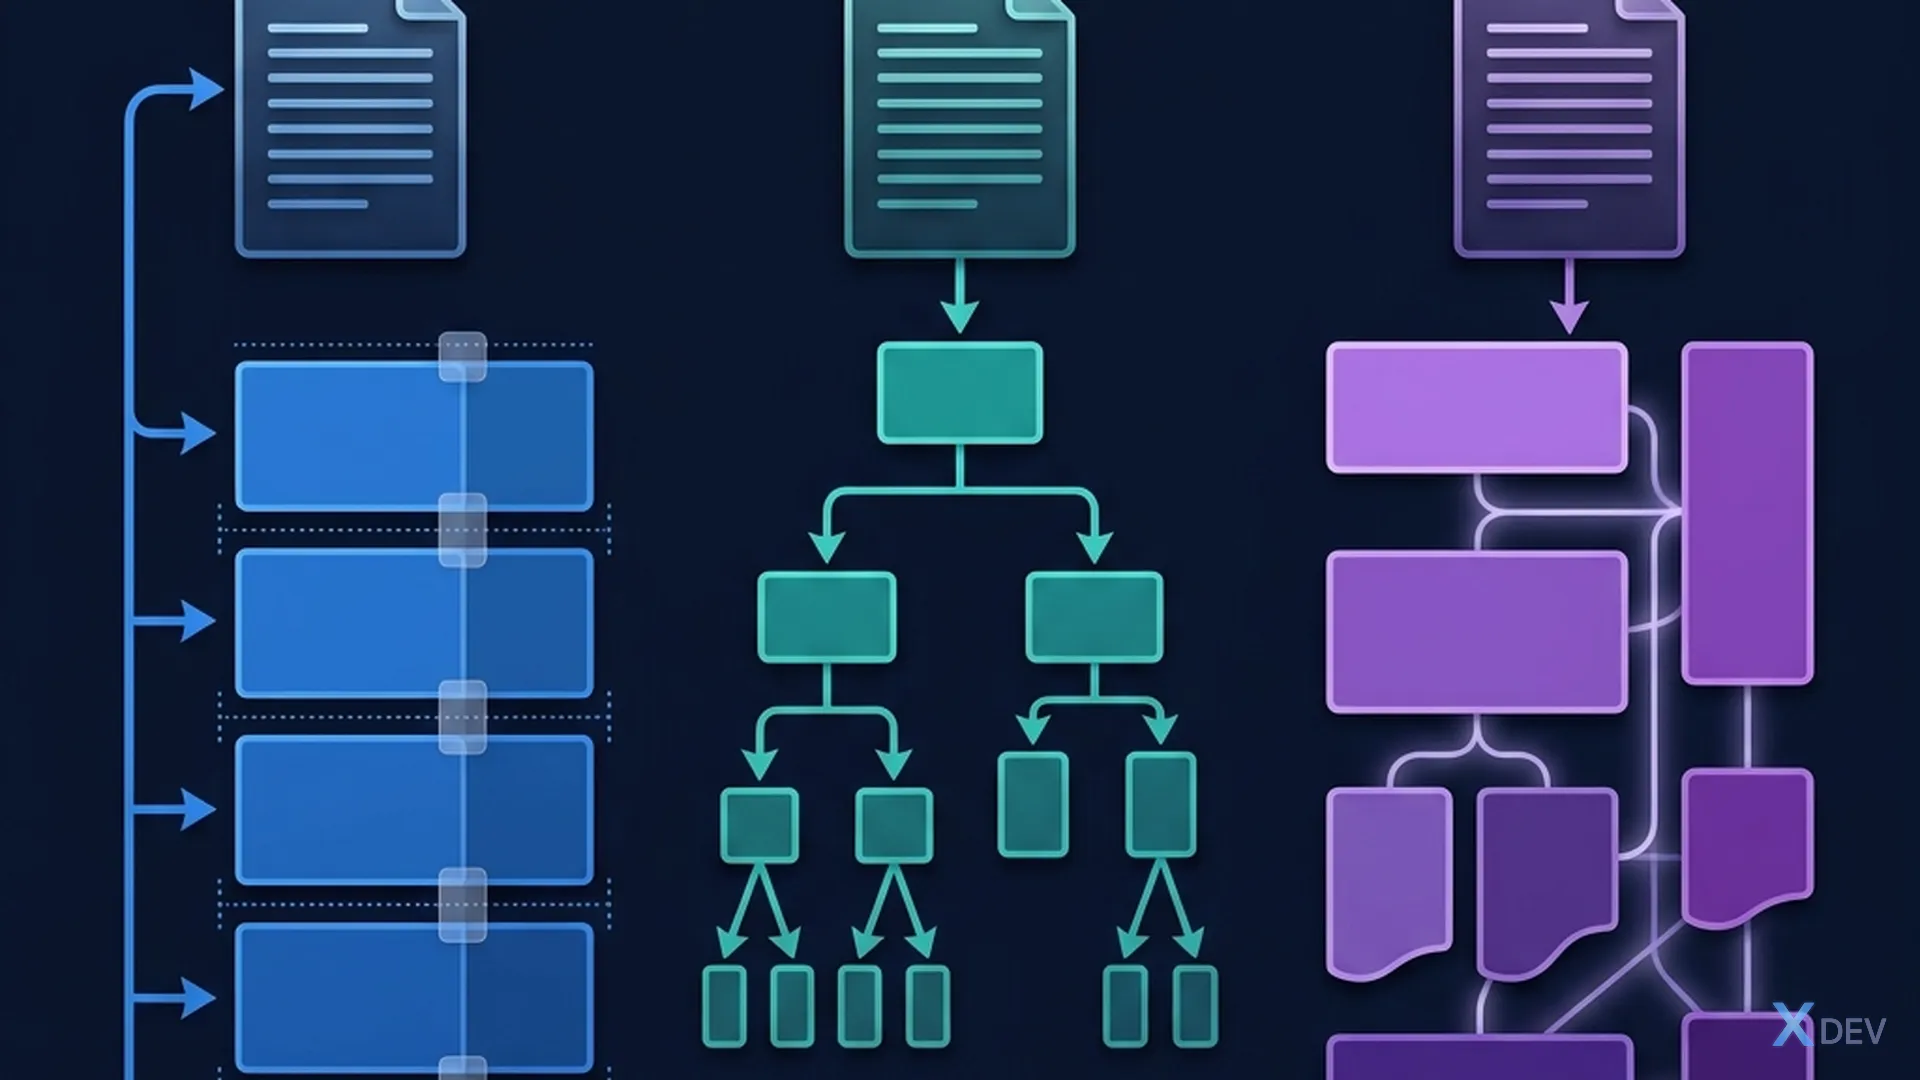
簡介
載入文件(第 4 課)後,下一步是分塊。這是決定 60% 檢索品質的步驟-選擇錯誤的區塊大小 = 找到錯誤的上下文 = AI 給出錯誤的答案。
例如: 假設您正在一本 500 頁的書中尋找一個段落。如果你把書分成章節(太大)→你可以找到它,但有很多冗餘資訊。如果分成單一句子(太小)→上下文就會遺失。好的分塊=分成足夠的段落以保持完整的意義。
1. 為什麼需要分塊?
1.1 三大原因
| 原因 | 說明 |
|---|---|
| 上下文視窗 | LLM 的代幣有限(4K-128K)。無法容納 100 頁的文件 |
| 檢索精確度 | 小塊=更準確的搜尋(更少的雜訊) |
| 成本 | 每個代幣都需要花錢。足夠的塊=經濟 |
1.2 Chunk 大小如何影響它?
Chunk quá NHỎ (50 từ):
  ✅ Tìm kiếm chính xác
  ❌ Mất context xung quanh
  ❌ 1 ý bị tách thành 3 chunks → AI không hiểu

Chunk quá LỚN (2000 từ):
  ✅ Giữ đủ context
  ❌ Chứa nhiều thông tin không liên quan (noise)
  ❌ Embedding quality giảm (quá nhiều ý trong 1 vector)

Chunk VỪA ĐỦ (300-500 từ):
  ✅ Giữ context đủ cho 1 ý chính
  ✅ Embedding chính xác
  ✅ Ít noise
2. 分塊策略
2.1 固定大小分塊-最簡單的
"""Fixed-size: chia theo số ký tự cố định"""
from langchain.text_splitter import CharacterTextSplitter

text = """Chính sách nghỉ phép năm 2026:

1. Nhân viên full-time được 15 ngày phép/năm.
2. Nhân viên part-time được 8 ngày phép/năm.
3. Nhân viên trên 5 năm được +3 ngày.

Quy trình xin phép:
- Gửi đơn trước 3 ngày làm việc
- Được quản lý phê duyệt
- Nghỉ khẩn cấp: thông báo trong ngày"""

splitter = CharacterTextSplitter(
    separator="\n",       # Cắt theo dòng mới
    chunk_size=200,       # Mỗi chunk tối đa 200 ký tự
    chunk_overlap=30,     # Overlap 30 ký tự
)

chunks = splitter.split_text(text)
for i, chunk in enumerate(chunks):
    print(f"\n--- Chunk {i+1} ({len(chunk)} chars) ---")
    print(chunk)
2.2 遞歸字元分割 — 最受歡迎
"""Recursive: thử chia theo \n\n → \n → ". " → " " → """"""
from langchain.text_splitter import RecursiveCharacterTextSplitter

splitter = RecursiveCharacterTextSplitter(
    chunk_size=500,
    chunk_overlap=50,
    separators=["\n\n", "\n", ". ", " ", ""],  # Thứ tự ưu tiên
)

chunks = splitter.split_text(text)
# Ưu tiên cắt theo paragraph → sentence → word
**為什麼「遞迴」? **
1. Thử cắt theo "\n\n" (paragraph) → nếu chunk < 500 chars → OK
2. Nếu paragraph > 500 chars → thử cắt theo "\n" (dòng)
3. Nếu dòng > 500 chars → thử cắt theo ". " (câu)
4. Nếu câu > 500 chars → cắt theo " " (từ)
5. Last resort: cắt giữa từ (hiếm khi xảy ra)
2.3 語意分塊-最聰明的
"""Semantic: cắt dựa trên ý nghĩa, không phải kích thước"""
from langchain_experimental.text_splitter import SemanticChunker
from langchain_openai import OpenAIEmbeddings

embeddings = OpenAIEmbeddings(model="text-embedding-3-small")

# Semantic chunker: chia khi "ý nghĩa thay đổi"
splitter = SemanticChunker(
    embeddings,
    breakpoint_threshold_type="percentile",  # Cắt khi similarity drop
    breakpoint_threshold_amount=80,          # Percentile 80 → new chunk
)

chunks = splitter.split_text(long_document)

# Chunks sẽ có size KHÁC NHAU — nhưng mỗi chunk chứa
# 1 ý trọn vẹn (tự detect khi nào chuyển chủ đề)
2.4 比較 3 種策略
| 戰略 | 優點 | 缺點 | 何時使用 |
|---|---|---|---|
| 固定尺寸 | 簡單、快速 | 從中間切開 | 原型 |
| 遞歸 | 平衡,尊重界限 | 塊大小相等 | 大多數項目 |
| 語意 | 依意義分塊 | API 昂貴(嵌入),速度慢 | 高品質 RAG |
建議: 從 RecursiveCharacterTextSplitter 開始。如果您需要高品質,請嘗試 SemanticChunker。
3. 區塊重疊-為什麼需要它?
3.1 題目:句子中間切掉
Chunk 1: "...nhân viên trên 5 năm được"     ← Cắt giữa ý!
Chunk 2: "+3 ngày phép mỗi năm."             ← Mất context!
重疊=兩個連續區塊之間的重複部分:
Chunk 1: "...nhân viên trên 5 năm được +3 ngày phép mỗi năm."
Chunk 2: "được +3 ngày phép mỗi năm. Quy trình xin phép:..."
          ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ overlap
3.2 選擇重疊大小
Chunk size: 500 chars
Overlap recommendations:
- 10% (50 chars): minimal, nhanh, ít trùng
- 20% (100 chars): balanced ← RECOMMENDED
- 30% (150 chars): safe, tốt cho văn bản phức tạp

Overlap > 30%: quá nhiều trùng lặp, lãng phí storage
4. 最佳化區塊大小
4.1 基準區塊大小
"""Benchmark: test nhiều chunk sizes để tìm tối ưu"""
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_openai import OpenAIEmbeddings, ChatOpenAI
from langchain_community.vectorstores import Chroma

# Test data: 20 câu hỏi + đáp án đúng (golden test set)
test_qa = [
    {"question": "Nghỉ phép bao nhiêu ngày?", "expected": "15 ngày"},
    {"question": "Ai phê duyệt nghỉ phép?", "expected": "quản lý"},
    # ... 18 câu nữa
]

chunk_sizes = [200, 300, 500, 800, 1000, 1500]
results = {}

for size in chunk_sizes:
    # Chunk
    splitter = RecursiveCharacterTextSplitter(
        chunk_size=size, chunk_overlap=int(size * 0.2)
    )
    chunks = splitter.split_documents(documents)

    # Index
    vectorstore = Chroma.from_documents(chunks, OpenAIEmbeddings())
    retriever = vectorstore.as_retriever(search_kwargs={"k": 3})

    # Test retrieval accuracy
    correct = 0
    for qa in test_qa:
        results_docs = retriever.invoke(qa["question"])
        # Kiểm tra đáp án có trong retrieved docs không
        context = " ".join([d.page_content for d in results_docs])
        if qa["expected"].lower() in context.lower():
            correct += 1

    accuracy = correct / len(test_qa) * 100
    results[size] = {"accuracy": accuracy, "num_chunks": len(chunks)}
    print(f"Chunk size {size}: {accuracy:.0f}% accuracy, {len(chunks)} chunks")

# Kết quả thường: 300-500 tốt nhất cho hầu hết trường hợp
4.2 按文件類型劃分的指南
| 檔案類型 | 區塊大小 | 重疊 | 原因 |
|---|---|---|---|
| 常見問題/問答 | 200-300 | 20 | 每個問答 = 1 塊 |
| 技術文件 | 500-800 | 100 | 100需要廣泛的背景 |
| 法律/合約 | 300-500 | 50 | 50每個子句 = 1 個區塊 |
| 部落格/文章 | 500-1000 | 100 | 100基於段落的 |
| 程式碼文檔 | 300-500 | 50 | 50基於函數/類別 |
| 聊天記錄 | 200-400 | 30 | 基於訊息 |
💡練習 4: 在真實文件上對 3 個區塊大小(200、500、1000)進行基準測試。建立 10 個測驗題。哪種區塊大小可以提供最佳的檢索精度?
5. 進階:基於文件的分塊
5.1 Markdown 標頭拆分
"""Chia theo markdown headers — giữ nguyên cấu trúc"""
from langchain.text_splitter import MarkdownHeaderTextSplitter

md_text = """
# Chính sách nhân sự

## 1. Nghỉ phép
### 1.1 Nghỉ phép năm
15 ngày cho full-time, 8 ngày cho part-time.

### 1.2 Nghỉ ốm
Tối đa 30 ngày/năm có lương.

## 2. Lương thưởng
### 2.1 Lương cơ bản
Review mỗi 6 tháng.
"""

headers_to_split_on = [
    ("#", "H1"),
    ("##", "H2"),
    ("###", "H3"),
]

splitter = MarkdownHeaderTextSplitter(headers_to_split_on)
chunks = splitter.split_text(md_text)

for chunk in chunks:
    print(f"Headers: {chunk.metadata}")
    print(f"Content: {chunk.page_content[:80]}...")
    print()

# Output: chunk "1.1 Nghỉ phép năm" sẽ có metadata
# {"H1": "Chính sách nhân sự", "H2": "1. Nghỉ phép", "H3": "1.1 Nghỉ phép năm"}
5.2 父文檔檢索器
Ý tưởng: Lưu chunks NHỎ để search chính xác,
         nhưng trả về chunk LỚN (parent) cho LLM.

Chunks nhỏ (search):  "15 ngày phép" (50 từ)
↓ match
Parent chunk (context): "Chính sách nghỉ phép: 15 ngày cho
                         full-time, 8 ngày cho part-time.
                         Nghỉ trên 5 năm được +3 ngày..." (300 từ)

→ Search chính xác + Context đầy đủ = Best of both worlds!
總結
| 概念 | 記住 |
|---|---|
| 分塊 | 將文件分割為 RAG |
| 遞歸 | 大多數情況下的最佳策略 |
| 語意 | 最聰明,切入人心 |
| 重疊 | 10-20% chunk_size,避免遺失上下文 |
| 區塊大小 | 大多數用例為 300-500 個字元 |
| 基準 | 始終在真實資料上測試區塊大小 |
一般練習
- ✅完成小練習(4)
- Chunking Pipeline: 寫入函數
smart_chunk(doc, doc_type)根據文件類型選擇策略+大小。 - 視覺化: 將長文檔分塊,視覺化:將區塊編號、反白顯示、計算每個區塊的標記數。
- 端對端: 載入 PDF → 分塊(3 種策略)→ 索引到 ChromaDB → 查詢 10 個問題 → 比較準確度。
下一篇文章: 元資料、過濾和混合搜尋 — 新增區塊元資料並結合向量 + 關鍵字搜尋。