Giới thiệu
Trong bài này bạn sẽ dựng một local stack chạy được ngay:
- Ollama làm model runtime
- Gemma 4 làm model chính
- Open WebUI làm giao diện chat cho toàn team
1. Cài Ollama
brew install ollama
brew services start ollama
curl http://127.0.0.1:11434/api/tags
Nếu endpoint trả JSON, runtime đã sẵn sàng.
2. Pull model Gemma 4
ollama pull gemma4
ollama run gemma4
Với máy RAM thấp hơn, ưu tiên biến thể quantized nhẹ để tránh swap.
3. Chạy Open WebUI
docker run -d \
  --name open-webui \
  -p 3000:8080 \
  -e OLLAMA_BASE_URL=http://host.docker.internal:11434 \
  -v open-webui:/app/backend/data \
  --restart unless-stopped \
  ghcr.io/open-webui/open-webui:main
Truy cập http://localhost:3000 và đăng nhập tài khoản admin đầu tiên.
4. Chuẩn hóa model preset
Tạo preset theo use case:
- Coding: temperature thấp, context cao vừa phải
- Summarization: temperature trung bình, format ngắn
- Extraction: temperature thấp, output JSON cố định
Giữ preset ở tài liệu nội bộ để ai mới vào team dùng đúng mặc định.
5. Theo dõi tài nguyên trên Mac
Theo dõi 3 thứ:
- Memory pressure
- Swap usage
- Tokens/second thực tế
Khi swap tăng mạnh, giảm num_ctx hoặc model size trước khi tối ưu sâu.
6. Troubleshooting nhanh
- Docker không gọi được Ollama: dùng
host.docker.internal. - Model chạy chậm dần: kiểm tra swap và app nền.
- UI không thấy model: kiểm tra
ollama listvàOLLAMA_BASE_URL.
Bài tập
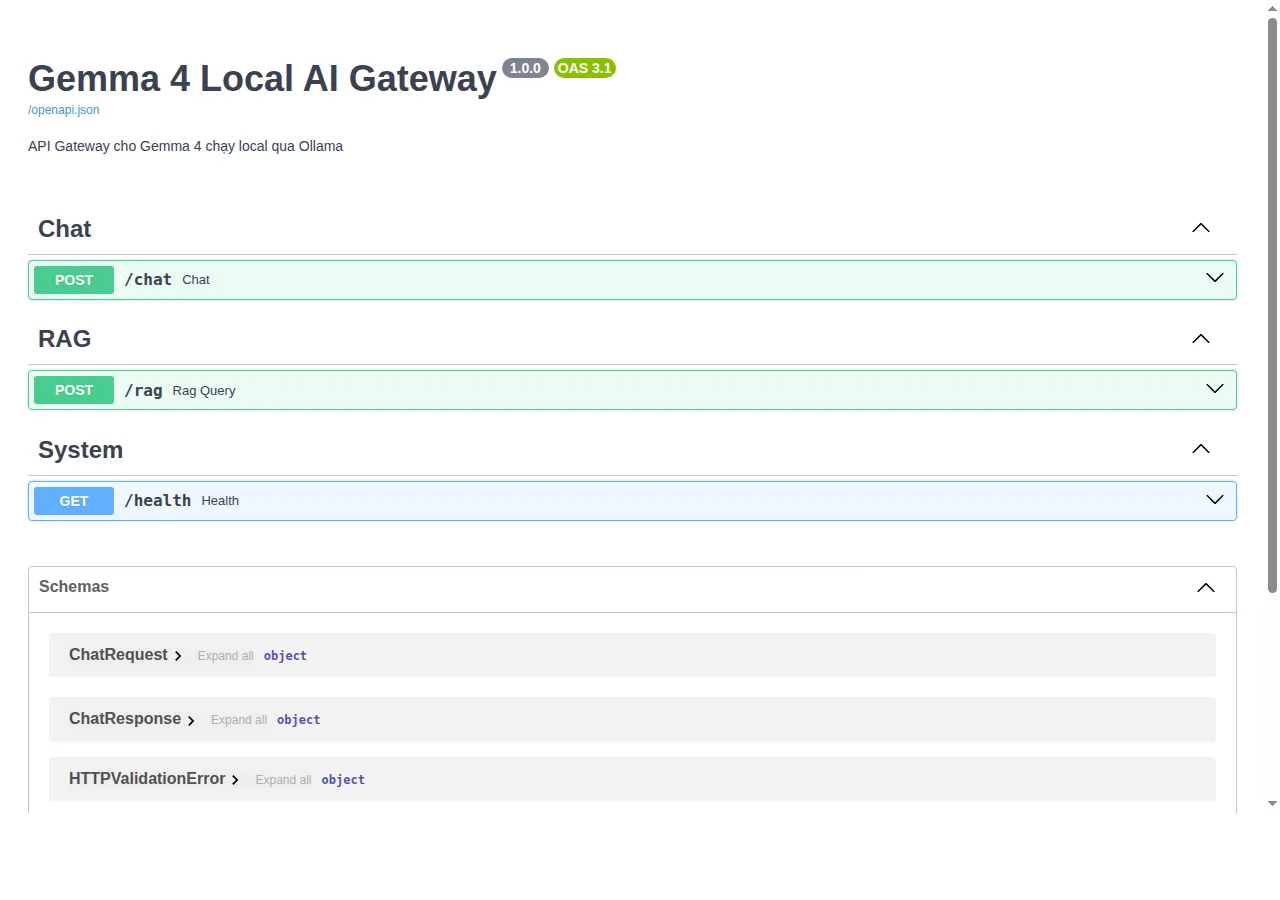
- Cài stack hoàn chỉnh và chụp lại sơ đồ endpoint.
- Tạo 3 preset model theo 3 use case.
- So sánh tốc độ với một prompt dài 2 lần liên tiếp.
Demo code
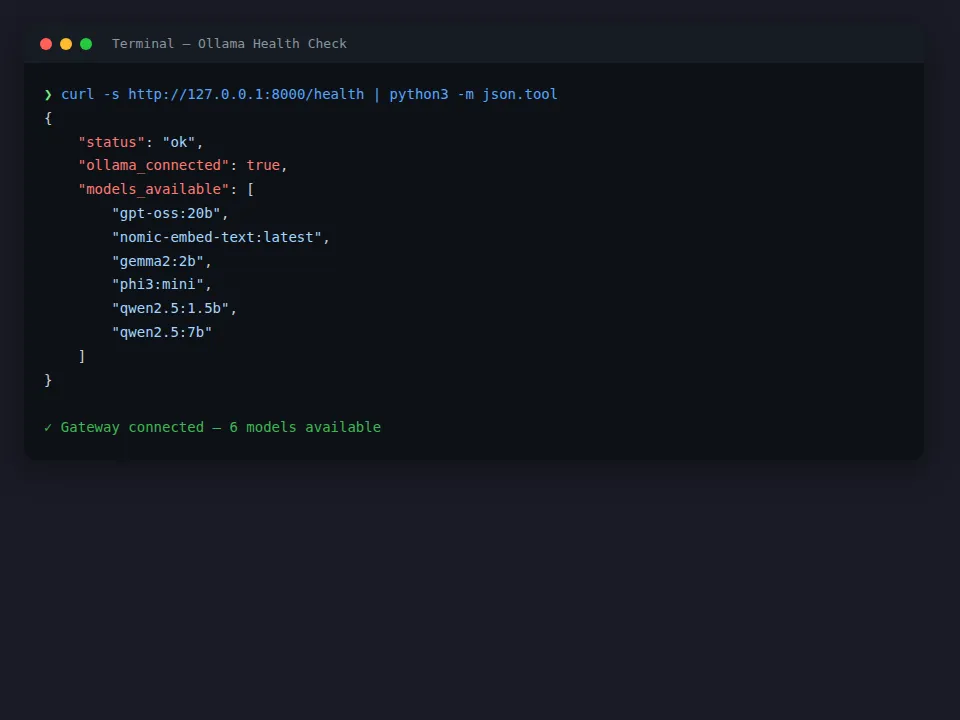
Sau khi cài đặt xong, kiểm tra health check endpoint:
Swagger UI tự động tạo documentation cho API:
Source code: xdev-asia-labs/gemma-4-local-ai-engineering-on-mac
Tóm tắt
Bạn đã có local runtime đầy đủ cho cả kỹ thuật và non-tech. Bài sau sẽ đưa stack này vào chuẩn API gateway để ứng dụng có thể tích hợp ổn định.