Giới thiệu
HADES (Health Analytics Data-to-Evidence Suite) là bộ 20+ R packages mã nguồn mở của OHDSI, cung cấp toàn bộ pipeline phân tích từ tạo cohort đến estimation/prediction. ATLAS là GUI — HADES là engine phía sau.
Quan hệ ATLAS ↔ HADES:

┌──────────────────────────────────┐
│            ATLAS (GUI)           │
│  Design → Generate R Package    │
│              │                   │
│              ▼                   │
│        ┌─────────────┐          │
│        │ HADES (R)   │          │
│        │ Engine      │          │
│        └─────────────┘          │
│              │                   │
│    ┌─────────┴──────────┐       │
│    ▼                    ▼       │
│  CohortMethod    PatientLevel   │
│  (Estimation)    Prediction     │
└──────────────────────────────────┘

→ ATLAS generate study package dùng HADES packages
→ Hoặc dùng HADES trực tiếp từ R (linh hoạt hơn)
1. HADES Ecosystem
1.1 Các packages chính
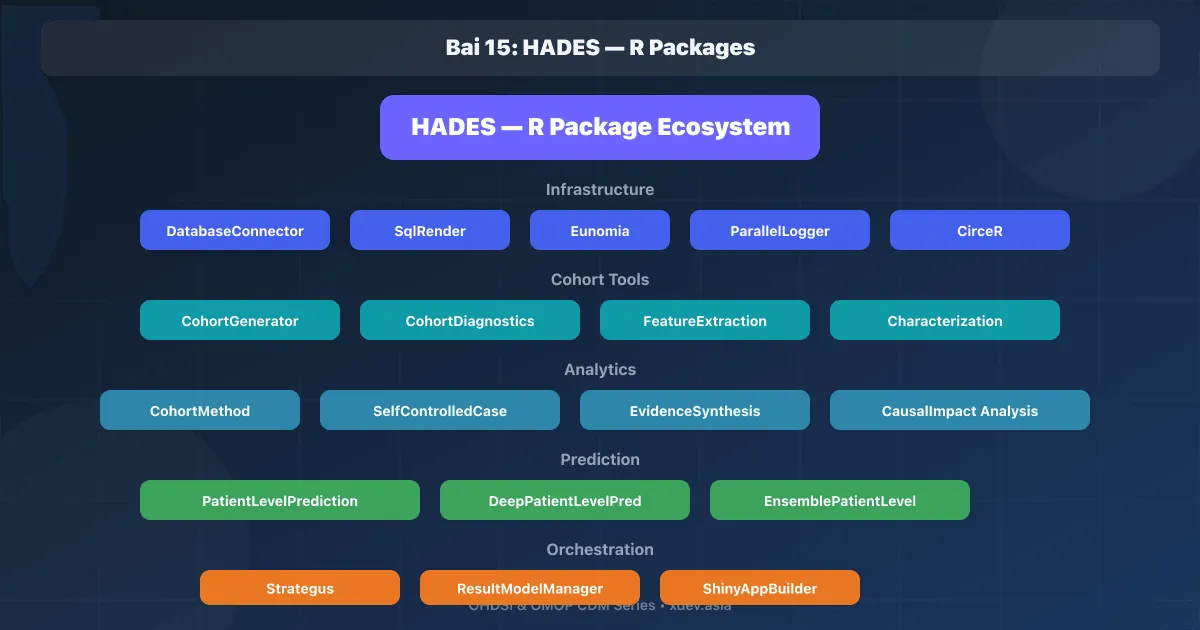
HADES Package Map:

┌─ Data Infrastructure ──────────────────────┐
│  DatabaseConnector    Kết nối DB via JDBC   │
│  SqlRender           SQL cross-platform     │
│  Eunomia            CDM test database       │
└────────────────────────────────────────────┘

┌─ Cohort Generation ───────────────────────┐
│  CohortGenerator     Tạo & execute cohort  │
│  CirceR             Cohort definition → SQL │
│  CohortDiagnostics  Đánh giá chất lượng    │
│                     cohort                  │
└────────────────────────────────────────────┘

┌─ Characterization ────────────────────────┐
│  FeatureExtraction   Trích xuất features   │
│  CohortExplorer     Explore cohort data    │
│  Characterization   Cohort comparison      │
└────────────────────────────────────────────┘

┌─ Population Analytics ────────────────────┐
│  CohortMethod        Causal inference      │
│  SelfControlledCase  SCCS design           │
│  EvidenceSynthesis   Meta-analysis         │
└────────────────────────────────────────────┘

┌─ Prediction ──────────────────────────────┐
│  PatientLevelPrediction  ML prediction     │
│  DeepPatientLevelPred.   Deep learning     │
│  EnsemblePatientLevel.   Ensemble models   │
└────────────────────────────────────────────┘

┌─ Orchestration ───────────────────────────┐
│  Strategus           Pipeline orchestrator  │
│  ResultModelManager  Result management      │
│  ShinyAppBuilder     Interactive dashboards │
└────────────────────────────────────────────┘
1.2 Cài đặt HADES
# Cài toàn bộ HADES
install.packages("remotes")
remotes::install_github("OHDSI/Hades")

# Hoặc cài từng package
remotes::install_github("OHDSI/CohortGenerator")
remotes::install_github("OHDSI/CohortMethod")
remotes::install_github("OHDSI/PatientLevelPrediction")
remotes::install_github("OHDSI/CohortDiagnostics")
remotes::install_github("OHDSI/Strategus")
2. CohortGenerator
2.1 Tạo Cohort từ R
library(CohortGenerator)
library(DatabaseConnector)

connectionDetails <- createConnectionDetails(
  dbms = "postgresql",
  server = "localhost/ohdsi",
  user = "ohdsi_app",
  password = keyring::key_get("ohdsi"),
  port = 5432
)

# Load cohort definition (JSON từ ATLAS export)
cohortDefinitionSet <- getCohortDefinitionSet(
  settingsFileName = "inst/settings/CohortsToCreate.csv",
  jsonFolder = "inst/cohorts",
  sqlFolder = "inst/sql/sql_server"
)

# Create cohort tables
cohortTableNames <- getCohortTableNames(
  cohortTable = "my_study_cohort"
)

createCohortTables(
  connectionDetails = connectionDetails,
  cohortDatabaseSchema = "results",
  cohortTableNames = cohortTableNames
)

# Generate cohorts
cohortsGenerated <- generateCohortSet(
  connectionDetails = connectionDetails,
  cdmDatabaseSchema = "cdm",
  cohortDatabaseSchema = "results",
  cohortTableNames = cohortTableNames,
  cohortDefinitionSet = cohortDefinitionSet
)

print(cohortsGenerated)
# cohortId | cohortName              | status   | count
# 1        | New-Onset Type 2 DM     | COMPLETE | 4,200
# 2        | Acute MI                | COMPLETE |   890
# 3        | Metformin New Users     | COMPLETE | 3,100
3. CohortMethod (Estimation)
3.1 Study Design
library(CohortMethod)

# Target-Comparator-Outcome
tcos <- createTargetComparatorOutcomes(
  targetId = 1,         # Metformin
  comparatorId = 2,     # Sulfonylurea
  outcomeIds = c(3, 4), # MI, Stroke
  excludedCovariateConceptIds = c()
)

targetComparatorOutcomesList <- list(tcos)

# Covariate settings
covSettings <- createDefaultCovariateSettings(
  excludedCovariateConceptIds = c(),
  addDescendantsToExclude = TRUE
)

# Study parameters
getDbCmDataArgs <- createGetDbCohortMethodDataArgs(
  washoutPeriod = 365,
  maxCohortSize = 0,    # no limit
  covariateSettings = covSettings
)

# Propensity Score
createPsArgs <- createCreatePsArgs(
  maxCohortSizeForFitting = 150000,
  control = createControl(
    cvType = "auto",
    startingVariance = 0.01,
    tolerance = 2e-07,
    noiseLevel = "quiet"
  )
)

# Matching
matchOnPsArgs <- createMatchOnPsArgs(
  maxRatio = 1,         # 1:1 matching
  caliper = 0.2,
  caliperScale = "standardized logit"
)

# Outcome model
fitOutcomeModelArgs <- createFitOutcomeModelArgs(
  modelType = "cox",
  stratified = FALSE
)
3.2 Execute & Results
# Execute analysis
result <- runCmAnalyses(
  connectionDetails = connectionDetails,
  cdmDatabaseSchema = "cdm",
  exposureDatabaseSchema = "results",
  exposureTable = "my_study_cohort",
  outcomeDatabaseSchema = "results",
  outcomeTable = "my_study_cohort",
  outputFolder = "output/cm_results",
  cmAnalysisList = list(cmAnalysis),
  targetComparatorOutcomesList = targetComparatorOutcomesList
)

# Get results
analysisSummary <- summarizeAnalyses(result)
print(analysisSummary)

# target | comparator | outcome | rr   | ci95lb | ci95ub | p
# Met    | SU         | MI      | 0.62 | 0.39   | 0.98   | 0.041
# Met    | SU         | Stroke  | 0.78 | 0.55   | 1.12   | 0.18
4. PatientLevelPrediction
4.1 Model Design
library(PatientLevelPrediction)

# Covariates
covSettings <- createCovariateSettings(
  useDemographicsGender = TRUE,
  useDemographicsAge = TRUE,
  useConditionOccurrenceLongTerm = TRUE,
  useDrugExposureLongTerm = TRUE,
  useMeasurementValueLongTerm = TRUE,
  useProcedureOccurrenceLongTerm = TRUE,
  longTermStartDays = -365,
  endDays = 0
)

# Population settings
populationSettings <- createStudyPopulationSettings(
  washoutPeriod = 365,
  firstExposureOnly = TRUE,
  removeSubjectsWithPriorOutcome = TRUE,
  riskWindowStart = 1,
  riskWindowEnd = 1825,  # 5 years
  minTimeAtRisk = 365
)

# Model settings
lasso <- setLassoLogisticRegression()
gbm <- setGradientBoostingMachine(
  ntrees = c(100, 300),
  maxDepth = c(4, 6),
  learnRate = c(0.01, 0.1)
)
4.2 Execute & Evaluate
# Run prediction
plpResults <- runPlp(
  plpData = plpData,
  outcomeId = 3,                # CKD
  analysisId = "ckd_prediction",
  analysisName = "CKD Risk in DM",
  populationSettings = populationSettings,
  splitSettings = createDefaultSplitSetting(
    trainFraction = 0.75,
    testFraction = 0.25,
    nfold = 3
  ),
  modelSettings = lasso,
  executeSettings = createExecuteSettings(
    runSplitData = TRUE,
    runSampleData = FALSE,
    runfeatureEngineering = FALSE,
    runPreprocessData = TRUE,
    runModelDevelopment = TRUE,
    runCovariateSummary = TRUE
  )
)

# Performance
performance <- plpResults$performanceEvaluation
cat("AUC:", performance$evaluationStatistics$AUC, "\n")
cat("AUPRC:", performance$evaluationStatistics$AUPRC, "\n")
cat("Brier:", performance$evaluationStatistics$BrierScore, "\n")

# Kết quả:
# AUC:   0.82
# AUPRC: 0.35
# Brier: 0.08
4.3 Xem kết quả Shiny
# Launch interactive viewer
viewPlp(plpResults, outputFolder = "output/plp_results")

# → Mở browser:
#   - ROC curve
#   - Calibration plot
#   - Feature importance
#   - Decision curve analysis
#   - Demographic parity
5. CohortDiagnostics
5.1 Đánh giá Cohort Quality
library(CohortDiagnostics)

# Chạy diagnostics
executeDiagnostics(
  cohortDefinitionSet = cohortDefinitionSet,
  connectionDetails = connectionDetails,
  cohortTable = "my_study_cohort",
  cohortDatabaseSchema = "results",
  cdmDatabaseSchema = "cdm",
  exportFolder = "output/diagnostics",
  databaseId = "Hospital_VN",
  minCellCount = 5
)

# Xem kết quả
createMergedResultsFile(
  dataFolder = "output/diagnostics",
  sqliteDbPath = "output/MergedCohortDiagnosticsData.sqlite"
)

launchDiagnosticsExplorer(
  sqliteDbPath = "output/MergedCohortDiagnosticsData.sqlite"
)
5.2 Diagnostics Reports
CohortDiagnostics cung cấp:

1. Cohort Count & Attrition
   → Bao nhiêu BN pass mỗi inclusion criteria?

2. Incidence Rate (over time)
   → Trend: tăng/giảm/ổn định?

3. Time Distribution
   → Observation time trước/sau index date

4. Concept Set Diagnostics
   → Orphan concepts (concepts bị miss)
   → Included source codes
   → Resolved concept set details

5. Index Event Breakdown
   → Source codes nào trigger cohort entry?

6. Visit Context
   → Inpatient, outpatient, ER?

7. Overlap
   → Bao nhiêu BN thuộc nhiều cohorts?
6. Strategus — Pipeline Orchestrator
6.1 Khái niệm
Strategus = orchestrate toàn bộ analysis pipeline

Thay vì viết code riêng cho từng bước:
  1. CohortGenerator → tạo cohort
  2. CohortDiagnostics → kiểm tra
  3. Characterization → mô tả
  4. CohortMethod → estimation
  5. PatientLevelPrediction → prediction

Strategus ghép tất cả thành 1 pipeline JSON:
  analysisSpecifications.json → Execute once → All results
6.2 Tạo Analysis Specifications
library(Strategus)

# Cohort generation module
cohortGenModule <- CohortGeneratorModule$new()
cohortGenModuleSpecs <- cohortGenModule$createModuleSpecifications(
  cohortDefinitionSet = cohortDefinitionSet
)

# Characterization module
characterizationModule <- CharacterizationModule$new()
charModuleSpecs <- characterizationModule$createModuleSpecifications(
  targetIds = c(1, 2),
  outcomeIds = c(3),
  minPriorObservation = 365
)

# Estimation module
estimationModule <- CohortMethodModule$new()
estModuleSpecs <- estimationModule$createModuleSpecifications(
  cmAnalysisList = list(cmAnalysis),
  targetComparatorOutcomesList = targetComparatorOutcomesList
)

# Combine all modules
analysisSpecifications <- createEmptyAnalysisSpecificiations() |>
  addModuleSpecifications(cohortGenModuleSpecs) |>
  addModuleSpecifications(charModuleSpecs) |>
  addModuleSpecifications(estModuleSpecs)

# Save
ParallelLogger::saveSettingsToJson(
  analysisSpecifications,
  "inst/analysisSpecifications.json"
)
6.3 Execute Strategus
# Execution settings
executionSettings <- createCdmExecutionSettings(
  connectionDetailsReference = "Hospital_VN",
  workDatabaseSchema = "results",
  cdmDatabaseSchema = "cdm",
  cohortTableNames = getCohortTableNames("strategus_cohort"),
  workFolder = "output/strategus_work",
  resultsFolder = "output/strategus_results",
  minCellCount = 5
)

# Store connection details (secure)
storeConnectionDetails(
  connectionDetails = connectionDetails,
  connectionDetailsReference = "Hospital_VN"
)

# Execute entire pipeline
execute(
  analysisSpecifications = analysisSpecifications,
  executionSettings = executionSettings,
  executionScriptFolder = "output/execution_scripts"
)

# → Tự động chạy: CohortGen → Diagnostics → Char → Estimation
# → Kết quả lưu trong resultsFolder
7. Eunomia — CDM Test Database
# Eunomia: synthetic CDM database cho testing
library(Eunomia)

connectionDetails <- getEunomiaConnectionDetails()
# → Tự tạo SQLite CDM database với synthetic data

# Dùng để:
# - Test code trước khi chạy production
# - Unit testing cho R study packages
# - Training & workshops

# Ví dụ: test CohortMethod
library(CohortMethod)

cmData <- getDbCohortMethodData(
  connectionDetails = connectionDetails,
  cdmDatabaseSchema = "main",
  targetId = 1,
  comparatorId = 2,
  outcomeIds = 3,
  covariateSettings = createDefaultCovariateSettings()
)

summary(cmData)
# → CohortMethodData object
# → Target: 500 persons
# → Comparator: 480 persons
Tóm tắt
| Package | Chức năng | Tương đương ATLAS |
|---|---|---|
| CohortGenerator | Tạo & quản lý cohorts | Cohort Definitions |
| CohortDiagnostics | Đánh giá chất lượng cohort | — |
| FeatureExtraction | Trích xuất covariates | Characterization |
| CohortMethod | Causal inference (estimation) | Estimation |
| PatientLevelPrediction | ML prediction models | Prediction |
| Strategus | Pipeline orchestrator | — |
| Eunomia | Synthetic test CDM | — |
Bài tiếp theo: Triển khai OHDSI Stack trên Docker & Kubernetes