Giới thiệu
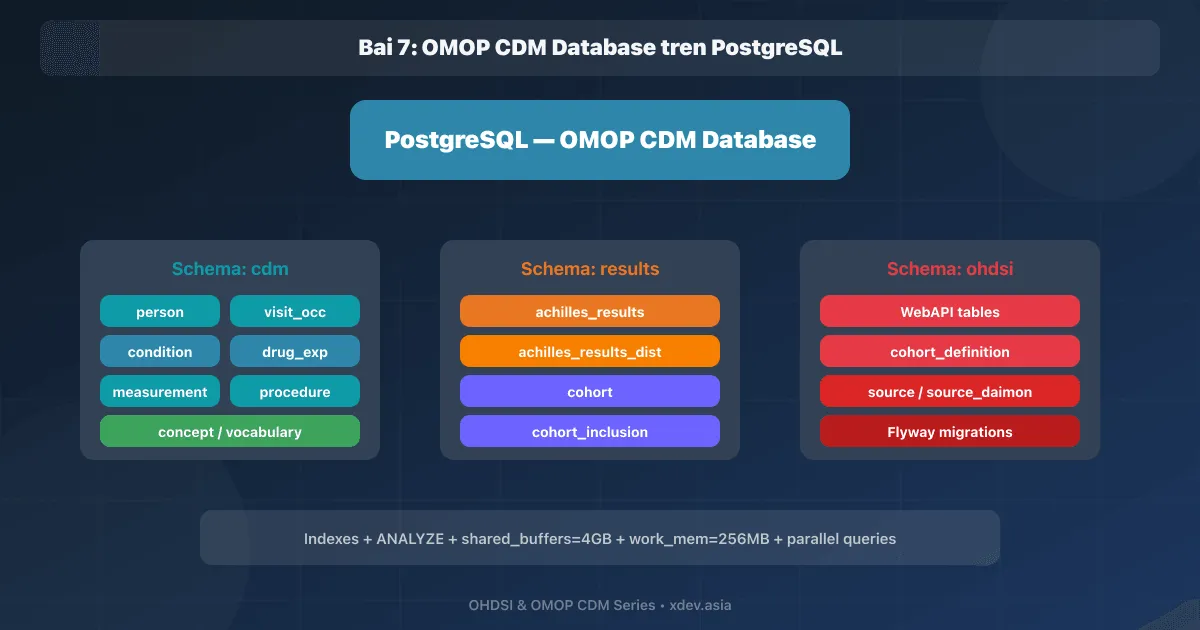
OMOP CDM database là nền tảng lưu trữ toàn bộ dữ liệu y tế đã chuẩn hóa. PostgreSQL là lựa chọn phổ biến nhất trong cộng đồng OHDSI nhờ miễn phí, hiệu năng cao, và hỗ trợ tốt từ các công cụ OHDSI.
1. Chuẩn bị PostgreSQL
1.1 Cài đặt PostgreSQL
# Ubuntu 24.04
sudo apt update
sudo apt install -y postgresql-16 postgresql-contrib-16

# Verify
psql --version
# psql (PostgreSQL) 16.x

# Start service
sudo systemctl start postgresql
sudo systemctl enable postgresql
1.2 Tạo Database và User
# Switch sang user postgres
sudo -u postgres psql

# Tạo user cho OHDSI
CREATE USER ohdsi_admin WITH PASSWORD 'secure_password_here';
CREATE USER ohdsi_app WITH PASSWORD 'app_password_here';

# Tạo database
CREATE DATABASE ohdsi OWNER ohdsi_admin;

# Tạo schemas
\c ohdsi
CREATE SCHEMA cdm AUTHORIZATION ohdsi_admin;
CREATE SCHEMA results AUTHORIZATION ohdsi_admin;
CREATE SCHEMA temp AUTHORIZATION ohdsi_admin;

-- Grant permissions
GRANT USAGE ON SCHEMA cdm TO ohdsi_app;
GRANT SELECT ON ALL TABLES IN SCHEMA cdm TO ohdsi_app;
GRANT USAGE ON SCHEMA results TO ohdsi_app;
GRANT ALL ON ALL TABLES IN SCHEMA results TO ohdsi_app;

\q
2. Tạo OMOP CDM Schema
2.1 Download DDL Scripts
# Clone OMOP CDM repository
git clone https://github.com/OHDSI/CommonDataModel.git
cd CommonDataModel

# Structure
ls inst/ddl/5.4/postgresql/
# OMOPCDM_postgresql_5.4_ddl.sql          ← Tạo tables
# OMOPCDM_postgresql_5.4_primary_keys.sql ← Primary keys
# OMOPCDM_postgresql_5.4_constraints.sql  ← Foreign keys
# OMOPCDM_postgresql_5.4_indices.sql      ← Indexes
2.2 Chạy DDL Scripts
# Tạo tables
psql -h localhost -U ohdsi_admin -d ohdsi \
  -f inst/ddl/5.4/postgresql/OMOPCDM_postgresql_5.4_ddl.sql \
  -v cdmDatabaseSchema=cdm

# Verify tables created
psql -h localhost -U ohdsi_admin -d ohdsi -c "
  SELECT table_name
  FROM information_schema.tables
  WHERE table_schema = 'cdm'
  ORDER BY table_name;
"
2.3 Danh sách tables sau khi tạo
cdm schema:
├── care_site
├── cdm_source
├── cohort
├── cohort_definition
├── concept
├── concept_ancestor
├── concept_class
├── concept_relationship
├── concept_synonym
├── condition_era
├── condition_occurrence
├── cost
├── death
├── device_exposure
├── domain
├── dose_era
├── drug_era
├── drug_exposure
├── drug_strength
├── episode
├── episode_event
├── fact_relationship
├── location
├── measurement
├── metadata
├── note
├── note_nlp
├── observation
├── observation_period
├── payer_plan_period
├── person
├── procedure_occurrence
├── relationship
├── source_to_concept_map
├── specimen
├── visit_detail
├── visit_occurrence
└── vocabulary
3. Load Standardized Vocabularies
3.1 Chuẩn bị Vocabulary Files
# Download từ Athena (xem Bài 3)
# Unzip vocabulary_download_xxxxx.zip
unzip vocabulary_download_xxxxx.zip -d /data/vocabularies/

ls /data/vocabularies/
# CONCEPT.csv
# CONCEPT_ANCESTOR.csv
# CONCEPT_CLASS.csv
# CONCEPT_RELATIONSHIP.csv
# CONCEPT_SYNONYM.csv
# DOMAIN.csv
# DRUG_STRENGTH.csv
# RELATIONSHIP.csv
# SOURCE_TO_CONCEPT_MAP.csv
# VOCABULARY.csv
3.2 Script Load Vocabularies
#!/bin/bash
# load_vocabularies.sh

PGHOST=localhost
PGPORT=5432
PGDATABASE=ohdsi
PGUSER=ohdsi_admin
SCHEMA=cdm
VOCAB_DIR=/data/vocabularies

export PGPASSWORD='secure_password_here'

echo "Loading Vocabularies into ${SCHEMA} schema..."

# Thứ tự load (respect FK dependencies)
TABLES=(
  "DOMAIN"
  "VOCABULARY"
  "CONCEPT_CLASS"
  "RELATIONSHIP"
  "CONCEPT"
  "CONCEPT_SYNONYM"
  "CONCEPT_RELATIONSHIP"
  "CONCEPT_ANCESTOR"
  "DRUG_STRENGTH"
  "SOURCE_TO_CONCEPT_MAP"
)

for TABLE in "${TABLES[@]}"; do
  FILE="${VOCAB_DIR}/${TABLE}.csv"
  if [ -f "$FILE" ]; then
    echo "  Loading ${TABLE}..."
    # OMOP CSV dùng TAB separator, no quote character
    psql -h $PGHOST -p $PGPORT -d $PGDATABASE -U $PGUSER -c "
      \\COPY ${SCHEMA}.${TABLE}
      FROM '${FILE}'
      WITH (FORMAT csv, HEADER true, DELIMITER E'\\t', QUOTE E'\\b')
    "
    ROW_COUNT=$(psql -h $PGHOST -p $PGPORT -d $PGDATABASE -U $PGUSER -t -c "
      SELECT COUNT(*) FROM ${SCHEMA}.${TABLE};
    ")
    echo "    → ${ROW_COUNT} rows loaded"
  else
    echo "  SKIP ${TABLE} (file not found)"
  fi
done

echo "Vocabulary loading complete!"
3.3 Thời gian load ước tính
Table                   Rows (approx)    Time (SSD)
──────────────────────────────────────────────────
CONCEPT                 ~7,000,000       2-5 min
CONCEPT_RELATIONSHIP    ~50,000,000      15-30 min
CONCEPT_ANCESTOR        ~80,000,000      20-40 min
CONCEPT_SYNONYM         ~5,000,000       1-3 min
DRUG_STRENGTH           ~300,000         < 1 min
Others                  < 100,000 each   < 1 min
──────────────────────────────────────────────────
Total                                    ~45-90 min
4. Tạo Indexes và Constraints
4.1 Primary Keys
psql -h localhost -U ohdsi_admin -d ohdsi \
  -f inst/ddl/5.4/postgresql/OMOPCDM_postgresql_5.4_primary_keys.sql \
  -v cdmDatabaseSchema=cdm
4.2 Indexes (quan trọng cho performance)
-- Vocabulary indexes (thiết yếu cho mọi query)
CREATE INDEX idx_concept_concept_id ON cdm.concept (concept_id);
CREATE INDEX idx_concept_vocabulary ON cdm.concept (vocabulary_id, concept_code);
CREATE INDEX idx_concept_domain ON cdm.concept (domain_id);
CREATE INDEX idx_concept_standard ON cdm.concept (standard_concept);

CREATE INDEX idx_cr_c1 ON cdm.concept_relationship (concept_id_1);
CREATE INDEX idx_cr_c2 ON cdm.concept_relationship (concept_id_2);
CREATE INDEX idx_cr_rel ON cdm.concept_relationship (relationship_id);

CREATE INDEX idx_ca_ancestor ON cdm.concept_ancestor (ancestor_concept_id);
CREATE INDEX idx_ca_descendant ON cdm.concept_ancestor (descendant_concept_id);

-- Clinical data indexes
CREATE INDEX idx_person_id ON cdm.person (person_id);
CREATE INDEX idx_visit_person ON cdm.visit_occurrence (person_id);
CREATE INDEX idx_visit_date ON cdm.visit_occurrence (visit_start_date);
CREATE INDEX idx_co_person ON cdm.condition_occurrence (person_id);
CREATE INDEX idx_co_concept ON cdm.condition_occurrence (condition_concept_id);
CREATE INDEX idx_de_person ON cdm.drug_exposure (person_id);
CREATE INDEX idx_de_concept ON cdm.drug_exposure (drug_concept_id);
CREATE INDEX idx_m_person ON cdm.measurement (person_id);
CREATE INDEX idx_m_concept ON cdm.measurement (measurement_concept_id);
4.3 Foreign Keys (tùy chọn)
# FK constraints giúp data integrity nhưng chậm ETL load
# Recommendation: Tạo FK sau khi ETL hoàn thành

psql -h localhost -U ohdsi_admin -d ohdsi \
  -f inst/ddl/5.4/postgresql/OMOPCDM_postgresql_5.4_constraints.sql \
  -v cdmDatabaseSchema=cdm
5. PostgreSQL Performance Tuning
5.1 Cấu hình cho OHDSI workload
# postgresql.conf — tối ưu cho OMOP CDM queries

# Memory (giả sử server 64GB RAM)
shared_buffers = 16GB              # 25% of RAM
effective_cache_size = 48GB        # 75% of RAM
work_mem = 256MB                   # Cho complex joins
maintenance_work_mem = 2GB         # Cho VACUUM, CREATE INDEX

# Parallel queries (OMOP queries benefit from parallelism)
max_parallel_workers_per_gather = 4
max_parallel_workers = 8
max_worker_processes = 8
parallel_tuple_cost = 0.01
parallel_setup_cost = 100

# Planner
random_page_cost = 1.1             # SSD storage
effective_io_concurrency = 200     # SSD
default_statistics_target = 500    # Better query plans

# WAL (nếu dùng cho analytics, không phải OLTP)
wal_buffers = 64MB
checkpoint_completion_target = 0.9

# Autovacuum
autovacuum_max_workers = 3
autovacuum_vacuum_cost_limit = 400
5.2 CDM Source Metadata
-- Populate CDM_SOURCE table
INSERT INTO cdm.cdm_source (
  cdm_source_name,
  cdm_source_abbreviation,
  cdm_holder,
  source_description,
  cdm_etl_reference,
  source_release_date,
  cdm_release_date,
  cdm_version,
  vocabulary_version
) VALUES (
  'Hospital XYZ Vietnam',
  'HXYZ',
  'XDev Healthcare',
  'Dữ liệu HIS bệnh viện XYZ, giai đoạn 2018-2024',
  'https://github.com/xdev/ohdsi-etl',
  '2024-12-01',
  '2025-01-15',
  'v5.4',
  'v5.0 30-AUG-2024'  -- Vocabulary version từ Athena
);
6. Verify Installation
-- Kiểm tra vocabulary loaded
SELECT vocabulary_id, vocabulary_name, vocabulary_version
FROM cdm.vocabulary
ORDER BY vocabulary_id;

-- Đếm concepts per vocabulary
SELECT vocabulary_id, COUNT(*) AS concept_count
FROM cdm.concept
GROUP BY vocabulary_id
ORDER BY concept_count DESC
LIMIT 15;

-- Test query: tìm concept
SELECT concept_id, concept_name, vocabulary_id, domain_id
FROM cdm.concept
WHERE concept_name ILIKE '%hypertension%'
  AND standard_concept = 'S'
  AND invalid_reason IS NULL
LIMIT 10;
Tóm tắt
| Bước | Mô tả |
|---|---|
| 1 | Cài PostgreSQL, tạo database + schemas (cdm, results, temp) |
| 2 | Chạy OMOP CDM DDL scripts → tạo ~37 tables |
| 3 | Download vocabularies từ Athena → load vào vocabulary tables |
| 4 | Tạo indexes (vocabulary + clinical data) |
| 5 | Tuning PostgreSQL cho OHDSI workload |
| 6 | Verify: query thử concepts |
Bài tiếp theo: WebAPI — Cài đặt, Cấu hình & REST API