1. 從Diffusion Models到LLM應用
在第2部分中,我們掌握了Diffusion Models——從前向/反向過程到CLIP引導生成。現在在第3部分,重點轉向大型語言模型(LLMs)以及如何建構實際應用:推論管線、RAG和聊天機器人。
本課聚焦於LLM推論管線設計——如何透過取樣參數控制LLM輸出、使用NVIDIA NIM部署模型、使用LangChain LCEL建構管線,以及使用Gradio + LangServe建立UI/API。
考試提示: NVIDIA DLI考試經常考推論參數(temperature、top-k、top-p)以及何時使用NIM而非其他框架。請務必熟記本課末尾的比較表。
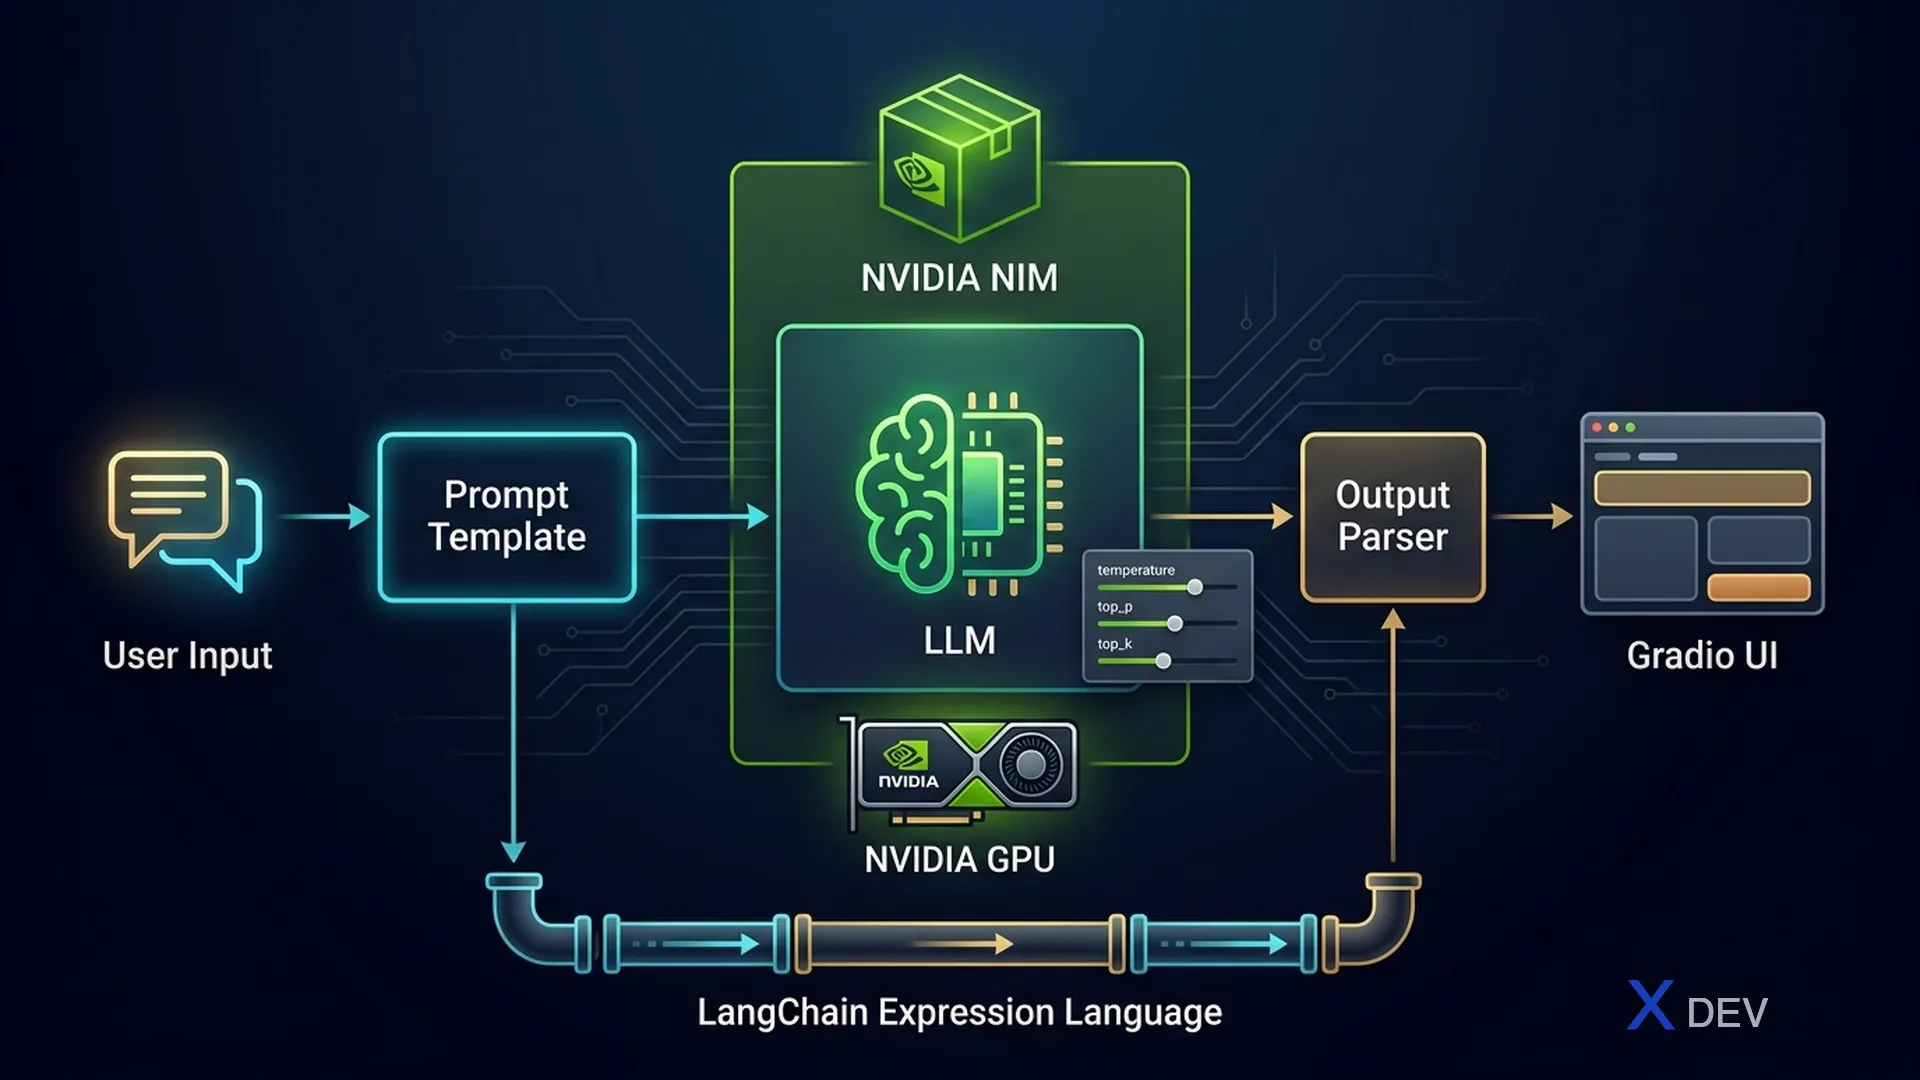
2. LLM推論基礎
2.1. 自迴歸生成
LLM使用自迴歸機制生成文字:每一步模型根據所有先前的token預測下一個token。這個過程不斷重複,直到遇到停止token或達到max_tokens為止。
自迴歸生成流程
═══════════════════════════

輸入: "Hanoi is"
         │
         ▼
┌─────────────────────┐
│   LLM前向傳播         │
│   P(token | context) │
└──────────┬──────────┘
           │
           ▼
┌─────────────────────┐
│   取樣策略            │──► temperature, top-k, top-p
│   選擇下一個token     │
└──────────┬──────────┘
           │
           ▼
    token = "the"
           │
           ▼
輸入: "Hanoi is the"
         │
         ▼
┌─────────────────────┐
│   LLM前向傳播         │
└──────────┬──────────┘
           │
           ▼
    token = "capital"
           │
           ▼
   ... 重複直到 <EOS> 或 max_tokens
2.2. 取樣參數
控制輸出創造性的三個最重要參數:
| 參數 | 範圍 | 效果 | 低值 | 高值 |
|---|---|---|---|---|
| temperature | 0.0 – 2.0 | 調整機率分佈的熵 | 確定性、重複 | 創造性、更隨機 |
| top_k | 1 – vocab_size | 僅限最高機率的前K個token | 更精確、多樣性較低 | 更多選擇 |
| top_p | 0.0 – 1.0 | 核取樣:僅考慮累積機率≤p的token | 僅最確定的token | 考慮更多token |
Token取樣過程(temperature + top-p)
═════════════════════════════════════════════

原始logits:  [2.1, 1.8, 0.5, 0.3, -1.0, -2.5, ...]
                │
                ▼
         ┌──────────────┐
         │  ÷ temperature │  (temp=0.7 → 更尖銳)
         └──────┬───────┘
                │
                ▼
縮放機率: [0.35, 0.28, 0.12, 0.09, 0.08, 0.05, 0.03]
                │
                ▼
         ┌──────────────┐
         │   top-p=0.8   │  cumsum: 0.35→0.63→0.75→0.84 ✓
         │   保留前4個    │  → 丟棄token 5,6,7...
         └──────┬───────┘
                │
                ▼
過濾後:   [0.41, 0.33, 0.14, 0.12]  (重新正規化)
                │
                ▼
         隨機取樣 → token "the"
2.3. 其他參數
| 參數 | 說明 | 使用場景 |
|---|---|---|
| max_tokens | 限制輸出token的最大數量 | 控制成本、延遲 |
| stop | 遇到此字串時停止生成 | 結構化輸出、函數呼叫 |
| repetition_penalty | 懲罰已出現的token(>1.0 = 懲罰更重) | 避免詞彙/句子重複 |
| frequency_penalty | 根據出現頻率降低機率 | 更多樣化的輸出 |
| presence_penalty | 若token已出現至少一次則懲罰 | 鼓勵新主題 |
考試提示: 常見題目:「要始終獲得相同的輸出(確定性),應該設定哪個參數?」→ temperature = 0.0。若問「減少詞彙重複」→ 使用 repetition_penalty > 1.0 或 frequency_penalty > 0。
3. NVIDIA NIM(NVIDIA Inference Microservices)
3.1. 什麼是NIM?
NVIDIA NIM是一組預先最佳化的推論容器,能在NVIDIA GPU上以最高效能部署LLM/多模態模型。NIM內建TensorRT-LLM、量化和記憶體最佳化功能。
主要特點:
- OpenAI相容API — 直接替換,可直接使用openai客戶端呼叫
- TensorRT-LLM後端 — 針對NVIDIA GPU最佳化的核心運算
- 持續批次處理 — 高效同時處理多個請求
- gRPC + REST API — 靈活整合
- 多GPU支援 — 自動張量平行化
3.2. NIM架構
NVIDIA NIM架構
════════════════════════

┌─────────────────────────────────────────────┐
│              NIM容器                          │
│                                              │
│  ┌──────────┐   ┌──────────────────────┐    │
│  │  REST API │   │   gRPC端點            │    │
│  │ :8000     │   │   :8001              │    │
│  └─────┬────┘   └──────────┬───────────┘    │
│        │                    │                │
│        └────────┬───────────┘                │
│                 ▼                             │
│  ┌──────────────────────────────────┐       │
│  │     請求路由 & 批次處理器           │       │
│  │     (持續批次處理)                  │       │
│  └──────────────┬───────────────────┘       │
│                 ▼                             │
│  ┌──────────────────────────────────┐       │
│  │     TensorRT-LLM引擎              │       │
│  │  ┌────────┐ ┌────────────────┐   │       │
│  │  │KV快取   │ │ 分頁注意力機制  │   │       │
│  │  └────────┘ └────────────────┘   │       │
│  └──────────────┬───────────────────┘       │
│                 ▼                             │
│  ┌──────────────────────────────────┐       │
│  │       NVIDIA GPU                  │       │
│  │   A100 / H100 / L40S            │       │
│  └──────────────────────────────────┘       │
└─────────────────────────────────────────────┘
3.3. 拉取與執行NIM容器
# Pull and run NIM container for Llama-3
# Requirements: NVIDIA GPU, Docker + NVIDIA Container Toolkit

# Terminal command:
# docker run -it --rm --gpus all \
#   -p 8000:8000 \
#   -e NGC_API_KEY=$NGC_API_KEY \
#   nvcr.io/nim/meta/llama-3.1-8b-instruct:latest
3.4. 呼叫NIM API
from openai import OpenAI

# NIM與OpenAI API相容——只需更改base_url
client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="not-used"  # 本機NIM不需要金鑰
)

response = client.chat.completions.create(
    model="meta/llama-3.1-8b-instruct",
    messages=[
        {"role": "system", "content": "You are a helpful AI assistant."},
        {"role": "user", "content": "Explain the Transformer architecture"}
    ],
    temperature=0.7,
    top_p=0.9,
    max_tokens=512
)

print(response.choices[0].message.content)
3.5. NIM與原生HuggingFace推論比較
| 標準 | NVIDIA NIM | HuggingFace Transformers |
|---|---|---|
| 後端 | TensorRT-LLM | PyTorch |
| 吞吐量(tokens/s) | ~2500-4000 | ~300-800 |
| 延遲(TTFT) | ~50-100ms | ~200-500ms |
| 批次處理 | 持續批次處理 | 手動 / 靜態 |
| API | OpenAI相容REST | Python API |
| 設置 | 1個docker run命令 | 安裝函式庫 + 撰寫程式碼 |
| 量化 | 內建(FP8、INT4) | 需要額外的GPTQ/AWQ |
| 生產就緒 | 是(監控、擴展) | 需要額外的服務層 |
考試提示: 當考試問「在NVIDIA GPU上部署LLM最快的方式」或「具備TensorRT-LLM最佳化的生產就緒推論」時,NIM永遠是正確答案。NIM ≠ 訓練框架——它僅用於推論。
4. LangChain LCEL管線設計
4.1. 什麼是LCEL?
LangChain Expression Language(LCEL)是一種宣告式語法,用於建構LLM處理管線。它使用|(管道)運算子將元件串接在一起——類似於Unix管道。
LCEL的優勢:
- 串流 — 支援逐token輸出串流
- 非同步 — 原生非同步支援
- 批次處理 — 同時處理多個輸入
- 重試/備援 — 錯誤時自動重試
- 追蹤 — 與LangSmith整合進行除錯
4.2. 核心元件
| 元件 | 角色 | 輸入 → 輸出 |
|---|---|---|
| PromptTemplate | 使用變數格式化提示詞 | dict → PromptValue |
| ChatPromptTemplate | 格式化聊天訊息 | dict → ChatPromptValue |
| ChatModel | 呼叫LLM(ChatOpenAI、ChatNVIDIA...) | PromptValue → AIMessage |
| StrOutputParser | 從AIMessage提取字串 | AIMessage → str |
| JsonOutputParser | 從輸出解析JSON | AIMessage → dict |
| RunnablePassthrough | 不變地傳遞輸入 | any → any |
| RunnableLambda | 將函式包裝為Runnable | any → any |
| RunnableParallel | 平行執行多個鏈 | dict → dict |
4.3. LCEL管線流程
LCEL管線架構
════════════════════════════

簡單鏈:
─────────────
  {"topic": "AI"}
        │
        ▼
┌───────────────┐    ┌─────────────┐    ┌────────────────┐
│ PromptTemplate │──►│  ChatModel   │──►│ StrOutputParser │──► "AI is..."
│ "Explain {topic}"│  │ (ChatNVIDIA) │    │                │
└───────────────┘    └─────────────┘    └────────────────┘

       prompt      |      llm       |      parser
                   LCEL: prompt | llm | parser


平行鏈(RunnableParallel):
───────────────────────────────────
                 {"topic": "AI"}
                       │
              ┌────────┴────────┐
              ▼                 ▼
     ┌──────────────┐  ┌──────────────┐
     │  chain_summary│  │  chain_quiz  │
     │  prompt | llm │  │  prompt | llm│
     └──────┬───────┘  └──────┬───────┘
              │                 │
              └────────┬────────┘
                       ▼
            {"summary": "...", "quiz": "..."}
4.4. 程式碼:LCEL鏈
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
from langchain_nvidia_ai_endpoints import ChatNVIDIA

# 1. 初始化元件
prompt = ChatPromptTemplate.from_messages([
    ("system", "You are a {domain} expert. Answer concisely."),
    ("human", "{question}")
])

llm = ChatNVIDIA(
    model="meta/llama-3.1-8b-instruct",
    temperature=0.3,
    top_p=0.9,
    max_tokens=512
)

parser = StrOutputParser()

# 2. 使用LCEL管道語法建立鏈
chain = prompt | llm | parser

# 3. 同步呼叫
result = chain.invoke({
    "domain": "deep learning",
    "question": "How does Transformer self-attention work?"
})
print(result)

# 4. 串流(逐token)
for chunk in chain.stream({
    "domain": "deep learning",
    "question": "Compare RNN and Transformer"
}):
    print(chunk, end="", flush=True)
4.5. 進階:RunnableParallel與RunnableLambda
from langchain_core.runnables import (
    RunnablePassthrough,
    RunnableParallel,
    RunnableLambda
)

# 將自訂函式包裝為Runnable
def word_count(text: str) -> dict:
    return {"text": text, "word_count": len(text.split())}

# 平行鏈:同時摘要和計算字數
parallel_chain = RunnableParallel(
    summary=prompt | llm | parser,
    metadata=RunnableLambda(
        lambda x: f"Query: {x['question']}"
    )
)

# 帶passthrough的鏈——在管線中保留原始輸入
chain_with_context = (
    RunnablePassthrough.assign(
        answer=prompt | llm | parser
    )
)

# 平行呼叫
result = parallel_chain.invoke({
    "domain": "AI",
    "question": "What is Generative AI?"
})
# result = {"summary": "...", "metadata": "Query: What is Generative AI?"}
考試提示: 當考試給出LCEL程式碼並問「輸出類型是什麼?」時,逐步追蹤:PromptTemplate → PromptValue、ChatModel → AIMessage、StrOutputParser → str。如果忘記parser,輸出將是AIMessage物件(而非字串)。
5. 使用Gradio建構UI與使用LangServe建構API
5.1. Gradio:快速建構聊天機器人UI
Gradio讓你只需幾行程式碼就能為ML模型建立Web UI。gr.ChatInterface元件特別適合聊天機器人。
import gradio as gr
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
from langchain_nvidia_ai_endpoints import ChatNVIDIA

# 設定鏈
prompt = ChatPromptTemplate.from_messages([
    ("system", "You are a friendly AI assistant."),
    ("human", "{message}")
])
llm = ChatNVIDIA(model="meta/llama-3.1-8b-instruct")
chain = prompt | llm | StrOutputParser()

# Gradio處理函式
def respond(message, history):
    """處理聊天訊息——history是[user, bot]配對的列表。"""
    response = chain.invoke({"message": message})
    return response

# 啟動UI
demo = gr.ChatInterface(
    fn=respond,
    title="NVIDIA NIM Chatbot",
    description="Chatbot powered by Llama 3.1 via NIM",
    examples=["What is Generative AI?", "Compare GAN and Diffusion"],
    theme="soft"
)
demo.launch(server_port=7860)
5.2. LangServe:將鏈暴露為REST API
LangServe將任何LCEL鏈轉換為REST API,並自動生成文件(Swagger)。適合生產環境部署。
# === 伺服器 (server.py) ===
from fastapi import FastAPI
from langserve import add_routes
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
from langchain_nvidia_ai_endpoints import ChatNVIDIA

app = FastAPI(title="LLM API")

# 建立鏈
chain = (
    ChatPromptTemplate.from_messages([
        ("system", "AI assistant specializing in {domain}."),
        ("human", "{question}")
    ])
    | ChatNVIDIA(model="meta/llama-3.1-8b-instruct")
    | StrOutputParser()
)

# 在/chat端點暴露鏈
add_routes(app, chain, path="/chat")

# 執行: uvicorn server:app --port 8080
# === 客戶端 (client.py) ===
from langserve import RemoteRunnable

# 連接到LangServe端點
chain = RemoteRunnable("http://localhost:8080/chat")

# 像本地鏈一樣呼叫
result = chain.invoke({
    "domain": "machine learning",
    "question": "What is overfitting?"
})
print(result)

# 串流也能運作
for chunk in chain.stream({
    "domain": "NLP",
    "question": "How does tokenization work?"
}):
    print(chunk, end="")
Gradio + LangServe部署模式
═══════════════════════════════════════

   瀏覽器(使用者)          行動App / 服務
        │                          │
        ▼                          ▼
┌──────────────┐          ┌──────────────┐
│ Gradio UI     │          │ REST客戶端    │
│ :7860         │          │               │
└──────┬───────┘          └──────┬───────┘
       │                         │
       └────────┬────────────────┘
                ▼
      ┌──────────────────┐
      │  LangServe API    │
      │  FastAPI :8080    │
      │  /chat/invoke     │
      │  /chat/stream     │
      └────────┬─────────┘
               ▼
      ┌──────────────────┐
      │  LCEL鏈           │
      │  prompt|llm|parser│
      └────────┬─────────┘
               ▼
      ┌──────────────────┐
      │  NVIDIA NIM       │
      │  :8000            │
      └──────────────────┘
考試提示: Gradio = 原型/展示UI,LangServe = 生產REST API。如果考試問「最快展示聊天機器人的方式」→ Gradio。「為多個客戶端暴露鏈」→ LangServe。兩者可以搭配使用。
6. 對話管理與多輪對話
6.1. 記憶類型
聊天機器人需要記住先前對話輪次的上下文。LangChain提供多種記憶類型:
| 記憶類型 | 運作方式 | 優點 | 缺點 |
|---|---|---|---|
| ConversationBufferMemory | 儲存完整歷史記錄 | 不遺失任何資訊 | Token數量快速增長 |
| ConversationBufferWindowMemory | 保留最近N輪對話 | 控制token使用量 | 遺失較舊的上下文 |
| ConversationSummaryMemory | 使用LLM摘要歷史記錄 | 高效壓縮 | 額外的LLM呼叫成本 |
| ConversationSummaryBufferMemory | 摘要舊的 + 保留近期原始內容 | 兼顧細節與壓縮 | 較為複雜 |
6.2. 訊息類型
LangChain使用型別化訊息來區分角色:
from langchain_core.messages import (
    SystemMessage,
    HumanMessage,
    AIMessage
)

messages = [
    SystemMessage(content="You are an AI assistant."),
    HumanMessage(content="Hello!"),
    AIMessage(content="Hi there! How can I help?"),
    HumanMessage(content="Explain the attention mechanism"),
]
6.3. 程式碼:帶記憶的多輪聊天機器人
from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholder
from langchain_core.output_parsers import StrOutputParser
from langchain_core.chat_history import InMemoryChatMessageHistory
from langchain_core.runnables.history import RunnableWithMessageHistory
from langchain_nvidia_ai_endpoints import ChatNVIDIA

# 1. 帶歷史記錄插槽的提示詞
prompt = ChatPromptTemplate.from_messages([
    ("system", "You are an AI assistant. Answer concisely."),
    MessagesPlaceholder(variable_name="history"),
    ("human", "{input}")
])

llm = ChatNVIDIA(model="meta/llama-3.1-8b-instruct")
chain = prompt | llm | StrOutputParser()

# 2. 會話儲存——每個使用者有自己的歷史記錄
session_store = {}

def get_session_history(session_id: str):
    if session_id not in session_store:
        session_store[session_id] = InMemoryChatMessageHistory()
    return session_store[session_id]

# 3. 用訊息歷史包裝鏈
chain_with_history = RunnableWithMessageHistory(
    chain,
    get_session_history,
    input_messages_key="input",
    history_messages_key="history"
)

# 4. 聊天——相同的session_id保留上下文
config = {"configurable": {"session_id": "user-123"}}

r1 = chain_with_history.invoke(
    {"input": "My name is Minh"},
    config=config
)
print(r1)  # "Hello Minh!..."

r2 = chain_with_history.invoke(
    {"input": "What is my name?"},
    config=config
)
print(r2)  # "Your name is Minh."  ← 記住了上下文!
6.4. 視窗記憶模式
視窗記憶(k=3):僅保留最近3輪對話
═══════════════════════════════════════════════════════

第1輪: 使用者: "Hello"              ─┐
第2輪: AI: "Hi there!"               │ ← 當對話輪數 > 3+k 時被丟棄
第3輪: 使用者: "My name is Minh"     │
第4輪: AI: "Hello Minh!"            ─┘

第5輪: 使用者: "Explain CNN"         ─┐
第6輪: AI: "CNN is..."                │ ← 保留
第7輪: 使用者: "Compare with RNN?"   ─┘

發送的提示詞僅包含: [System] + [第5,6,7輪] + [第8輪輸入]
→ 節省token,但遺失「name is Minh」的上下文
考試提示: 「聊天機器人在幾輪後忘記上下文」→ 使用了太小的BufferWindowMemory或完全沒有記憶。「Token限制超出」→ 改用ConversationSummaryMemory來壓縮歷史記錄。
7. 推論框架比較
| 特性 | NVIDIA NIM | vLLM | TGI(HuggingFace) | Ollama |
|---|---|---|---|---|
| 後端 | TensorRT-LLM | PagedAttention | PyTorch + Flash | llama.cpp |
| 需要GPU | NVIDIA(A100/H100) | NVIDIA | NVIDIA | 否(CPU可用) |
| 吞吐量 | 最高 | 非常高 | 高 | 低 |
| 量化 | FP8、INT4內建 | AWQ、GPTQ | GPTQ、bitsandbytes | GGUF |
| API | OpenAI相容 | OpenAI相容 | 自訂 + Messages | OpenAI相容 |
| 設置 | Docker(NGC) | pip install | Docker | 1個二進位檔 |
| 最適合 | 企業、生產環境 | 研究、高吞吐量 | HF生態系 | 本地開發、筆電 |
| NVIDIA最佳化 | ✅ 最深度 | ✅ 良好 | 部分 | ❌ |
考試提示: NVIDIA DLI考試在所有生產部署問題中偏好NIM。「NVIDIA GPU上的最佳效能」→ NIM。「筆電上快速本地測試」→ Ollama。「開源高吞吐量」→ vLLM。
8. 速查表
| 概念 | 重點 |
|---|---|
| temperature = 0.0 | 確定性輸出(可重現) |
| temperature = 1.0+ | 創造性、更隨機 |
| top_p = 0.1 | 僅選擇最確定的token |
| top_k = 50 | 限制為50個候選token |
| NIM | 預先最佳化容器、TensorRT-LLM、OpenAI API |
| LCEL pipe | prompt | llm | parser |
| RunnableParallel | 同時執行多個鏈 |
| Gradio | 展示UI、gr.ChatInterface |
| LangServe | 從LCEL鏈建立REST API、FastAPI |
| BufferMemory | 儲存完整歷史 → token數量快速增長 |
| SummaryMemory | 使用LLM壓縮歷史 → 節省token |
| WindowMemory(k=N) | 保留最近N輪對話 |
| MessagesPlaceholder | 提示詞中聊天歷史的插槽 |
| RunnableWithMessageHistory | 包裝鏈 + 基於會話的記憶 |
9. 練習題
Q1:建構帶串流的LCEL鏈
撰寫一個LCEL鏈,使用PromptTemplate → ChatNVIDIA → StrOutputParser。提示詞接受一個topic並要求LLM解釋它。加入串流輸出。
顯示答案 Q1
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
from langchain_nvidia_ai_endpoints import ChatNVIDIA

# 建立提示詞模板
prompt = ChatPromptTemplate.from_messages([
    ("system", "You are an AI teacher. Explain clearly and simply."),
    ("human", "Explain in detail: {topic}")
])

# 建立LLM
llm = ChatNVIDIA(
    model="meta/llama-3.1-8b-instruct",
    temperature=0.5,
    max_tokens=1024
)

# 建立解析器
parser = StrOutputParser()

# LCEL鏈
chain = prompt | llm | parser

# 同步呼叫(一次返回完整結果)
result = chain.invoke({"topic": "Diffusion Models"})
print(result)

# 串流(逐token)——使用 .stream() 而非 .invoke()
for chunk in chain.stream({"topic": "Diffusion Models"}):
    print(chunk, end="", flush=True)

# 說明:
# - .invoke() 呼叫鏈並等待完整輸出
# - .stream() 返回迭代器,每個chunk是輸出的一部分
# - StrOutputParser允許串流,因為它直接傳遞字串chunk
# - 如果使用JsonOutputParser,串流將返回部分JSON
Q2:配置NIM並比較Temperature
使用OpenAI客戶端呼叫NIM端點。對同一個提示詞,比較temperature=0.0與temperature=1.0的輸出。每種配置執行3次並觀察差異。
顯示答案 Q2
from openai import OpenAI

# 連接到NIM端點
client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="not-used"
)

prompt_msg = [
    {"role": "system", "content": "Answer concisely in 1-2 sentences."},
    {"role": "user", "content": "Why is the sky blue?"}
]

print("=== Temperature = 0.0(確定性)===")
for i in range(3):
    resp = client.chat.completions.create(
        model="meta/llama-3.1-8b-instruct",
        messages=prompt_msg,
        temperature=0.0,  # 始終選擇最高機率的token
        max_tokens=100
    )
    print(f"第{i+1}次: {resp.choices[0].message.content}")
# → 3次執行產生完全相同的輸出

print("\n=== Temperature = 1.0(創造性)===")
for i in range(3):
    resp = client.chat.completions.create(
        model="meta/llama-3.1-8b-instruct",
        messages=prompt_msg,
        temperature=1.0,  # 更寬的分佈,更隨機
        max_tokens=100
    )
    print(f"第{i+1}次: {resp.choices[0].message.content}")
# → 3次執行產生不同的輸出

# 關鍵要點:
# - temp=0.0:貪婪解碼,可重現,用於事實性任務
# - temp=1.0:更廣泛的取樣,有創造性,用於腦力激盪
# - NIM使用OpenAI相容API,所以客戶端程式碼完全相同
Q3:帶記憶的多輪聊天機器人
建立一個聊天機器人,使用ConversationBufferMemory透過RunnableWithMessageHistory整合到LCEL鏈中。機器人必須記住使用者在先前輪次中提到的名字。
顯示答案 Q3
from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholder
from langchain_core.output_parsers import StrOutputParser
from langchain_core.chat_history import InMemoryChatMessageHistory
from langchain_core.runnables.history import RunnableWithMessageHistory
from langchain_nvidia_ai_endpoints import ChatNVIDIA

# 1. 帶歷史記錄佔位符的提示詞
prompt = ChatPromptTemplate.from_messages([
    ("system", "You are a friendly assistant. Remember information the user shares."),
    MessagesPlaceholder(variable_name="history"),
    ("human", "{input}")
])

# 2. 鏈
llm = ChatNVIDIA(model="meta/llama-3.1-8b-instruct", temperature=0.3)
chain = prompt | llm | StrOutputParser()

# 3. 會話儲存
store = {}
def get_history(session_id: str):
    if session_id not in store:
        store[session_id] = InMemoryChatMessageHistory()
    return store[session_id]

# 4. 用訊息歷史包裝
chatbot = RunnableWithMessageHistory(
    chain,
    get_history,
    input_messages_key="input",
    history_messages_key="history"
)

# 5. 測試多輪對話
cfg = {"configurable": {"session_id": "demo-001"}}

print(chatbot.invoke({"input": "My name is Lan"}, config=cfg))
# → "Hello Lan! Nice to meet you..."

print(chatbot.invoke({"input": "What is my name?"}, config=cfg))
# → "Your name is Lan." ← 機器人記住了上下文!

print(chatbot.invoke({"input": "I like machine learning"}, config=cfg))
# → "That's great, Lan! Machine learning is..."

# 檢查已儲存的歷史記錄
history = store["demo-001"]
for msg in history.messages:
    print(f"{msg.type}: {msg.content[:50]}...")
Q4:Gradio ChatInterface + LangChain
使用gr.ChatInterface建立Gradio UI聊天機器人,後端使用呼叫NIM的LCEL鏈。支援串流回應。
顯示答案 Q4
import gradio as gr
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
from langchain_nvidia_ai_endpoints import ChatNVIDIA

# 1. 設定LCEL鏈
prompt = ChatPromptTemplate.from_messages([
    ("system", "You are an AI assistant specializing in deep learning."),
    ("human", "{message}")
])
llm = ChatNVIDIA(
    model="meta/llama-3.1-8b-instruct",
    temperature=0.7
)
chain = prompt | llm | StrOutputParser()

# 2. Gradio的串流處理函式
def respond_stream(message, history):
    """
    Gradio ChatInterface呼叫此函式。
    - message: 使用者的新訊息
    - history: [user_msg, bot_msg]配對的列表
    每個chunk都yield,讓Gradio即時顯示串流。
    """
    partial = ""
    for chunk in chain.stream({"message": message}):
        partial += chunk
        yield partial  # Gradio在每次yield時更新UI

# 3. 啟動Gradio應用
demo = gr.ChatInterface(
    fn=respond_stream,
    title="🤖 DL Assistant (NIM-powered)",
    description="Ask anything about Deep Learning",
    examples=[
        "How does Transformer work?",
        "Compare CNN and ViT",
        "What is Batch Normalization used for?"
    ],
    theme="soft"
)

demo.launch(server_port=7860, share=False)

# 存取: http://localhost:7860
# Gradio將即時顯示串流回應
Q5:除錯——鏈返回空輸出
以下程式碼可以執行,但輸出總是空的或是意外的物件。找出並修復錯誤。
# BUG: chain returns AIMessage object instead of string
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import JsonOutputParser  # ← Hmm...
from langchain_nvidia_ai_endpoints import ChatNVIDIA

prompt = ChatPromptTemplate.from_messages([
    ("system", "Answer concisely in plain text."),
    ("human", "{question}")
])

llm = ChatNVIDIA(model="meta/llama-3.1-8b-instruct")
chain = prompt | llm | JsonOutputParser()  # ← Bug is here

result = chain.invoke({"question": "What is AI?"})
print(result)  # → Error or empty/weird output
顯示答案 Q5
# 錯誤分析:
# - 提示詞要求LLM以純文字回答
# - 但解析器是JsonOutputParser → 期望JSON格式
# - LLM返回 "AI is artificial intelligence..."(非JSON)
# - JsonOutputParser嘗試解析 → 失敗或返回空輸出

# 修復:將JsonOutputParser替換為StrOutputParser

from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser  # ← 修復!
from langchain_nvidia_ai_endpoints import ChatNVIDIA

prompt = ChatPromptTemplate.from_messages([
    ("system", "Answer concisely in plain text."),
    ("human", "{question}")
])

llm = ChatNVIDIA(model="meta/llama-3.1-8b-instruct")
chain = prompt | llm | StrOutputParser()  # ← StrOutputParser

result = chain.invoke({"question": "What is AI?"})
print(result)  # → "AI (Artificial Intelligence) is..."

# 規則:OutputParser類型必須與輸出格式匹配:
# - 純文字 → StrOutputParser
# - JSON輸出(提示詞必須要求JSON)→ JsonOutputParser
# - 結構化輸出 → PydanticOutputParser
# 如果不匹配 → 鏈會靜默失敗或拋出錯誤