Chuyển đến nội dung chính
Tag

#Ollama

3 noi dung (1 bai viet, 2 series)

Bai viet (1)

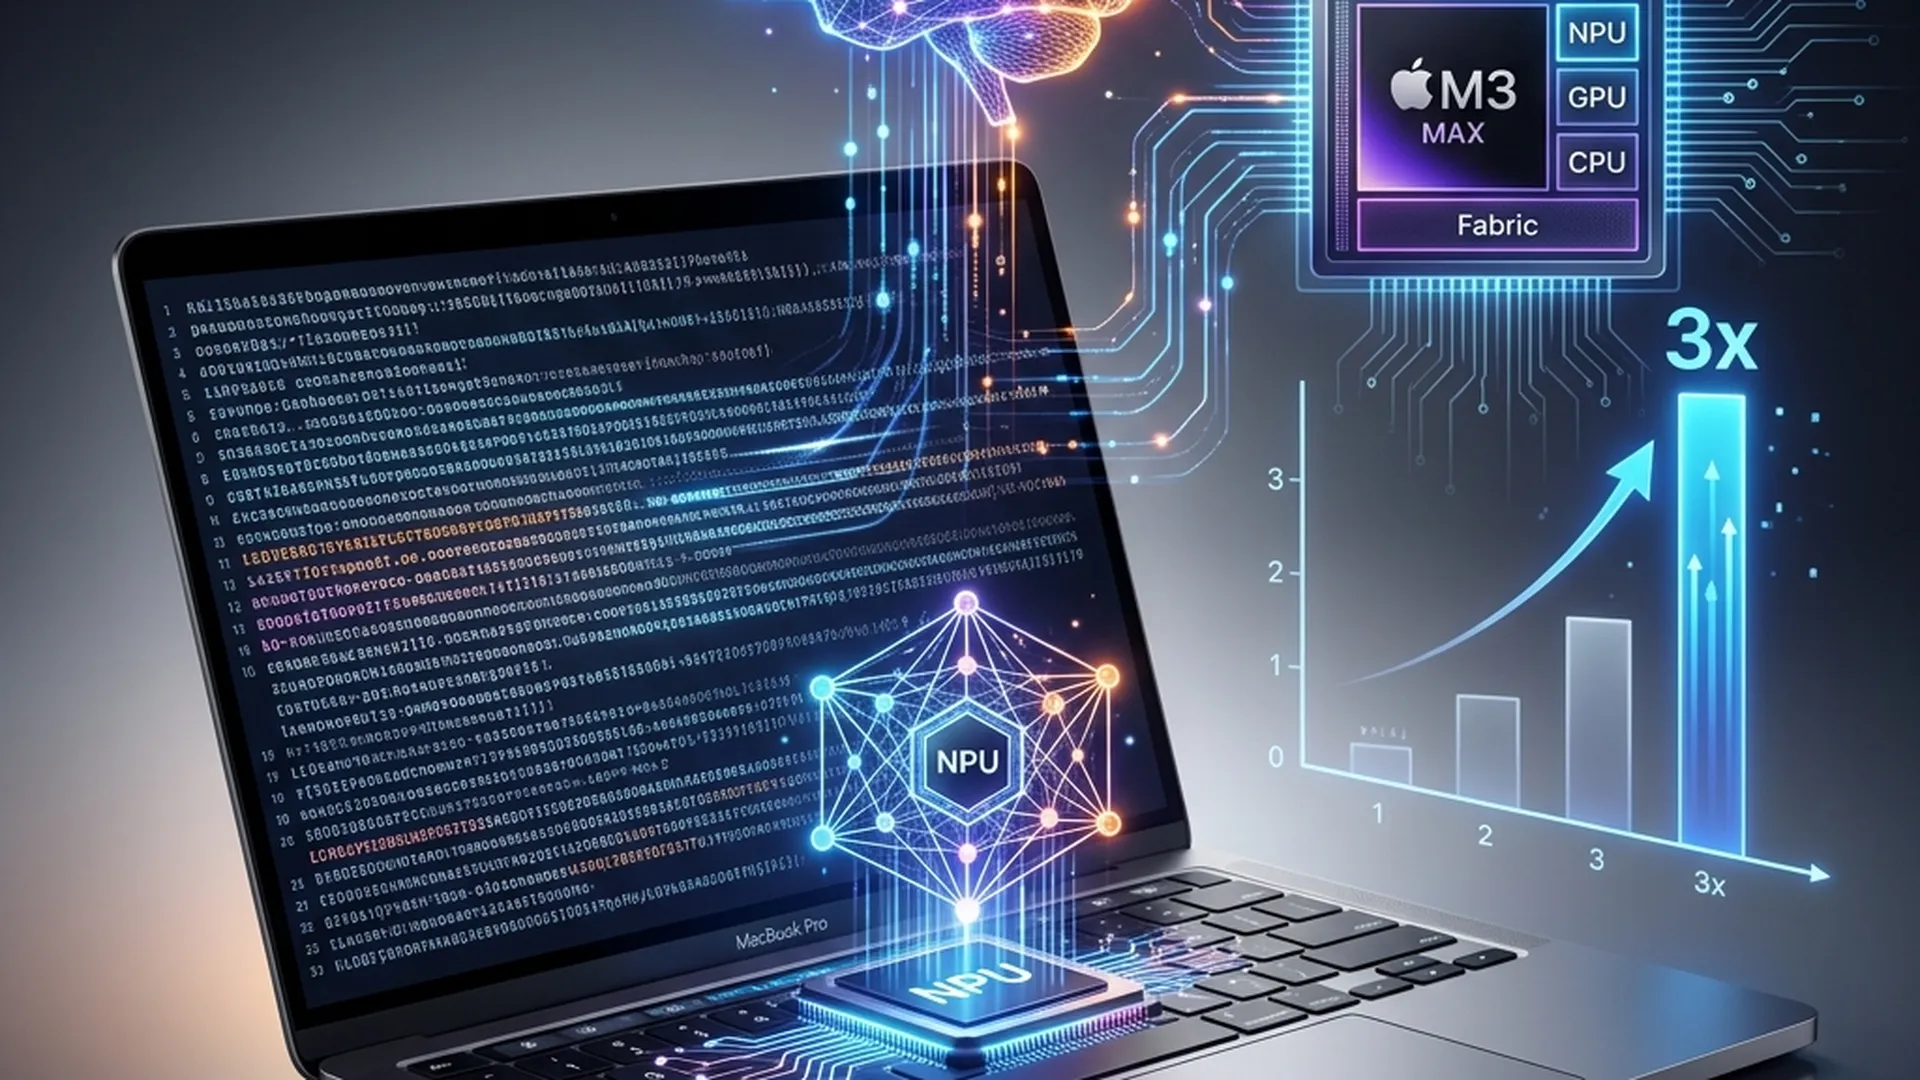
Ollama + MLX: Chạy AI Local trên Mac nhanh hơn 3x với Apple Silicon --- Hướng dẫn đầy đủ 2026
AI

Ollama + MLX: Chạy AI Local trên Mac nhanh hơn 3x với Apple Silicon --- Hướng dẫn đầy đủ 2026

Ollama 0.19 tích hợp MLX backend của Apple --- mang lại tốc độ decode nhanh hơn 93%, prefill nhanh hơn 57% trên M5. Phân tích kỹ thuật toàn diện về unified memory architecture, benchmark thực tế trên M1 đến M5, và hướng dẫn setup từng bước để tận dụng tối đa Apple Silicon của bạn.

Duy TranDuy Tran18 phút

Series (2)

Gemma 4 Local AI Engineering trên Mac
Trung cấp

Gemma 4 Local AI Engineering trên Mac

Series thực chiến xây dựng local AI stack với Gemma 4 trên Apple Silicon theo chuẩn engineering. Từ setup Ollama, API integration, RAG pipeline, hybrid retrieval, đến observability và hardening cho môi trường nội bộ.

8 bài14h
Chạy AI Local với Ollama trên Apple Silicon
Cơ bản

Chạy AI Local với Ollama trên Apple Silicon

Hướng dẫn toàn diện chạy LLM local trên Mac Apple Silicon (M1/M2/M3/M4) với Ollama và MLX. Từ cài đặt ban đầu đến tăng tốc 3x với MLX framework, quản lý nhiều model, tích hợp API vào ứng dụng, và tối ưu hiệu năng GPU/RAM. Tất cả đều hands-on, privacy-first, không cần internet.

12 bài12h